#前沿研究
共 9144 篇相关文章

MuscleMemory:为AI智能体打造的开源程序性记忆
MuscleMemory 是一个为 AI 智能体提供程序性记忆的开源项目,让 Agent 记住「怎么做」而非「是什么」。本文解析其核心思路、技术难点及与现有记忆框架的差异。

Folders 编程语言:用文件目录结构写代码
Folders 编程语言把文件夹的目录层级当作程序结构本身,区别于传统文本代码。本文介绍它的设计思路、在 Hacker News 上引发讨论的原因,以及文件夹编程的潜力与局限。

Meta发布Muse Spark开源权重:816B参数、1M上下文与部署指南
Meta发布Muse Spark开放权重,816B总参数、42B激活、1M上下文。详解模型架构、硬件门槛、基准表现、许可证限制与vLLM部署方案,帮你判断是否值得上手。

Coder与Reviewer代理陷入死循环,步数限制为何失效
Coder与Reviewer代理陷入三天无意义循环,步数限制为何失效?内容指纹检测如何替代步数计数捕获代理死循环,以及键序问题导致检测静默失效的隐患。
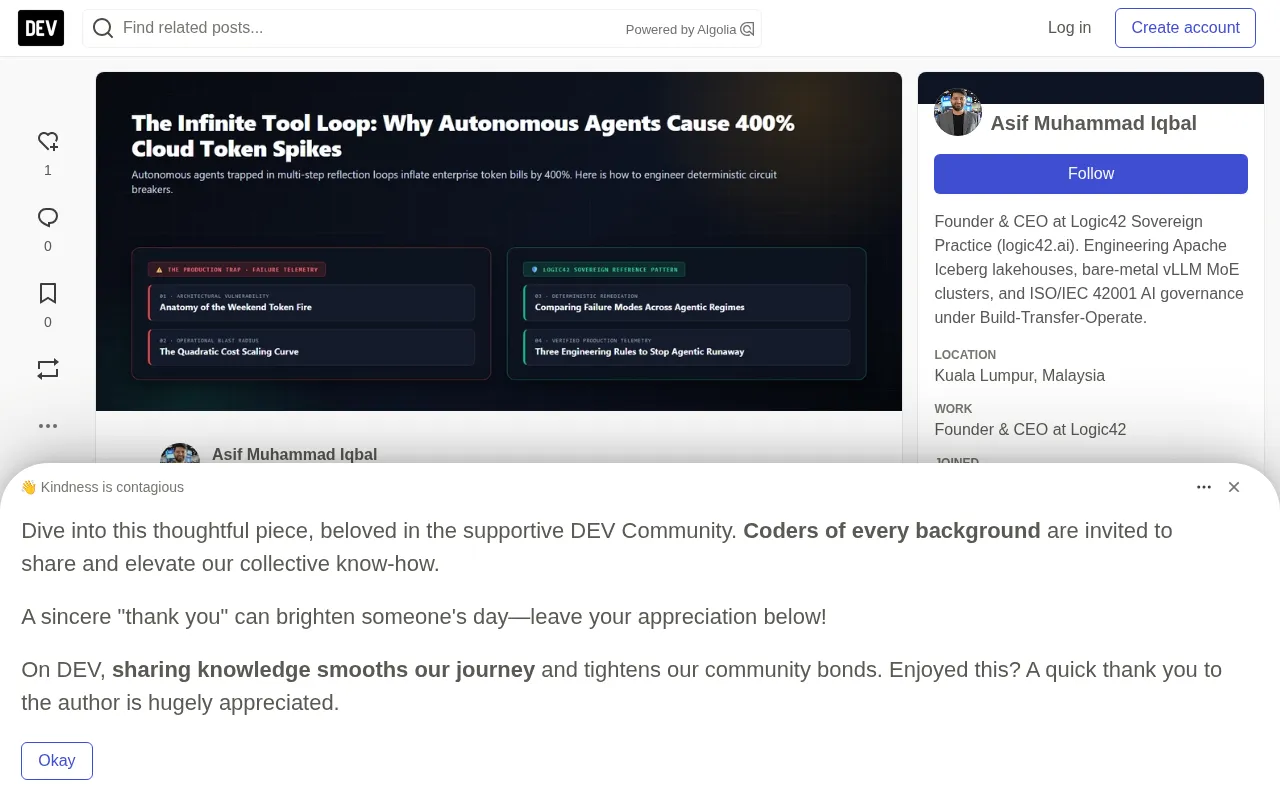
无限工具循环:自主代理为何导致云端Token费用飙升400%
企业自主AI代理的无约束工具调用导致云端Token费用飙升400%。Logic42架构审计显示代理失控占Token浪费的64%,状态机断路器可将失控率从42%降至0%。

有状态Agent记忆陷阱:多智能体上下文膨胀的架构解法
有状态Agent记忆陷阱导致多智能体上下文膨胀至8万Token以上,API成本飙升12倍、延迟激增。Logic42提出三层有界状态架构,实测Token减少95.6%、成本节省97.2%,附审计清单。

AI Agent的Kill Switch:CIO必知的运行时熔断设计
深入解析AI Agent的Kill Switch设计模式:原子性、权威性、可观测性、系统级可逆四大属性,三种失败模式的应对策略,以及让熔断机制真正生效的团队协议。CIO和工程团队必读的AI运营风险控制指南。

超越Vanilla RAG:决策模型如何让边缘SLM达到企业级
Logic42 Lab的324组实验表明,在生成前引入决策模型进行意图路由,可让7B以下边缘小模型达到生产级可用性,云支出削减79.1%,同时解决Vanilla RAG的延迟与召回率困境。

AI代码生成速度悖论:警惕静默规格漂移
AI编程智能体生成代码的速度远超人类验证速度,测试通过和绿色PR往往掩盖了静默的规格漂移。本文拆解AI速度悖论,并给出基于StrictDoc和Tracey的Git原生意图图谱治理方案,把规格漂移变成可检测、可阻断的流水线失败。

什么是 Prompt Fan-out?AI搜索查询扇出机制解析
Prompt Fan-out 是 AI 搜索引擎将单个问题拆解为多个子查询分别检索并整合答案的机制。本文解析其工作原理、对品牌 AI 可见性的影响,以及如何利用它选择追踪提示词、测量声量份额并优化内容策略。

200+智能体实战:Copilot Studio生产部署六步法
交付200+ AI智能体的实战方法:Copilot Studio生产部署六步法,涵盖范围定义、可测试指令、知识库治理、扫描件OCR处理、系统连接与安全ALM,并说明与Azure AI Foundry的选型边界。

腾讯开源Hy-Memory-30B-A3B:专属记忆层模型深度解析
腾讯开源Hy-Memory-30B-A3B记忆专用模型,基于MoE架构,专为会话摘要、上下文压缩和实体识别设计。本文解析其功能定位、与mem0等方案的对比及社区集成实践。

Eiliko间谍玩具案:AI设备隐私架构的三重教训
Eiliko AI间谍玩具案揭示消费级AI设备的隐私架构缺陷:缺乏本地处理、加密不足、数据跨境无授权。本文分析边缘AI如何成为隐私保护的第一道防线,以及安全默认值设计为何是开发者的核心责任。

AI当QA测试员:40个Bug实验揭示提示词设计的意外真相
一个藏有40个Bug的虚拟电商网站实验,用三种提示词让Claude Code扮演QA测试员。结果显示:完整检查清单将Bug检测率从62%提升至76%,但更详细的角色提示反而更差。深入分析AI Agent做QA测试的能力边界与提示词设计启示。

AutoHeal AI:用Gemma与Ollama构建本地自愈运维系统
AutoHeal AI 是一个基于 Gemma 3 和 Ollama 的本地离线IT基础设施监控与自愈系统,结合 Isolation Forest 异常检测、FastAPI 后端和 React 仪表盘,实现故障预测、日志分析和安全自动化恢复。
ERA AI:开源AI新势力的雄心与挑战
ERA AI是一个开源AI倡议,旨在让AI技术惠及所有人,短期聚焦开发者工具,长期探索通用人工智能与超级智能。本文分析其愿景、开源路线与面临的现实挑战。

GuardAgent-OS:用类型安全 Python 架构守护自主代理安全
GuardAgent-OS 是一个用 Python 实现的零信任代理安全编排框架,通过加密约束的 NHI、确定性预执行拦截和出站 DLP,应对自主代理的提示注入与数据外泄风险,校验开销低于 5ms,开源可查。

AI评委在给运气打分:结果偏差让评分失真
AI评委在评分时存在结果偏差:当决策结果变差时,即使决策过程完全相同,模型也会给出更低评分。本文介绍一个检测探针,在虚构和真实Agent日志上测试多个Claude模型,发现所有模型至少在一个案例上泄露,且修复方案在真实运行上失效。

