#前沿研究
共 9121 篇相关文章

Agent基准测试的"用户"是第二个模型,24.4%的成功运行违反了用户脚本
UserProxyBench论文揭示交互式Agent基准测试中模拟用户代理的失败模式:24.4%的成功运行违反了用户规范,更换用户代理导致15.2分奖励波动。用户保真度分数比奖励分数更能追踪交互质量。
Agenthof 开源治理引擎:给 AI Agent 戴上权限紧箍咒
Agenthof 是一个 Apache-2.0 开源 AI Agent 治理引擎,通过"门"机制授权每次调用、注入凭据并写入防篡改账本,回答谁授权、用了谁的密钥、有没有被拒绝。

Gemini 4 Argon全球开放:百万级Token上下文窗口
Google Gemini 4 Argon已全球开放,支持100万Token上下文窗口,定价为每百万输入Token 2美元、输出10美元。本文分析其功能定位、发布节奏、定价逻辑及企业落地注意事项。

多模态AI生产落地:Demo之外的真相
多模态AI在生产环境中的真实挑战:40-60%文档需预处理,p95延迟放大3倍,音频视频带来合规冰山。本文拆解演示与生产之间的流水线差距,给出失败博物馆、人工队列与延迟预算等落地建议。
453位科学家联名:AI模型应立即断网隔离
453位科学家联名发表公开信,要求AI实验室将具备网络攻击能力的模型断开互联网。Hinton、Bengio等重量级学者签名,Anthropic CEO Amodei也认同风险。本文深度解析公开信诉求、触发事件、正反方论点,以及组织可立即实施的五项安全控制。
26起加密裁员9起归因AI,仅5家是公司自己说的
Northpoint报告统计26起加密裁员中9起被归因AI,仅5家是公司自己说的,另4起为媒体叙事。资深Coinbase营销人流向OpenAI和Anthropic,报告刻意不统计招聘数量。

Ricursive Intelligence:用AI设计芯片破解算力危机
Ricursive Intelligence正在开发能自主设计芯片的AI系统,通过每次迭代学习并优化后续设计,目标是自动化和加速芯片研发流程,缓解AI算力危机。
Disrupt 2026创业战场决赛:五家AI初创公司盘点
TechCrunch Disrupt 2026创业战场决赛五强名单揭晓,五家AI初创公司覆盖企业代理、法律文书、供应链、医疗影像和开发者工具赛道,本文分析入围项目的共同特征与评选逻辑变化。

用LangGraph打造开源AI对冲基金引擎:7人投研团队与TimesFM预测
Reddit开发者开源Lumina Capital:基于LangGraph的七角色投研委员会、Qlib Alpha158量化因子库、Google TimesFM概率预测与10秒ATR哨兵止损,探索LLM与确定性量化计算分离的多智能体对冲基金架构。

Reddit用户求问「Autoconocimiento」:自我认知到底是什么
Reddit用户发帖询问Autoconocimiento(自我认知)的含义。本文拆解自我认知的四个层次、它与内省的区别,以及为什么外部反馈对认识自己不可替代。

OpenTWBench:台湾知识评测基准揭示评分体系如何左右模型得分
OpenTWBench 发布台湾知识评测基准,包含 tw-exam-bench 与 tw-formosa-bench。研究揭示答案抽取方式可使准确率从20.8%跃至93.9%,系统提示占位符可重排榜单,量化评测装置对模型得分的影响。

EGCForest:为企业群聊打造结构化Agent记忆框架
EGCForest提出三森林架构,将企业群聊的不可变消息日志组织为频道、角色、产出物三个维度,通过跨视图链接联合检索,在三个企业群聊基准上相对MemOS答案准确率最高提升20.85分。

MAPLE:多轴参数化知识提取评估框架解析
MAPLE是一个用于评估LLM知识提取增强技术的多轴参数化框架,通过表面、概率和超越采样三个层级的诊断指标,揭示激活引导、解码调整和提示工程等KEE技术的真实效果与权衡。
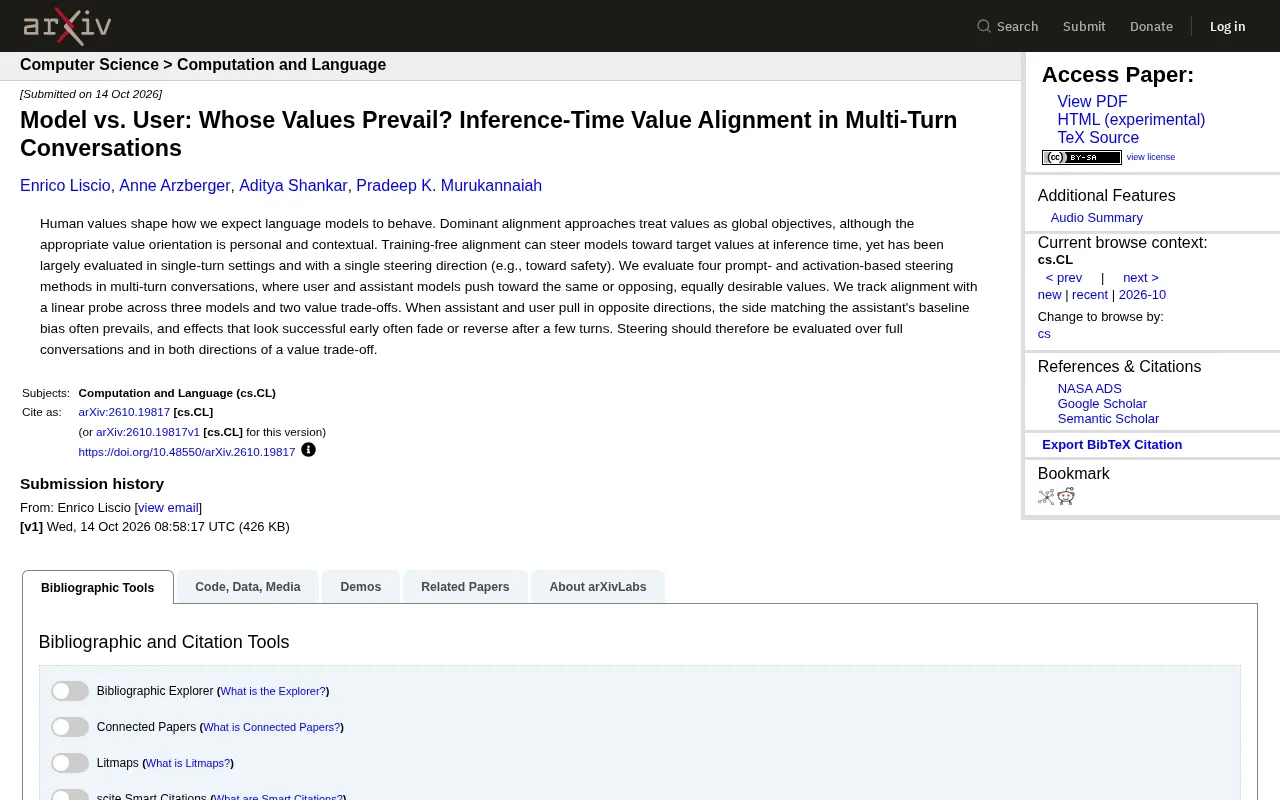
多轮对话中,谁的价值取向会胜出?推理时对齐新研究
新研究把推理时对齐评测从单轮扩展到多轮对话,发现当用户与助手价值观相反时,符合模型基线偏好的一方常占上风,且早期有效果的引导会在几轮后衰减或反转。

别把朋友的数据喂给AI助手:隐私边界正在崩塌
AI个人助手正在采集你周围所有人的数据,而他们从未同意。本文分析Meta Muse等产品引发的隐私边界问题,探讨知情同意框架为何在AI时代失效,以及技术社区提出的解决思路。
四大AI实验室请求国会批准“合谋”:主权AI的回应
四大AI实验室请求国会批准反垄断豁免以“协调减速”,引发两党反对。本文分析这一“合谋”请求的本质,以及主权AI、开放权重模型如何成为制衡集中化权力的建设性回应。

别用第一张图判断Nano Banana 2.1的角色一致性
Nano Banana 2.1的角色一致性不该用第一张图来判断。本文从多轮生成、参考图管理、风格控制三个角度,分析如何测试AI角色在多张图之间是否真正保持一致。

推理模型的真相:不是更聪明,只是更慢更贵
推理模型不是更聪明,只是更慢更贵。一线工程团队实测显示:延迟是快速模型的3-10倍,成本最高差30倍,仅约15%的企业提示词真正受益。本文提供推理模型与快速模型的路由指南,涵盖升级策略、成本对照表和延迟预算方法。",

