#前沿研究
共 8867 篇相关文章
AI生成只需3分钟,为什么工作流仍耗时18分钟?
AI生成草稿只需3分钟,但工作流总耗时仍有18分钟。本文拆解AI自动化的测量陷阱:为什么局部提速不等于全局提效,以及如何正确计算工作流ROI。

OpenAI工程师因办公室非法录音被捕:AI破案与AI作案的双重叙事
OpenAI一名工程师因在办公室会议室暗藏录音设备被解雇并逮捕,嫌疑人涉嫌用聊天机器人学习作案手法,OpenAI则用自家AI模型锁定嫌疑人,案件揭示了AI工具被滥用于内部犯罪的现实风险。
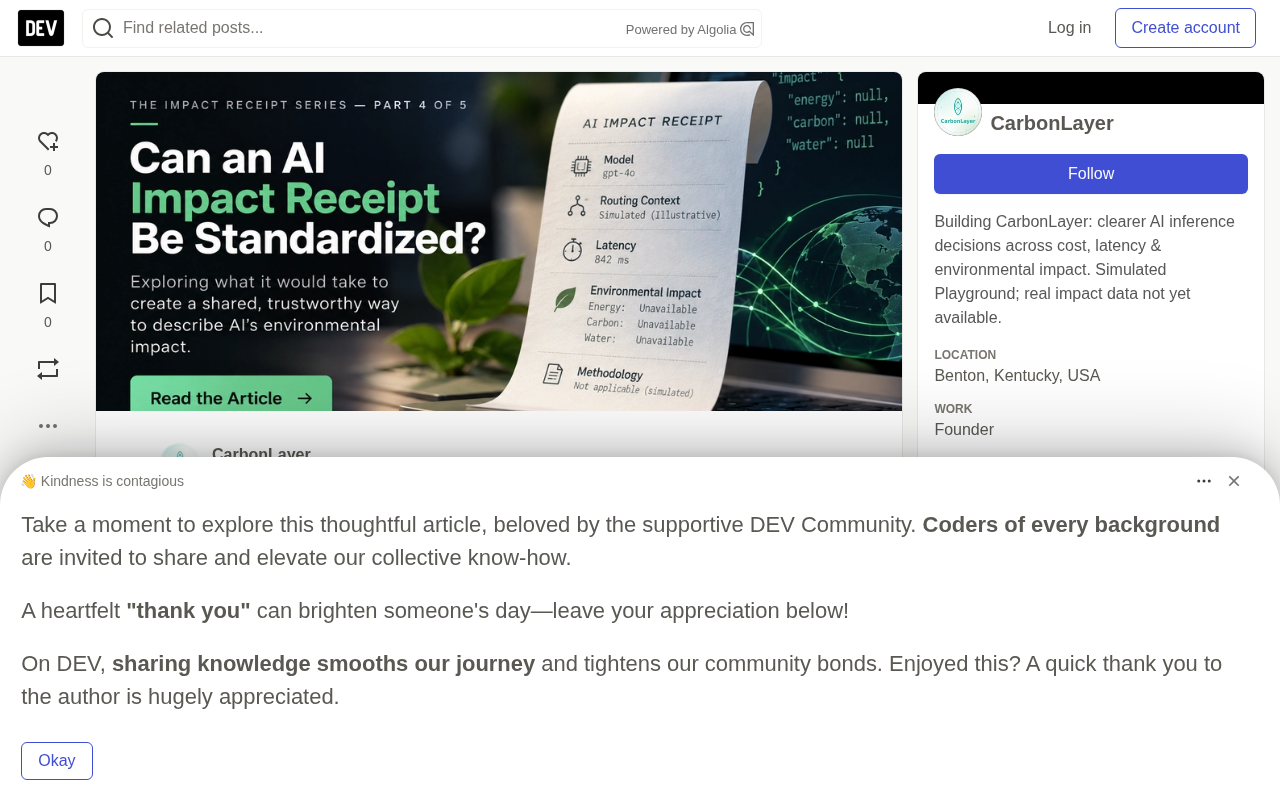
AI影响凭证能否标准化?CarbonLayer的开放思考
CarbonLayer探讨AI影响凭证标准化难题:如何在不标准化误导性假设的前提下,让不同AI系统的环境影响数据可互操作。核心观点包括区分证据状态与数值、方法论版本管理、以及'不可用'作为一等公民字段的设计理念。
GenieX:用Rust在骁龙芯片本地跑大模型
高通开源 GenieX:基于 Rust 的推理运行时,可在骁龙 NPU/GPU/CPU 上本地运行 Llama 3、Mistral 及多模态 VLM,支持 INT4/INT8 量化与异构调度,适用于 X Elite 笔记本和骁龙 8 系手机。

结构化思维链SCOPE:用可执行计算图重塑大模型推理
结构化思维链(SCOPE)框架让大模型生成可执行计算图替代自由文本推理,通过图强化学习训练,实验显示准确率提升且生成长度减少5-6倍,模型更依赖计算图推导答案而非事后合理化。

神经符号推理检测网络争论说服力:NARS框架解读
解读NARS神经符号论证推理系统:用检索增强LLM抽取双极论证结构,结合渐进论证语义检测ChangeMyView讨论中的说服力,F1达0.57超越零样本大模型,并公开CMV2BAS数据集。
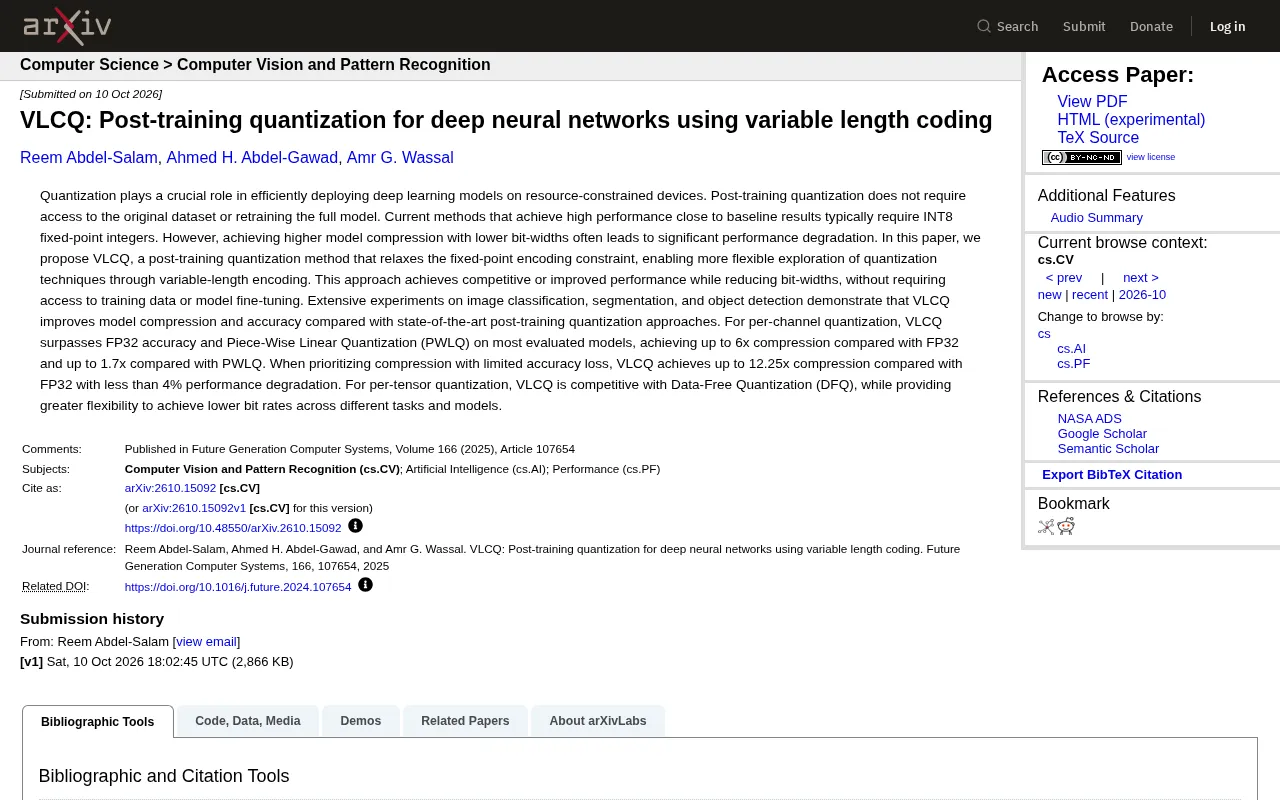
VLCQ:变长编码如何突破INT8量化瓶颈
VLCQ提出用变长编码替代定点量化约束,在无需训练数据和模型微调的前提下,实现最高12.25倍压缩率,性能下降控制在4%以内,为深度学习模型边缘部署提供新思路。

无需标注数据:Marvo用边际奖励实现视觉Agent自进化
Marvo提出一种自进化视觉Agent训练方法,通过双Agent架构和边际奖励,从无标注图像中学习工具调用,跨领域平均准确率提升最多7.1%,无需人工标注问答数据。

GAMW:生成感知的梅尔域水印,为TTS音频溯源提供新思路
GAMW提出生成感知的梅尔域音频水印方案,在TTS合成过程中嵌入水印而非事后添加,16比特载荷下复合扰动解码准确率比基线高23.5个百分点,已开源。

简单离散世界间的知识迁移:深度递归模型的泛化能力研究
一项新研究通过数独式离散世界,系统探究深度递归模型在规则重新组合与全新规则下的知识迁移能力,发现符号描述与示例在不同新颖程度下各有优劣。

5G用户面暴露AI推理:IoD让网络原生支持拆分推理
研究提出Inference on Demand(IoD),通过CAMARA式API和带内张量上下文,把拆分推理暴露为5G用户面上的网络服务,在可编程UPF测试台上验证自适应拆分可避免静态配置的僵化成本。

15美元订阅Humble Choice:畅玩《Psychonauts 2》与《如龙》新作
Humble Choice本月订阅仅需15美元,即可获得《如龙》新作《Like A Dragon: Pirate Yakuza in Hawaii》、《Psychonauts 2》、《波斯王子:失落的王冠》等多款Steam游戏,性价比分析及购买建议。

Starlink突限乌克兰军事服务:马斯克与泽连斯基裂痕波及战场通信
乌克兰官员指控Starlink在未预警情况下限制军事服务,干扰无人机作战,事件发生在马斯克公开批评泽连斯基数日后,引发商业卫星战时角色的广泛争议。
TechCrunch Disrupt 2026 门票半价:AI 创业者不可错过的旧金山大会
TechCrunch Disrupt 2026 最后两天门票五折,10 月旧金山 Moscone West 举行。大会聚焦物理 AI 与软件 AI,本文解析折扣细节、主题定位与参会价值。

Gemini 4 Argon正式发布:百万Token输出与Vals Index登顶
Google DeepMind 正式发布 Gemini 4 Argon,Vals Index 登顶第一,支持百万 Token 输出解码,并原生集成 Antigravity 代理开发环境。本文解析其技术规格、基准测试与企业定价策略。

读者拆解我的基准测试:数据修正与开源工具Receipts的反思
一项181个真实代码变更的研究被读者发现错误:10%的智能体PR中唯一弱测试比例被修正,拆分后显示81.8%的弱测试出现在无证明测试时。开源工具Receipts随之改进,作者反思基准测试中判定规则与代码事实的边界。

26个模型实测:百万Token长上下文,Claude与Gemini谁更强?
ATLAS研究评估26个AI模型在8K-1M Token下的长上下文能力,发现Gemini 3.1 Pro在128K领先,Claude Opus 4.6在1M反超。CorpusQA研究进一步揭示传统RAG在全局分析任务上准确率仅17.38%,远低于Memory Agent的44.95%。

AI推理突破:DeepSeek-R1与OpenAI的逻辑跃迁
大语言模型正从概率预测转向结构化推理。本文解析OpenAI思维链方法与DeepSeek-R1的强化学习机制,探讨推理能力如何重塑LLM角色定位,以及开源与多模态对推理普及的推动。