#前沿研究
共 8867 篇相关文章

上下文窗口越大越好?模型中间信息丢失的真相
大模型上下文窗口越大越好吗?Lost in the Middle论文揭示:关键信息放在上下文中间时,模型准确率反而下降。本文解析这一现象的成因,并给出检索排序、提示词构造的实用优化策略。
跳票近十年:特斯拉Roadster终于要量产了?
特斯拉Roadster从2017年亮相至今跳票近十年,一度被视为"雾件"。本文分析其延迟原因、量产前景以及对特斯拉品牌的意义。

Google垃圾更新结束后的SEO排查清单与AI内容应对策略
Google九月垃圾更新历时14天结束,10月1日有用内容指南同步刷新。本文整理更新后排查清单,涵盖AI Overviews对点击率的影响、AI辅助内容核查要点,以及SEO从业者当下该做与不该做的事。

Windows Junction 让 AI 代理越界删除 48218 个文件
一份事故报告描述 Claude Code 代理因 Windows 目录联接(junction)越界,103 秒内删除 48218 个活跃项目文件。本文拆解 junction 机制、os.walk 陷阱、worktree 共享对象库风险及实际防护措施。

Opus 5.5规划、Haiku 5.5执行:100K Token处40倍价差崩塌
Claude Haiku 5.5在Terminal-Bench 4.0从0.0%跃升至39.2%,让“Opus规划、Haiku执行”的分层架构首次可行。但Haiku 5.5按提示长度计费,超过10万token后费率翻五倍并适用于整个请求,宣传的40倍价差实际缩至8倍。

QuEra用AI自动锁定激光,为量子计算机稳定性破局
QuEra利用AI实现量子计算机激光自动锁定,取代人工校准。本文解析AI激光锁定技术原理、中性原子架构挑战,以及AI在量子硬件控制中的行业趋势。

让AI运营创业公司一周:实测结果与思考
一位创始人将创业公司运营交给AI一周,实测客户沟通、任务分配和内容生成效果,揭示AI在决策直觉、责任归属和模糊指令处理上的关键短板。

四只手同框:手部追踪器到底在跟谁?
Reddit 讨论四手同框时手部追踪器的身份归属难题,介绍 MEgoVista 如何先用检测器区分相机佩戴者与他人的手,再跨帧追踪,并探讨演示数据中追踪器切换目标时的处理方式。

35GB量化模型为何撑爆80GB GPU?KV Cache显存真相
为什么35GB的4-bit量化LLM仍会撑爆80GB显卡?本文拆解推理显存的四大组成,给出KV Cache精确计算公式,对比GQA与DeepSeek MLA的显存差异,并提供FP8 KV Cache等生产级防OOM方案。
中国发布"求索"4.0:首个覆盖AI全产业链评测基准
中国电子技术标准化研究院发布"求索"4.0,首个覆盖AI全产业链的评测基准体系,涵盖算力、大模型、Agent、安全治理与行业应用,16个评测工具,开源代码工具,解决跨环境评测结果不可比的行业痛点。

OjasX 0.6.1:6.35GB内存训练10亿参数大模型
OjasX v0.6.1开源项目实现6.35GB内存训练1.04B参数大模型,通过消除激活磁带和反向重计算,支持CUDA、ROCm、Metal等多平台,让消费级硬件也能训练大语言模型。
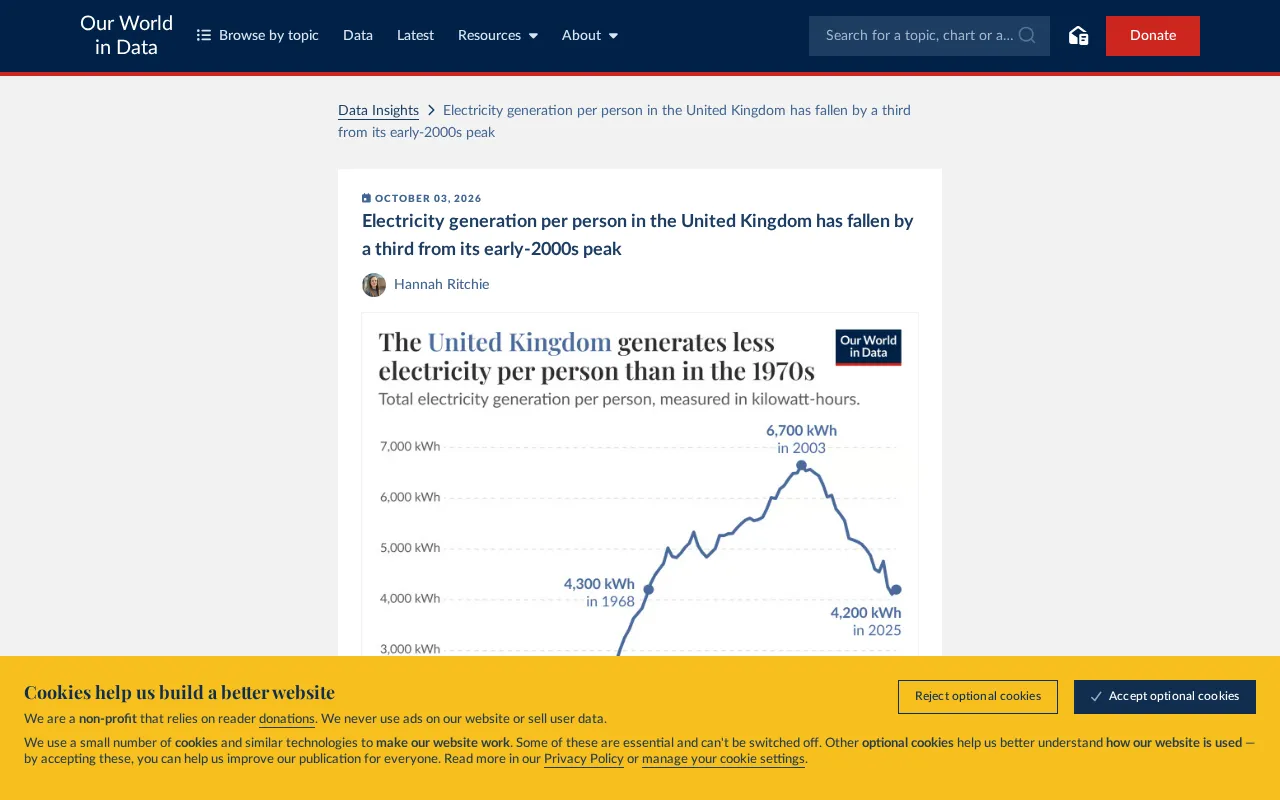
英国人均发电量竟低于1970年代:能源结构巨变的深层信号
英国人均发电量已低于1970年代水平。本文分析去工业化、能效提升与能源结构转型三重因素如何共同压低人均电力消耗,以及这对未来电气化趋势意味着什么。

Ai2 Olmo-core 3:MoE训练吞吐量提升2.7倍的秘诀
Ai2 开源 Olmo-core 3 训练框架,用 DDP 替代 FSDP 消除 MoE 训练的容量税。专家池从 8 扩到 128 吞吐量仅降 5%,47B 模型吞吐量达旧实现 2.7 倍。

微调通常是过早的:先穷尽评估、提示与检索三层
微调通常是过早的:多数团队缺的是评估、提示词和检索,而不是权重。本文给出诊断缺口、黄金评估集、有效顺序与决策清单,帮你判断何时才该微调。
Git 成了瓶颈?Anthropic 自研 Scion 为 AI 智能体重构版本控制
Anthropic 合并量四个月增长 12 倍,Git 成为瓶颈。他们自研了 Scion 版本控制系统:服务端权威、API 优先、增量提交,基础设施缩小 200 倍。本文拆解其设计、数据与争议。

AIoT赋能汽车智造:从传感器数据到更优决策
AIoT 如何改造汽车制造工厂:解析传感器、连接、AI 模型与运营系统的四层架构,覆盖预测性维护、计算机视觉质检、边缘与云计算取舍、既有系统集成难点,并给出可落地的 AIoT 试点路线图。

AI Agent评测:LFORLA JS 3D Builder排行榜如何给模型打分
LFORLA的JS 3D Builder基准用服务端静态分析给AI Agent打分:模型需从书面规格规划并组装Three.js建筑,不执行代码、不用LLM裁判。GLM 5.2得78.0,Nemotron 3 Ultra得71.47。

AI搜索优化实战:让AI引擎读懂你的业务专长
面向开发者的AI搜索优化实战指南:如何通过页面结构、结构化数据和内容策略,让定制软件、工作流自动化和AI仪表盘服务在AI生成式回答中获得引用和可见性。