#前沿研究
共 8622 篇相关文章

技术架构师角色转型:从画图到AI智能体治理
技术架构师角色正从绘制架构图转向AI智能体治理。本文解析现代架构师在提示工程监督、工具访问治理、输出验证、监控可观测性和伦理安全方面的核心职责,以及SAP场景下的智能体蔓延防范与12个月技能规划。

三次运行不是样本量:AI评测里的重复次数误区与可计算法则
AI 评测里"跑三次"几乎成了默认规则,但没人算过它买到多少误差控制。本文介绍一条精确可计算的重复次数法则:全票一致会越加越糟,平均分数是另一套数学体制,题目规模再大也救不了单次运行约等于抛硬币的判定。含 N* 与 p* 交点、方差比的预算分配,以及可复现脚本。

SeaArt vs PixAI:2026年动漫AI生成器实测对比
SeaArt vs PixAI深度实测对比:从动漫角色生成、复杂场景提示词遵循到角色一致性和后期编辑,解析两个平台在免费额度、生成速度和工作流上的真实差异,帮助动漫创作者做出选择。

推理深度、延迟与成本:基于升级路由的设计指南
升级式模型路由如何平衡推理深度、延迟与成本:三层架构、推理预算引擎、六组件职责划分,以及两条关键架构决策记录,帮助团队避免单一模型策略的延迟与成本失控。

多模态索引可还原原始图像:向量数据库的隐私盲区
最新研究显示,多模态视觉文档检索系统的补丁向量索引可被反演还原原始图像,ViDoRe v3 上文字召回率达 47%、来源识别率 98.4%。打乱向量顺序的防御可被模型逆转,索引需按机密数据加密存储并纳入反演测试。

专用数据集让16B世界模型突破物体恒存推理纪录
16B参数世界模型PWM-WROP借助150万样本的专用物体恒存数据集,在延续式视频模型中排名第一,总排名第三,LPIPS和MS-SSIM等图像质量指标也全面领先。

视觉Token压缩64倍:Braco如何保留95%精度
Braco论文提出四步编码器,将视觉token从576压缩至9个(64倍缩减),保留约95%模型精度,prefill FLOPs减少86%,端到端提速约30%,为多模态推理建立新的效率基线。

嵌入从原理讲起:小猫如何找猫,还跨语言找到Gato
从第一性原理讲清嵌入模型:文本如何变成向量,余弦相似度如何衡量语义距离,多语言 RAG 为何会因选错模型而静默失败,附二十行可运行代码与踩坑清单。
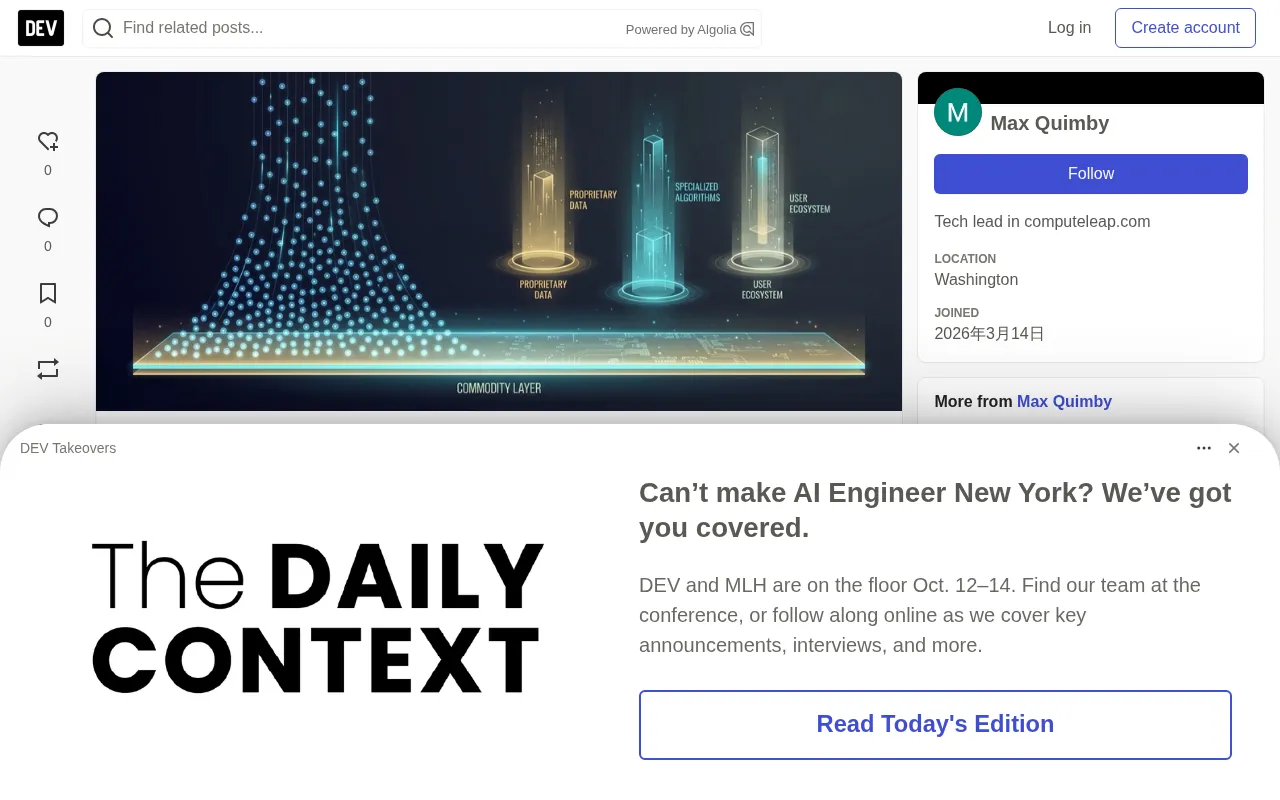
最佳模型之争已终结:2026年AI真正的护城河在哪里
Polymarket数据显示最佳AI模型竞赛已成抛硬币游戏,Google与Anthropic以42比42平局,Meta Muse Wonder以低价入局。本文深度分析2026年AI真正护城河:智能体框架、专有数据飞轮与分发网络效应。

印度团队发布ZY-S1 Preview:1.18B HRM-Text模型微调实战
印度ZYR AI发布ZY-S1 Preview,基于Sapient AI的HRM-Text-1B微调的1.18B参数模型,ARC-Challenge和MMLU均有提升,但数学推理能力出现退化。

农业:被忽视的自我复制纳米技术
一条推文将农业类比为物理世界中的自我复制、递归自我改进的纳米技术,且完全开源。本文分析这一视角如何重新定义农业的技术属性,并探讨其对合成生物学和自复制系统研究的启示。

AI自动研究突破:整数乘法首次低于n log n
Auto Research 声称实现低于 n log n 的整数乘法算法,在 Hacker News 引发讨论。本文解析 n log n 复杂度边界的意义、结论的严谨性问题,以及 AI 自动研究对算法发现和科研范式的潜在影响。

EmbeddingGemma 2 在 Cloud Run 上:int8 CPU 与 NVIDIA L4 对决
在 Google Cloud Run 上部署 EmbeddingGemma 2 文本嵌入模型,对比 int8 量化 CPU 服务与 NVIDIA L4 GPU 的延迟、吞吐、SciFact 检索精度及每百万文档成本,找出 3.4% 忙碌比例的盈亏平衡点。

生成式AI新纪元:主流云平台全面集成大模型
AWS、Google Cloud、Azure 三大云平台同步推进生成式AI布局:Amazon Bedrock 正式GA,Vertex AI 扩展LLM与扩散模型,Azure OpenAI Service 强化安全与可扩展性,NVIDIA AI Enterprise 提供算力底座,开发者接入门槛快速下降。

Geopatriation与科技主权:印度AI工程师的地缘回归思考
印度AI工程师Adithya Kuppusamy提出Geopatriation概念,探讨技术人才与数字资产从全球化中心向本土回流的趋势,分析科技主权、数据本地化与AI供应链地缘风险。
AI研究文件夹的困境:多模型会诊如何让AI分歧真正交锋
多模型对比研究的核心困境在于独立答案从未交锋。本文介绍AI多方语音讨论模式,让不同模型的观点在同一个房间中辩论、碰撞,帮助你在二十分钟内做出决策,而非积攒一堆永远不会重读的论文。

Chrome静默装AI模型、AWS警告初级岗危机与AI代理伦理争议
Chrome 未经同意静默安装 4GB AI 模型,AWS CEO 批评用 AI 替换初级员工是最蠢决定,AI 代理发布攻击创建者内容引发伦理争议,Hacker News 禁止 AI 生成评论。
抵御模型蒸馏攻击:AI安全防御策略解析
解析模型蒸馏攻击的原理与防御策略,涵盖输出水印、查询异常检测、输出信息限制等防护手段,探讨AI模型能力保护与API开放服务之间的攻防博弈。

