#前沿研究
共 6414 篇相关文章
 深度解读
Qwen3.7 Max深度解读:1T参数MOE架构如何打造智能体全能底座
深度解析阿里Qwen3.7 Max模型:1T参数规模、MOE架构、256K上下文,在智能体编程、高难度推理、多语言等四大维度全面领先,兼容LangChain、CrewAI等主流框架,重新定义智能体底座标准。
 教程攻略
吴恩达新课解读:Agent记忆工程从入门到实战
深度解读吴恩达联合Oracle推出的Agent Memory课程,系统讲解记忆工程核心概念、记忆优先架构设计、记忆管理器构建及矛盾处理,帮助开发者构建具备持久化记忆能力的AI智能体。
 前沿研究
AI首次攻克Erdős猜想:数学未解难题的历史性突破
AI首次独立解决数学界著名未解难题——Erdős猜想,在组合几何领域实现历史性突破。本文解析AI如何在人类无法执行的复杂证明中找到解答路径,以及这一成果对数学和科学发现的深远影响。
 深度解读
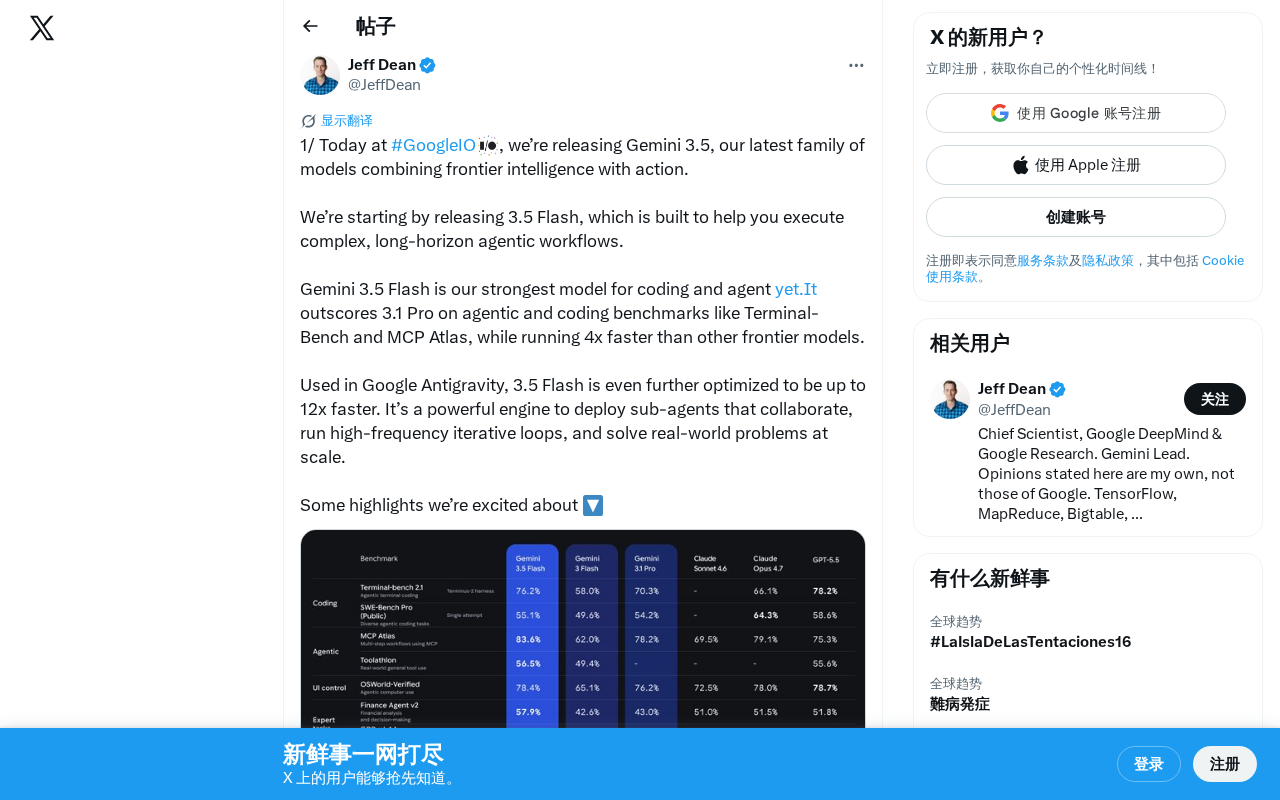
Gemini 3.5 Flash深度解析:Google打造的AI Agent执行引擎
Google I/O 2025发布Gemini 3.5 Flash,速度比前沿模型快4倍,编码与Agent基准超越自家旗舰。本文深度解析其子Agent协作、高频迭代循环等核心能力,以及对AI Agent行业格局的影响。
 科技前沿
Google I/O 2025全面回顾:Gemini如何成为AI战略核心
Google I/O 2025大会上Gemini成为绝对主角,从搜索到开发者生态全面渗透。深度解析Gemini团队阵容、产品整合策略及对AI行业竞争格局的影响,了解Google如何全力押注Gemini反击OpenAI和Anthropic。
 科技前沿
Anthropic每月花12.5亿美元租xAI算力,AI竞赛背后的天价交易
SpaceX S-1文件披露Anthropic与xAI签署每月12.5亿美元算力租赁协议,租用COLOSSUS超算集群至2029年,总额约450亿美元。竞争对手之间的算力合作揭示AI行业算力极度稀缺的真实现状。
 科技前沿
Qwen3.6 35B开源实测逼近Claude,xAI语音克隆API正式上线
阿里开源Qwen3.6 35B模型,256专家MoE架构仅需3B激活参数,SWE Bench成绩逼近Claude Opus。xAI发布Voice Cloning API支持28种语言,NVIDIA开源OpenShell安全沙箱,Sam Altman表态模型智力优先。
 前沿研究
上交大PhyAR:破解Video-LLM物理推理中的语义先验劫持难题
上海交通大学提出PhyAR框架,通过PACC数据集和VARC视觉锚定推理链机制,解决Video-LLM在物理推理中语义先验劫持视觉感知的核心缺陷,无需修改模型架构即可显著提升物理异常检测能力,全面超越GPT-4O等SOTA模型。
 科技前沿
Qwen3.6 MTP加速实测:单GPU推理飙到220 token/s
Qwen3.6实验性MTP-GGUF版本实测,单GPU将35B-A3B模型推理速度提升至220 token/s,比原版快1.4倍且精度零损失。详解MTP原理、最优Draft Tokens策略及RTX 5090实测数据。
 深度解读
Qwen3.5深度解析:混合注意力架构实现19倍长上下文加速
深入解析阿里开源Qwen3.5模型的混合注意力架构创新,详解Gated Delta Net如何实现256K上下文19倍加速,多模态视觉反超Gemini 3 Pro和GPT-5.2的评测数据,以及RL后训练策略与实际应用Demo。
 观点碰撞
AI权力之争:超级智能该集中垄断还是去中心化普惠?
AI超级智能的控制权正成为时代核心议题。本文深度分析AI权力集中化的现实风险、去中心化开源运动的机遇与挑战,探讨如何在开放与安全之间找到平衡,为AI治理提供第三条路径思考。
 科技前沿
Stargate星门项目落地德州阿比林:5000亿美元AI基础设施建设全解析
OpenAI联合软银、甲骨文推出的Stargate星门项目落地德州阿比林,总投资5000亿美元。本文深度解析项目选址逻辑、算力规模、就业经济效应及其在全球AI算力竞赛中的战略意义。

