#前沿研究
共 8569 篇相关文章
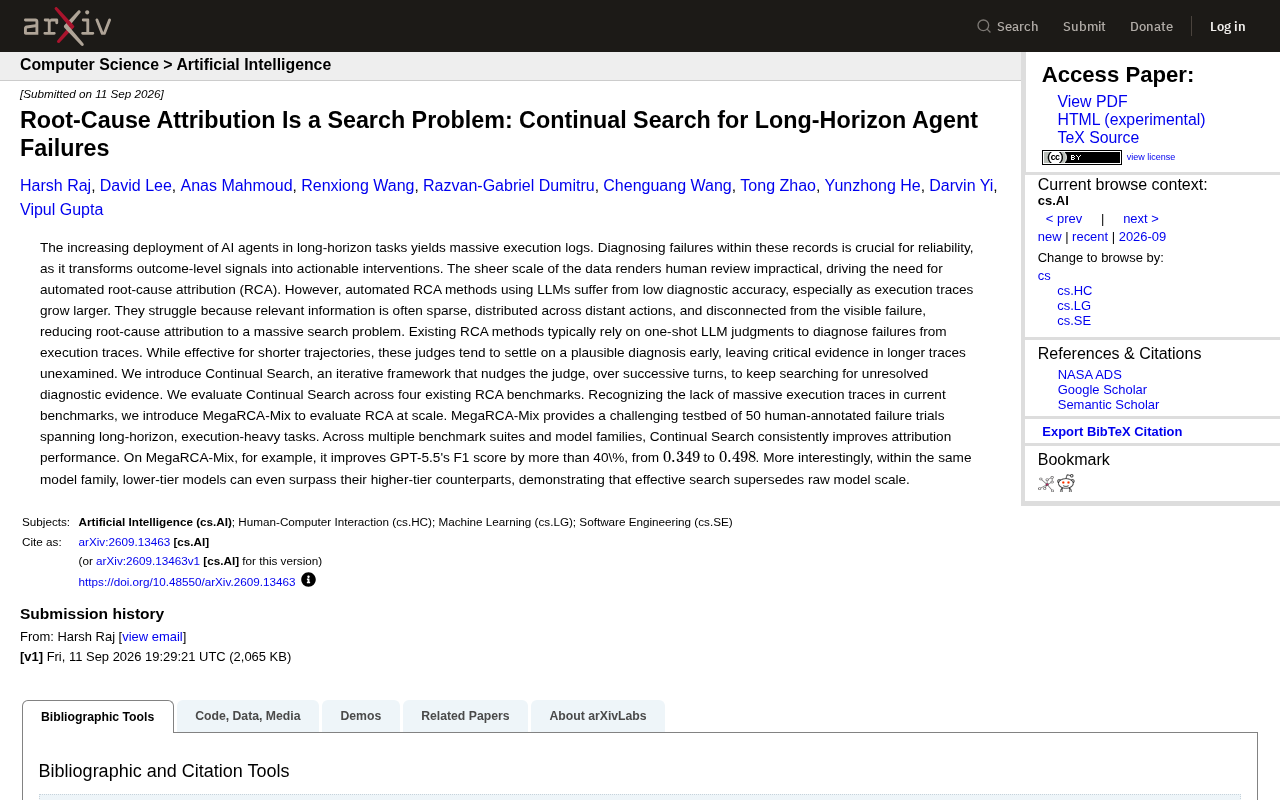
AI智能体故障归因:把根因分析变成一个搜索问题
arXiv新论文提出Continual Search框架,将AI智能体的根因归因重新定义为搜索问题,通过多轮迭代让LLM持续追查故障证据。在MegaRCA-Mix基准上将GPT-5.5的F1分数提升超40%,且低配模型可超越高配模型。
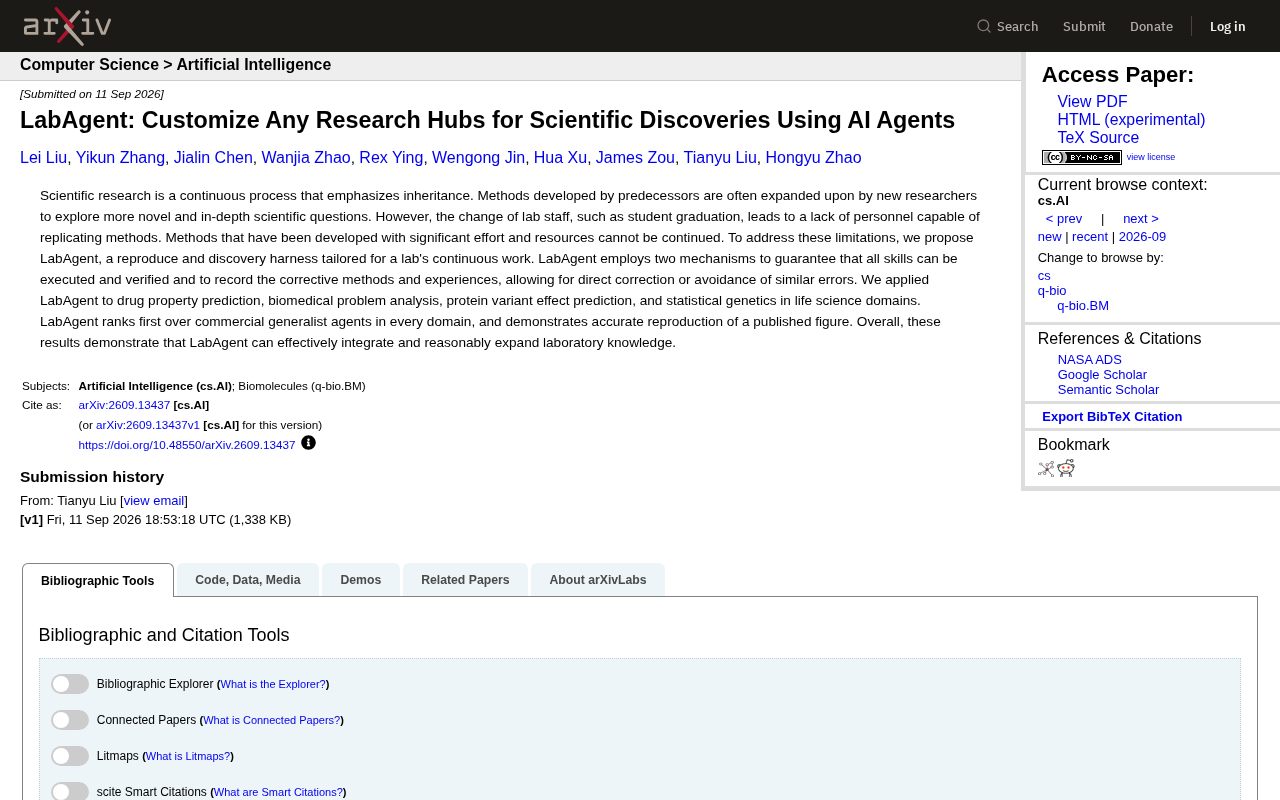
LabAgent:为科研实验室打造可复现的AI智能体系统
arXiv新论文提出LabAgent,一套面向科研实验室的AI智能体系统,通过可执行验证和经验记录两大机制解决科研方法传承难题,在药物预测、蛋白质变异等生命科学领域超越通用智能体。

TimeThink:让时序大模型学会组合式推理的合成框架
TimeThink 是一个用于激发时序大模型组合式推理能力的合成框架,通过确定性生成可验证的问答数据与 RLVR 训练策略,仅用合成数据即在真实基准上超越强基线,为医疗等高风险场景的可解释时序推理提供新思路。

自适应物理AI探索:LLM智能体能否胜任长周期物理任务?
最新arXiv论文探讨LLM智能体能否管理长周期物理任务。研究通过整合规划、工具调用、观察与验证的多智能体框架,在农业场景中对比零样本LLM与强化学习智能体,发现LLM在环境变化时具备更强的自适应能力。
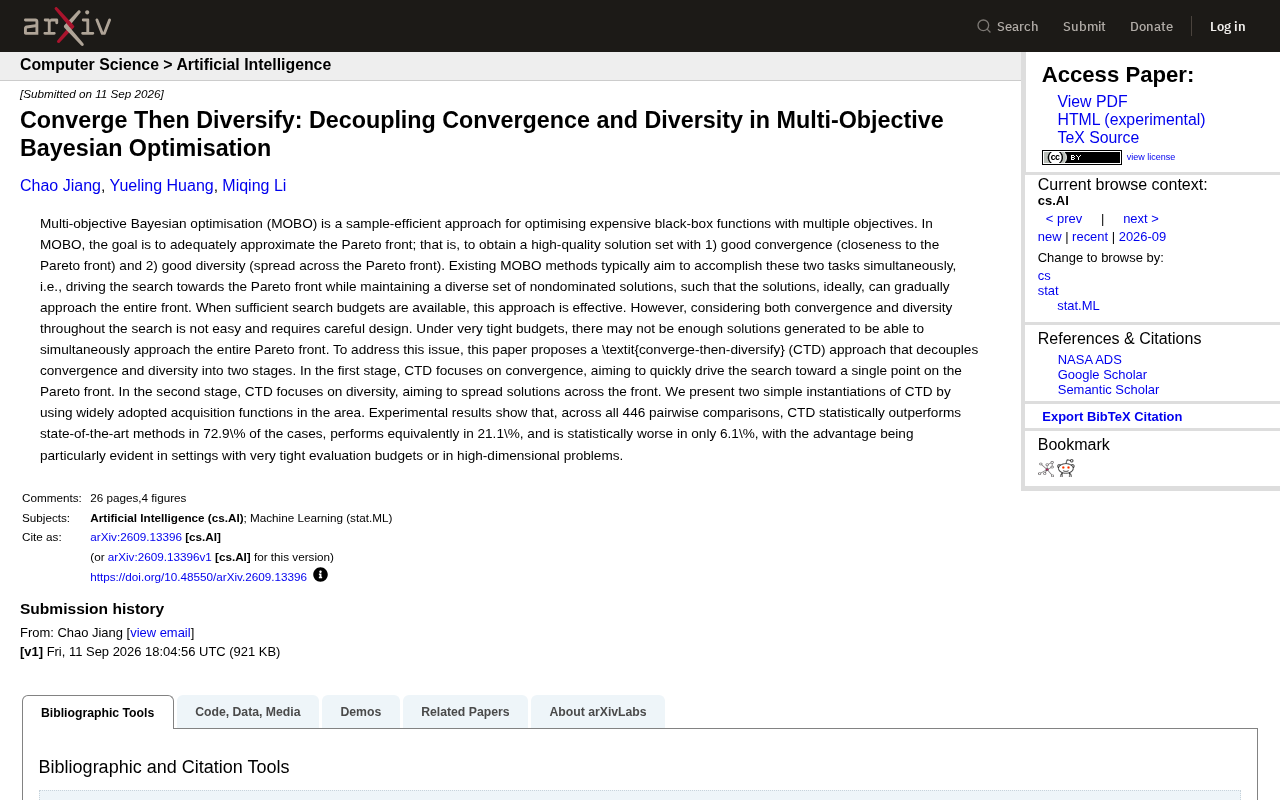
先收敛后多样化:多目标贝叶斯优化的CTD新范式
arXiv新研究提出Converge-Then-Diversify(CTD)方法,将多目标贝叶斯优化中的收敛与多样性解耦为两个阶段。在446次对比中72.9%显著胜出,尤其在紧预算和高维问题中优势明显。

Vibe Patenting:LLM评审员能胜任专利撰写评估吗?
arXiv最新研究通过Vibe Patenting测试平台,评估LLM评审员在专利撰写这类专业任务中的可靠性。研究发现评审反馈能让低成本智能体逼近高端模型,但AI评审与人类专利律师的一致性强烈依赖具体指标。
GAI框架:统一迭代策略改进与递归自我改进的形式化理论
arXiv 新论文提出广义智能体迭代(GAI)框架,将经典迭代策略改进(GPI)与递归自我改进(RSI)统一为同一学习范式,用两个关键维度区分系统类型,为分析和设计自我改进 AI 提供形式化基础。
ZGCM-1:7B全开源模型如何用工具调用挑战千亿级大模型
ZGCM-1 是一个完全开源的 7B 稠密基础模型,通过耦合内部思考与外部工具调用,在数学推理和智能体搜索任务上媲美 Qwen3-235B、GLM-5.1 等超大模型,并公开全流程权重、代码与数据配方。

谁在攻击AI巨头?一家以色列公司引发的争议
一家标榜有效利他主义理念的以色列公司被指涉及针对OpenAI、Anthropic和Meta的网络攻击。本文分析事件背景、AI企业安全风险及有效利他主义与AI安全的复杂关系。
分布式系统经典论文导读:从入门到精通的必读清单
一份在 Hacker News 走红的分布式系统经典论文清单,涵盖共识算法、逻辑时钟、CAP 定理等核心主题,为工程师提供系统化的学习路径与理论到实践的桥梁。
"Dario, Please":一封写给Anthropic CEO的公开呼吁引发热议
《Dario, Please》一文在Hacker News引发热议,累计247分与122条评论。这封写给Anthropic CEO Dario Amodei的公开呼吁,折射出AI社区对头部大模型公司决策方向的持续关切与话语生态变化。
vLLM 全栈优化实战:如何应对真实 Agent 流量的服务压力
vLLM 全栈优化实战:如何应对真实 Agent 流量的服务压力
vLLM 团队发布全栈优化博客,针对真实 Agent 流量对推理服务栈的压力,从架构、框架到运行时协同优化,并在 SemiAnalysis 的 AgentX 公开基准上进行测量。本文解析其优化思路与工程启示。
SOP-Bench:评估AI智能体处理真实业务流程的新基准
SOP-Bench 是一个用于评估 AI 智能体处理真实业务流程能力的新基准,采用可扩展框架,测试完成标准作业程序所需的全套能力,而非孤立的代理任务,为企业落地 AI Agent 提供更务实的参考。
Verus:用形式化验证打造可证明正确的Rust代码
Verus是面向Rust的程序验证器,通过对照数学化功能规范自动检查代码,实现可证明正确的Rust程序,为加密、内核等高安全场景提供数学级正确性保证。本文解析其工作原理与工程价值。
无法在脑中"看见"画面的人,正在改写想象力科学
幻像失能症(Aphantasia)指无法在脑海中形成视觉意象的现象。这群"看不见"画面的人正推动认知科学重新理解人类想象力的多样性,涉及意识、记忆与感知机制。
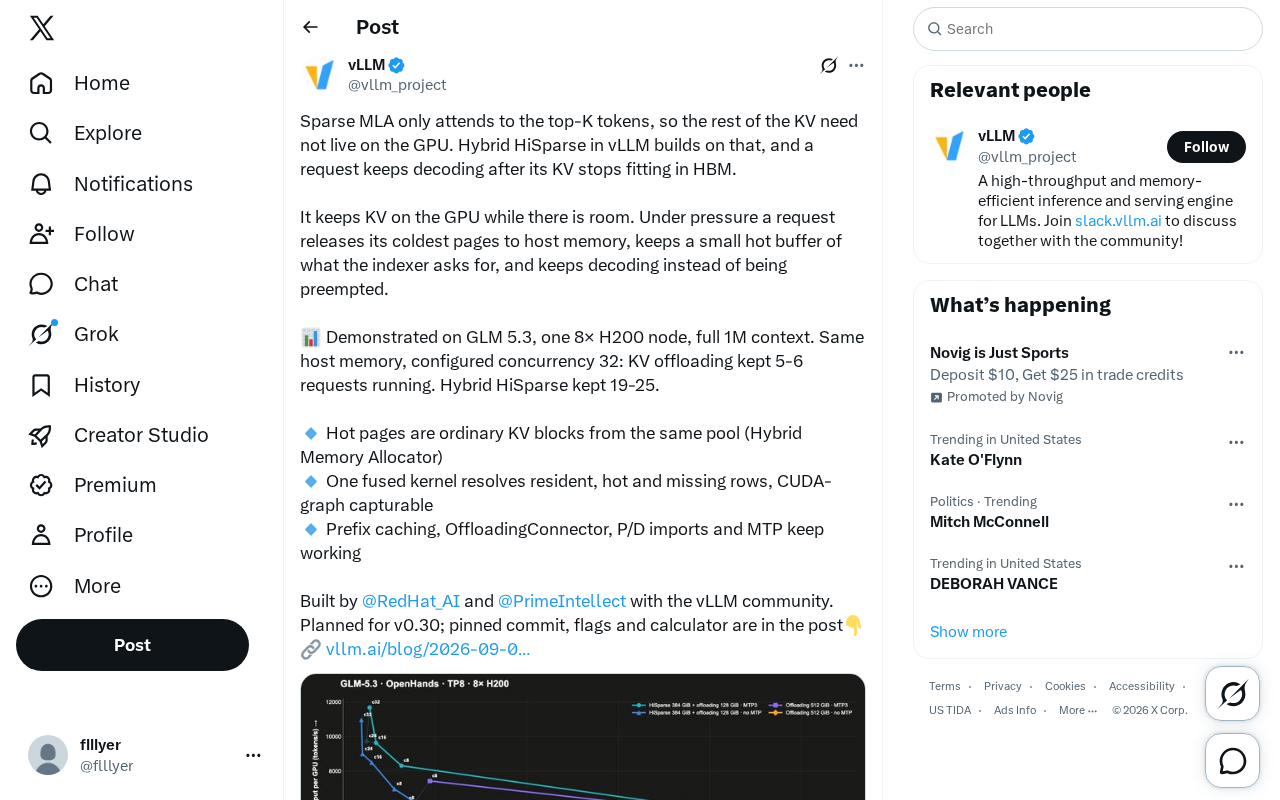
vLLM Hybrid HiSparse:稀疏MLA破解长上下文显存瓶颈
vLLM 社区推出 Hybrid HiSparse,基于稀疏 MLA 与分级内存调度,让长上下文请求在显存不足时持续解码。GLM 5.3 实测显示,8×H200 节点上并发请求数从 5-6 提升至 19-25,将集成于 vLLM v0.30。
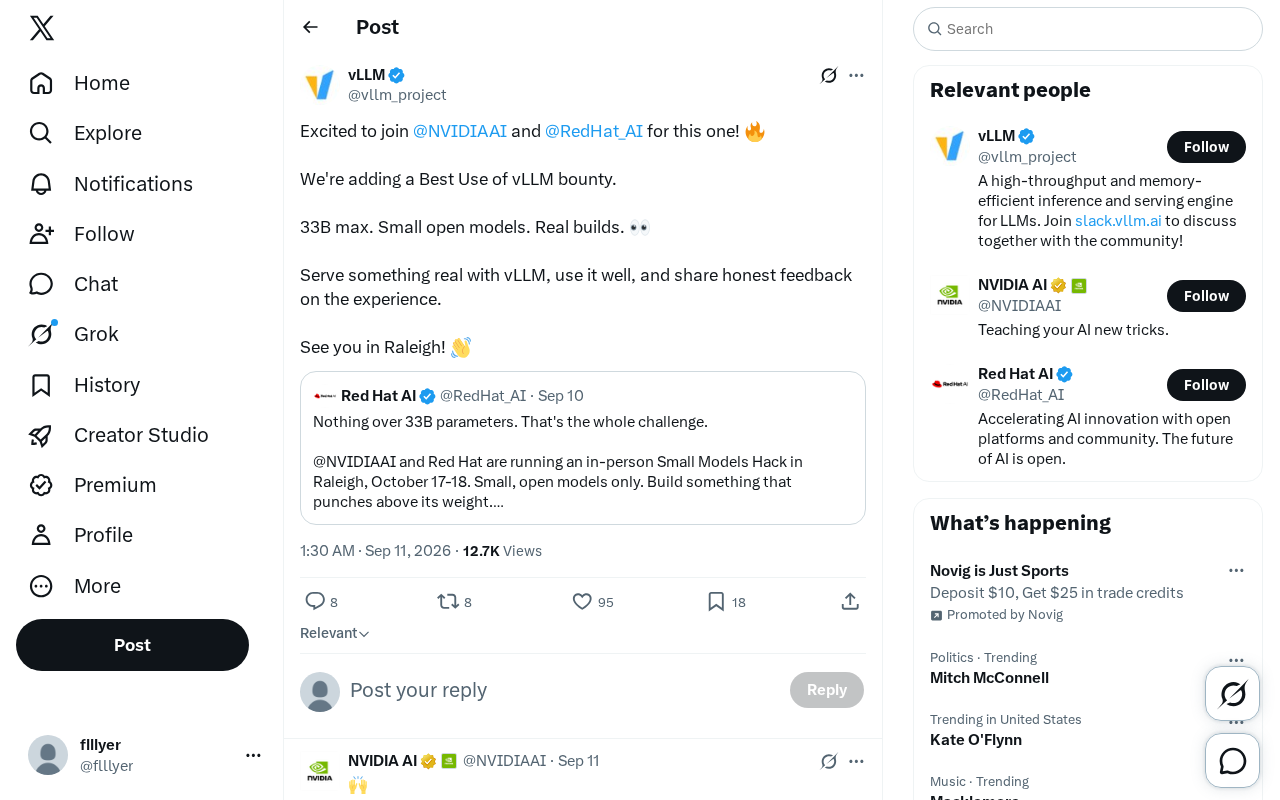
vLLM 黑客松赏金上线:33B 以下开源模型的实战部署较量
NVIDIA 与 Red Hat 联合为 vLLM 增设「最佳应用」赏金,聚焦 33B 以下小型开源模型的真实部署与推理优化。本文解读活动信号、参数上限逻辑及对开发者的实战参考价值。

DeepSeek-V4.1-Flash发布:552B MoE与Engram记忆架构解析
DeepSeek-V4.1-Flash正式发布,采用552B MoE主干、100万上下文与原生视觉,vLLM从首日起支持并验证NVIDIA与AMD GPU。深度解析Engram记忆架构与压缩KV共享两项核心创新。