#前沿研究
共 6896 篇相关文章

第二模型审稿实测:40条评论揭示AI审稿的真实价值
实测七篇文章、四十条审稿评论,揭示AI第二模型审稿的真实价值:擅长对账而非判断,能捕捉无边界断言,但可用性仅38%,误报源于情境缺失。

APSD:按正确性不对称蒸馏,2.6倍训练加速LLM后训练
APSD提出正确性依赖的非对称自蒸馏目标:正确rollout用插值保留成功行为,错误rollout用外推强化纠正,在Qwen3模型上以2.6倍更少训练步数达到SDPO性能。
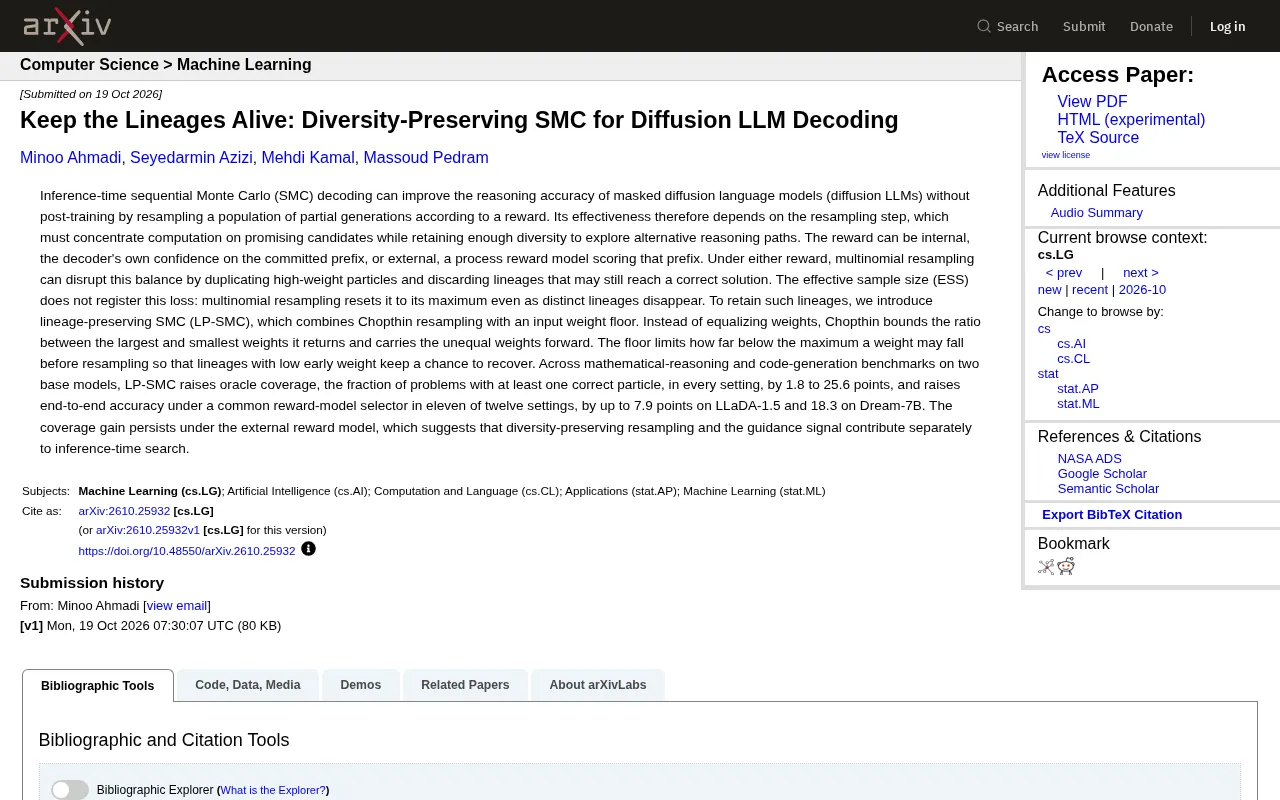
LP-SMC:用谱系保留重采样提升扩散语言模型推理
LP-SMC 提出谱系保留的 SMC 重采样方法,结合 Chopthin 重采样与输入权重下限,在扩散语言模型的数学推理和代码生成任务上提升 oracle 覆盖率最高 25.6 个点,端到端准确率最高提升 18.3 个点,无需额外训练。
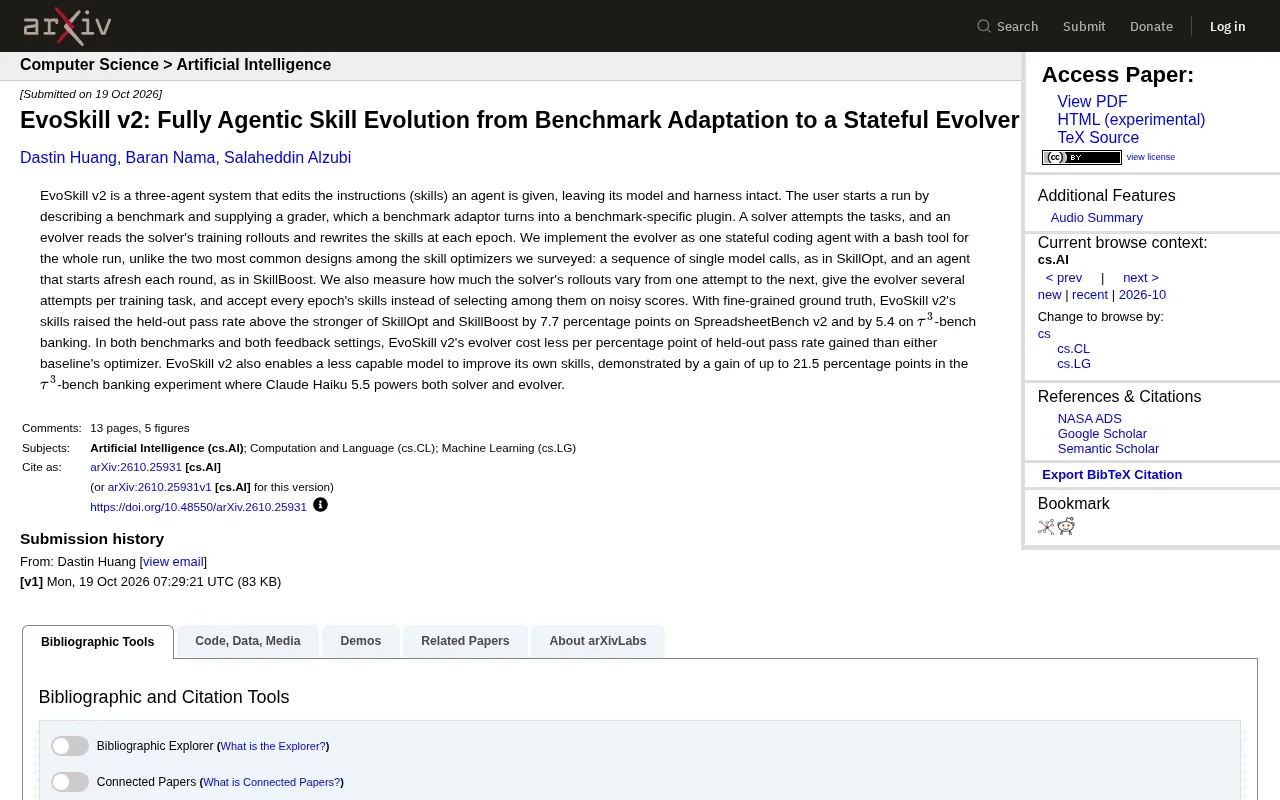
EvoSkill v2:有状态进化器如何让AI智能体自我改写技能
EvoSkill v2 提出三智能体系统,用有状态进化器改写AI智能体技能而非模型权重。在 SpreadsheetBench v2 和 τ³-bench banking 上留出集通过率分别提升7.7和5.4个百分点,单位收益成本低于 SkillOpt 与 SkillBoost,弱模型自我进化最高提升21.5个百分点。

UniAVC:统一音视频生成新范式,异步调度破解跨模态难题
UniAVC 提出渐进式训练与模态解耦调度器,解决音视频联合生成中配对数据稀缺和统一噪声调度的问题,用单一权重覆盖联合生成、跨模态编辑与自 refinement 等多任务。

DaFISH:球谐旋转解耦光照,提升新视角合成质量
DaFISH提出球谐旋转解耦光照,将每点颜色分解为反照率与SH光照因子,解决主动光源下神经渲染的外观不一致问题,在五个场景取得PSNR 38.91 dB等最佳指标。
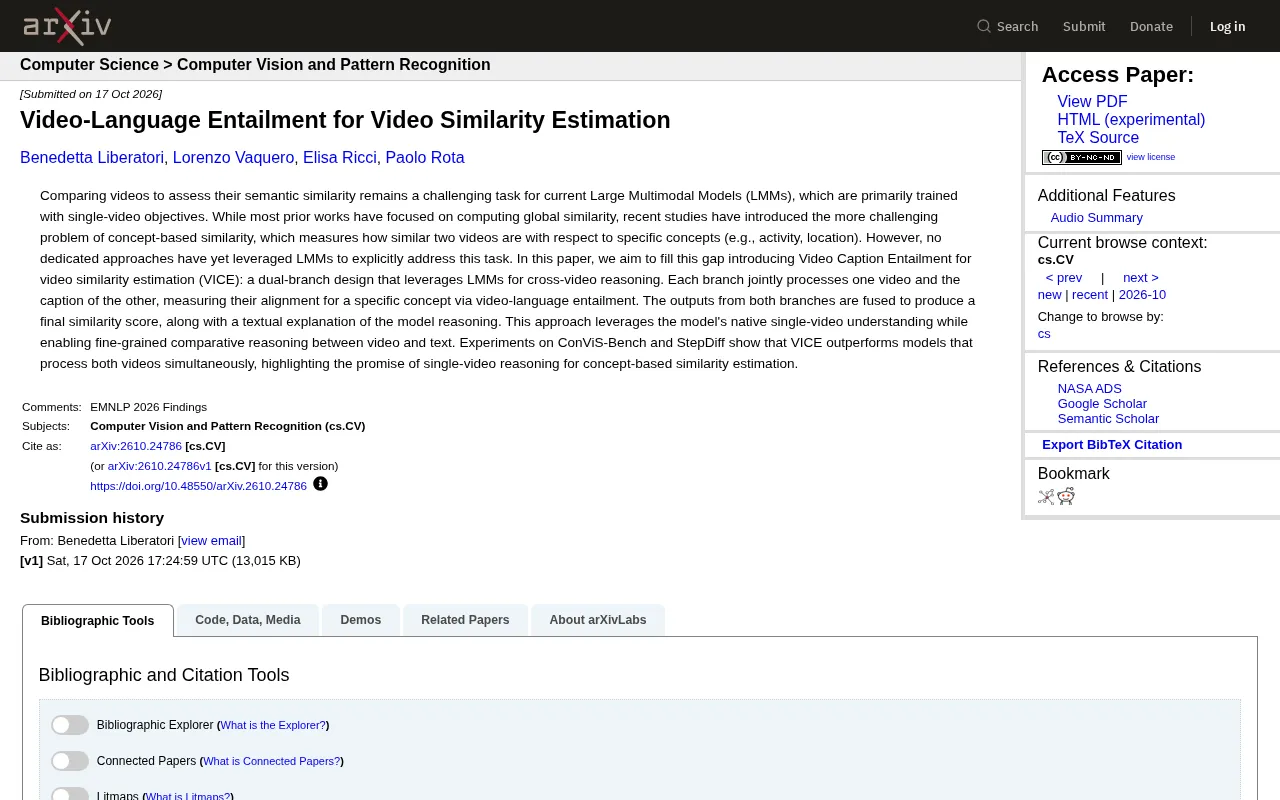
VICE:用视频-语言蕴涵实现概念级视频相似度估计
VICE 提出双分支视频-语言蕴涵框架,利用大型多模态模型的单视频理解能力实现概念级视频相似度估计,在 ConViS-Bench 和 StepDiff 基准上超越同时处理两段视频的模型。

纽约市长曼达尼:AI并非必然,必须加以控制
纽约市长曼达尼公开表态AI并非不可避免,主张必须加以控制。本文梳理纽约市学校AI禁令、房地产广告披露规则,以及联邦与地方在AI监管上的张力与企业内部风险声音。

把决策模型放进Agent循环,而不是放在旁边
Agent循环中的检查成本正在吞噬token预算。本文解析决策模型(Decision Model)如何以单次前向传播返回概率,替代完整生成式判断,让安全门、相关性打分和逐步验证变得廉价可负担,并介绍S1MB榜单与Darwin-27B-ZTC-v9的实测方法。

AI一周大事:DeepSeek被禁、智能体攻破工业巨头与模型效率竞赛
美国DHS下令联邦机构移除DeepSeek及第三方衍生产品,AI智能体攻破John Deere等工业巨头;MiniMax、Inception、Mistral密集发布高效模型,数学家开始审计OpenAI准黎曼证明,Cloudflare与Google推出新工具框架。
工具调用准确率测试的盲区:缺失的“无工具”用例
OpenRouter 指南揭示工具调用评测的盲区:模型调用不该调用的函数仍会产生 tool call,仅检查是否包含调用毫无意义。本文解析工具选择、参数结构与取值之外缺失的第三个维度——调用必要性,并给出轻量日志方案。

POPE基准的Yes/No提取漏洞:VLM幻觉评测被token选择混淆
一项POPE基准复现审计发现,VLM的Yes/No答案提取方式可独立造成6.13分F1漂移。LLaVA-1.5实际生成带空格前缀token而非硬编码ID,该混淆跨三种分词器家族普遍存在,且多数论文未披露读数协议。
GLOBE:几何引导的推理早停,输出减半不损精度
GLOBE 是一种无需训练的在线早停算法,通过单位球面语义轨迹识别推理是否已可停止,在五个基准上减少 49.7% 输出 token 和 51.0% 时延,精度与完整 CoT 相当。

让语音大模型学会呼吸:非语言发声建模新进展
最新研究覆盖13类非语言发声(NVVs),通过自动化合成对话数据集、多阶段微调和NVV感知GRPO,显著提升VocalNet与VITA-Qinyu在共情交互和角色扮演中的自然表现力,探讨语音大模型副语言建模的架构必要性。

AdaExploreBench:LLM智能体主动探索与环境自适应基准
AdaExploreBench 是评估 LLM 智能体在动态环境中主动探索与测试时适应能力的新基准。实验显示 GPT-6 Sol 仅达 61.9% 校准准确率,揭示智能体主动获取证据与检测规则漂移的关键瓶颈。

FisherEdit:用Fisher信息几何实现LLM知识编辑新突破
FisherEdit提出基于Fisher信息几何的知识编辑方法,用参数空间重要性正则化替代零空间投影,在Llama-3、Qwen2.5等模型上实现SOTA编辑性能并保持模型稳定性。

LEAPS基准发布:长上下文模型召回满分,状态跟踪与模式学习却大幅滑坡
LEAPS长上下文评测基准包含12个抗污染数据集,评估30个模型发现:召回满分模型在状态跟踪和模式学习上大幅退化,思考模型反而不如基础模型。

ClueFlow:用归因状态转移破解长程搜索难题
ClueFlow提出基于归因研究状态转移的长程搜索训练方法,通过Source-State-Final归因链实现精准监督与信用分配,在BrowseComp上达60%准确率,SFT仅用30% token匹配全量监督效果。

