#前沿研究
共 8867 篇相关文章

仅用逻辑漏洞攻破Edge:微软浏览器全链攻击解析
解析仅用逻辑漏洞构建Microsoft Edge全链攻击的安全研究,探讨绕过内存缓解机制的攻击思路及其对浏览器防御的启示。
当工具调用超时:RAG 生产环境的故障演练课
Packt Publishing 举办 RAG 生产环境实操工作坊,聚焦工具调用超时、重试循环、执行预算、结构化追踪、权限化工具访问与故障注入测试,由 Bruno Gonçalves 主讲,无需 GPU 或 API key。

Infini-AI-Lab开源Hermit:不改模型与Harness的Agent适配框架
Infini-AI-Lab 开源 Hermit,一个 Apache-2.0 的 harness 适配框架,通过任务反馈训练指令、技能、记忆与工具组成的外部层,不改动 Agent 的模型与 harness,为 Agent 能力增强提供解耦新路径。

Block发布Dessa:纯语音训练的全双工语音模型
Block AI实验室发布Dessa全双工语音到语音模型,仅用人类对话音频训练,可在MacBook Pro M4 Max本地运行,但未公布模型规模、基准测试与权重。

BiRefNet移动端NPU部署难题:高通芯片为何难跑亚秒级分割?
开发者尝试将BiRefNet部署到高通移动NPU和GPU,却因可变形卷积等复杂算子导致编译失败。本文分析移动端部署BiRefNet的难点、算子支持限制及可能的优化方向,探讨亚秒级延迟的实现路径。

灵巧手如何衡量?Xynova仿真对比20款模型引热议
Xynova团队在Reddit分享灵巧手仿真对比:Prima 1在KaRMA测试中平移第二、重定向第一,并探讨超越自由度的灵巧性度量。他们将参加CoRL和Web Summit并展示demo。

气候模型盲区:被低估的反馈循环正在加速变暖
气候模型可能低估了气候变化触发的反馈循环,导致减排目标不够激进。本文解析反馈机制、模型局限及政策风险,呼吁更完整的模拟与更保守的减排路径。
MoE验证该数什么?四token八专家背后的账
MoE投机解码中,验证多个草稿token会触达不同专家权重,四token八专家最多涉及32个路由专家。本文解析唯一专家计数为何应成为接受token数之外的补充指标,以及profiler如何在路由层暴露专家重叠。
OpenAI智能体通过CPU缓存实现“对话”:AI协作机制新探索
OpenAI智能体通过CPU缓存通信的技术分析:探讨多智能体系统利用硬件缓存实现低延迟协作的原理、优势与挑战,为AI系统设计提供新思路。
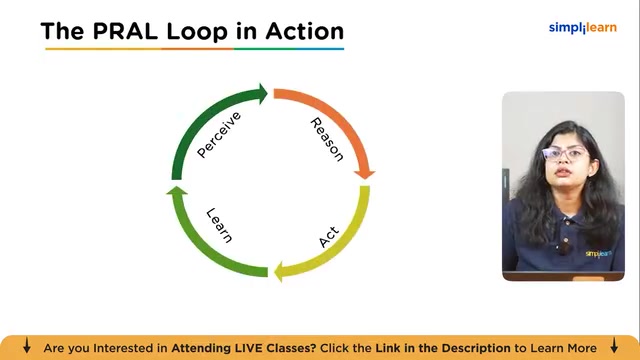
1小时搞懂Agentic AI:架构、设计模式与实战搭建
Simplilearn的Agentic AI速成课程解析:智能体三层架构(感知、认知、动作)、单智能体与多智能体对比、感知推理执行学习循环、三种设计模式,以及研究智能体、应用构建和反馈修复循环的实战演示。

在Qwen3.5里跑起一颗RISC-V CPU:Qwenputer的确定性实验
Qwenputer在Qwen3.5模型内部实现可运行、确定性的RISC-V CPU,探索语言模型作为状态机的可能性。本文分析其原理、确定性设计、对AI编程的启发以及当前局限。

STAIR:结构化信息检索的新方向?
Reddit社区讨论STAIR——结构化信息检索的新方向。本文分析结构化检索在大模型时代的价值、语义到模式映射的核心难点,以及社区对该方向的分歧与期待。

求推荐:轻松闲聊又懂技术的AI播客?
从Reddit一则求推荐帖出发,分析为什么轻松闲聊式的中高级技术AI播客难找,梳理社区常见推荐方向,并给出挑选这类播客的实用标准。
vLLM 实现 MiniMax M3.1 Flash 首日支持:面向自动化与…
vLLM 实现 MiniMax M3.1 Flash 首日支持:面向自动化与视觉推理的工程优化
vLLM 宣布对 MiniMax M3.1 Flash 提供 Day-0 支持,该模型面向多步自动化、真实代码库工程与视觉推理,服务栈集成原生 NVFP4 KV 缓存、NVFP4 MoE 权重与 DSpark 投机解码,本文解读其工程优化与部署要点。
Anduril携手高通:2027年推出全美产笔记本
Anduril与高通宣布合作,计划2027年在美国本土生产笔记本电脑,首款产品将符合Buy American标准,并推动行业建立完全本土化供应链。本文分析合作细节、行业背景与面临的挑战。

Qwen4 百万上下文窗口曝光:27B与Max版本即将登场
Reddit 爆料称 Qwen4 全系将支持 1M 上下文窗口,Qwen4-27B 或在荷兰 Apsara 大会公布,Qwen4-max 日期疑为占位符。本文梳理爆料细节并分析百万上下文对开发者的实际影响。

上海AI Lab开源Sage-A1.5:35B MoE模型获vLLM首日支持,本地部署智能体
上海AI Lab开源Sage-A1.5模型,35B总参数、3B激活的MoE架构,主打智能体能力,发布首日即获vLLM支持,开发者可用一行命令本地部署推理服务。

MiniMax M3.1 Flash 落地生产:开源推理生态的里程碑
MiniMax M3.1 Flash 已在生产环境大规模运行,由 @inferact 提供带 SLA 保障的推理服务,工程改进回流 vLLM 上游。本文分析其对开源推理生态的意义及对开发者选型的启示。

