#开源工具
共 13328 篇相关文章

反向自蒸馏:弱化模型竟能提升推理能力
WISD提出反向自蒸馏:通过量化或剪枝弱化模型,利用弱化前后的对比作为训练信号,在数学和代码推理任务上平均准确率提升4.0和5.5个百分点,无需特权信息即达SOTA。

Claude将全球法律搬进Git:语义化、版本化的法律查询新范式
开发者利用Claude Code将全球法律转化为Git仓库,实现法律语义化、版本化和Agent可查询。项目在Hacker News登顶,以CC0开源,为AI法律问答提供可靠数据源。
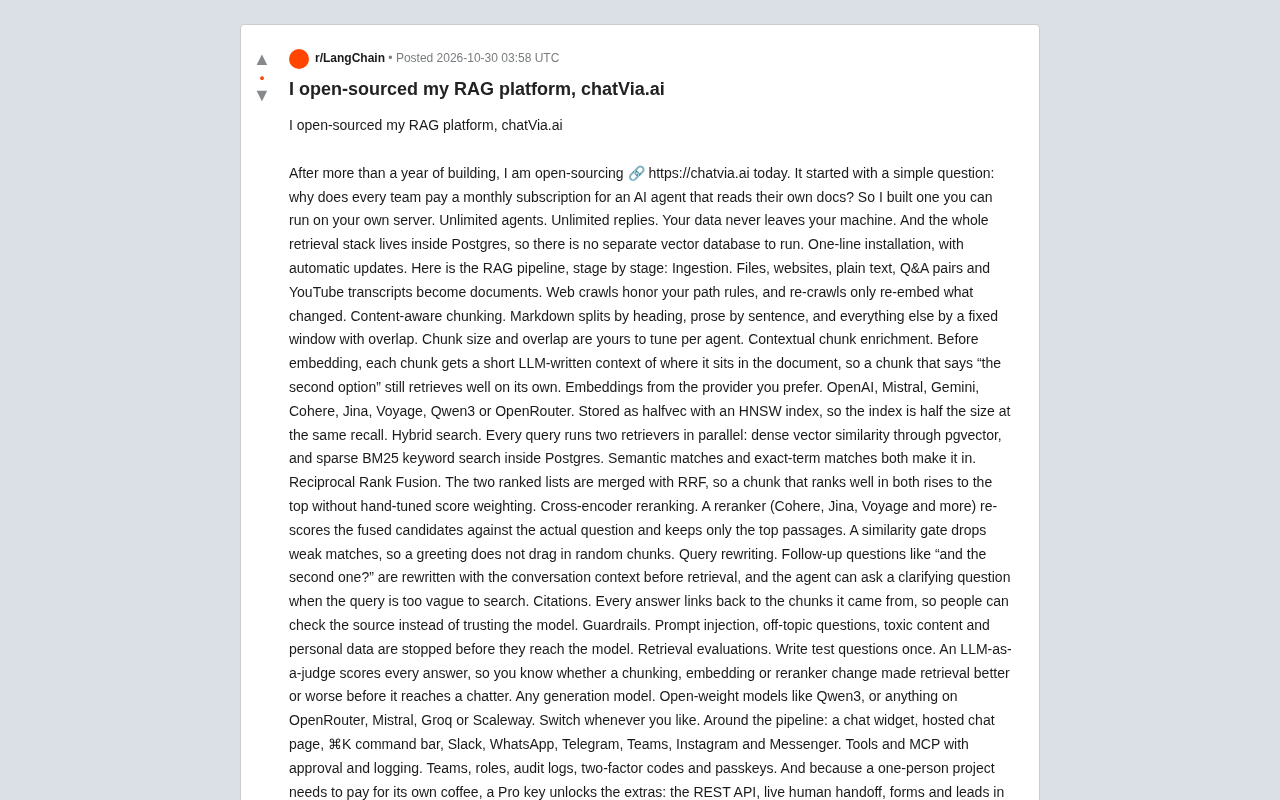
开源RAG平台chatVia.ai:全栈检索管线与自主部署
chatVia.ai开源RAG平台将向量检索、BM25与RRF融合全部放进Postgres,支持自托管、无限代理与自动更新。本文拆解其摄取、分块、混合检索、重排与评估管线,并说明免费核心与Pro付费边界。

FDSML:用参数感知三元组损失革新合成预训练
FDSML提出参数感知三元组损失,利用图像生成参数构建关系监督,在Stanford Online Products和Stanford Cars上Recall@1分别提升至74.0%和78.4%,为合成预训练提供新思路。
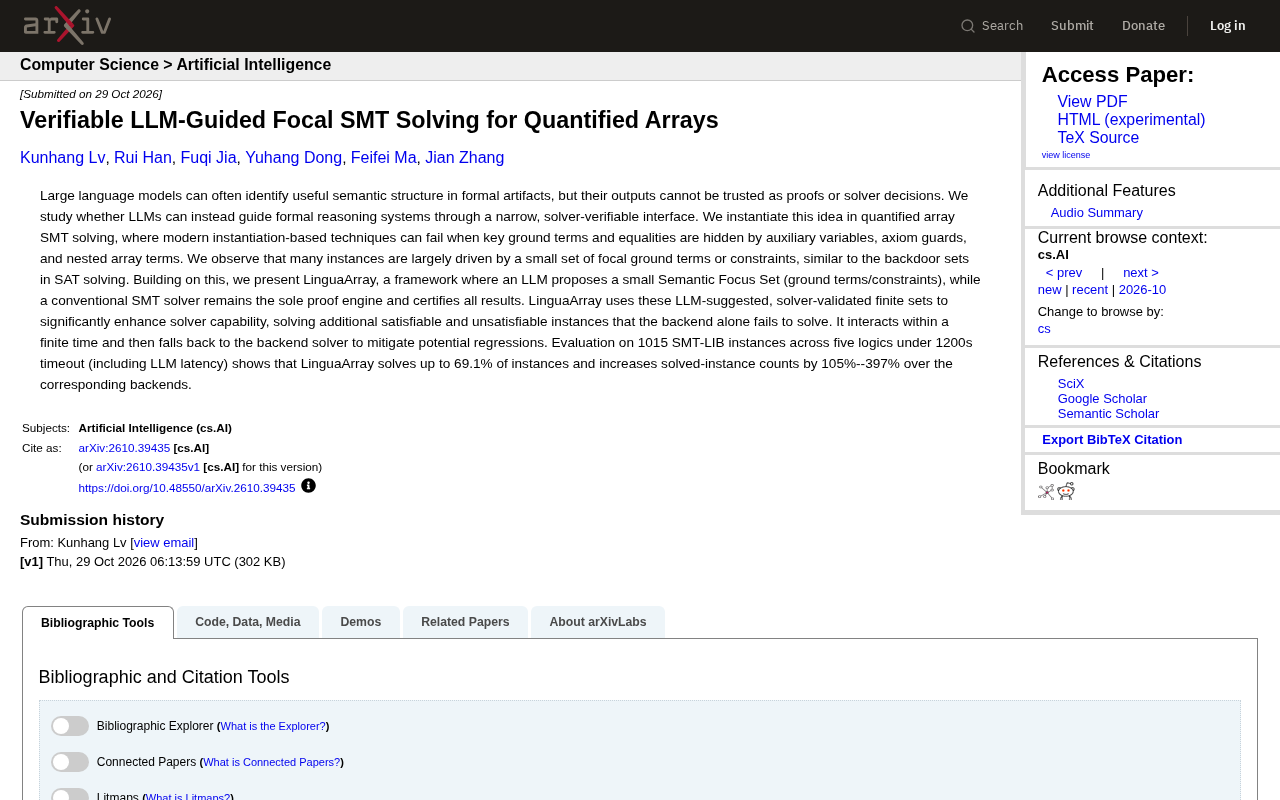
可验证的LLM引导SMT求解:LinguaArray框架解析
本文解析LinguaArray框架,一种让LLM通过可验证接口引导SMT求解器的新方法。LLM提议语义焦点集,求解器验证结果,在1015个实例上最多解决69.1%,解决数量提升105%-397%。

Kairos:面向PDDL语义感知的规划引擎编排框架
Kairos提出语义感知的规划引擎编排框架,根据PDDL任务特征动态调度五个专用引擎,在1,756个基准任务上超越单一最强规划器,并支持十七种PDDL特性。

Soei:为多智能体编程构建证据与意图的可观测性
Soei 研究审计开源工具 Agenttrail 的可靠性,基于 45 个真实编程智能体会话量化证据缺口:23.4% 的编辑片段缺乏后续独立检查,57.8% 的完成标记缺少证据,并提出哈希链账本与证据门控方案。

Unlimited OCR 2:单次解析百页文档,计算成本恒定
Unlimited OCR 2 通过稀疏参考滑动窗口注意力(SR-SWA)与无限视野解码,将超长文档解析的单步计算成本固定为恒定值,百页量级相对全注意力实现 7.0 倍单步加速,并在 MPDocBench 与新建的 MarathonDocBench 上取得当前最优表现。

ARBITRA:多专家论证框架实现鲁棒文档级ATT&CK抽取
ARBITRA提出多专家论证框架,通过角色专精LLM专家提议候选ATT&CK实体,并用定量双极论证框架(QBAF)验证,实现鲁棒文档级ATT&CK抽取,精确率优于句子级流水线和GPT-5.5等前沿模型,对抗扰动下精度退化仅一半。

云边端分布式机器学习安全综述:异构性下的可信挑战
本文解读一篇关于云边端系统中可信分布式机器学习的综述,分析联邦学习在异构性下的安全、隐私与鲁棒性挑战,涵盖攻击防御、评估指标与治理方向。

DECIDE框架:无模型量化数据分析决策重要性
DECIDE是一个无模型框架,直接从实际结果出发量化数据分析中每个决策的重要性,避免传统启发式方法对模型正确设定的依赖,为多宇宙分析和可重复性危机提供新工具。

Linux TCP 释放后重用漏洞 CVE-2026-98432 解析
解析 Linux TCP 释放后重用漏洞 CVE-2026-98432 的技术实质与补丁验证流程,结合 Hacker News 社区讨论,探讨内核内存安全响应的演进方向及对运维开发者的现实含义。

CPU也能高效跑长上下文注意力:CACPU内核解析
CACPU是专为因果全序列预填充设计的CPU注意力内核,通过分层缓存分块和内核内任务调度,相比PyTorch SDPA等内核最高加速2.01倍,集成SGLang后Llama-3.1-8B首Token延迟降低1.74倍。
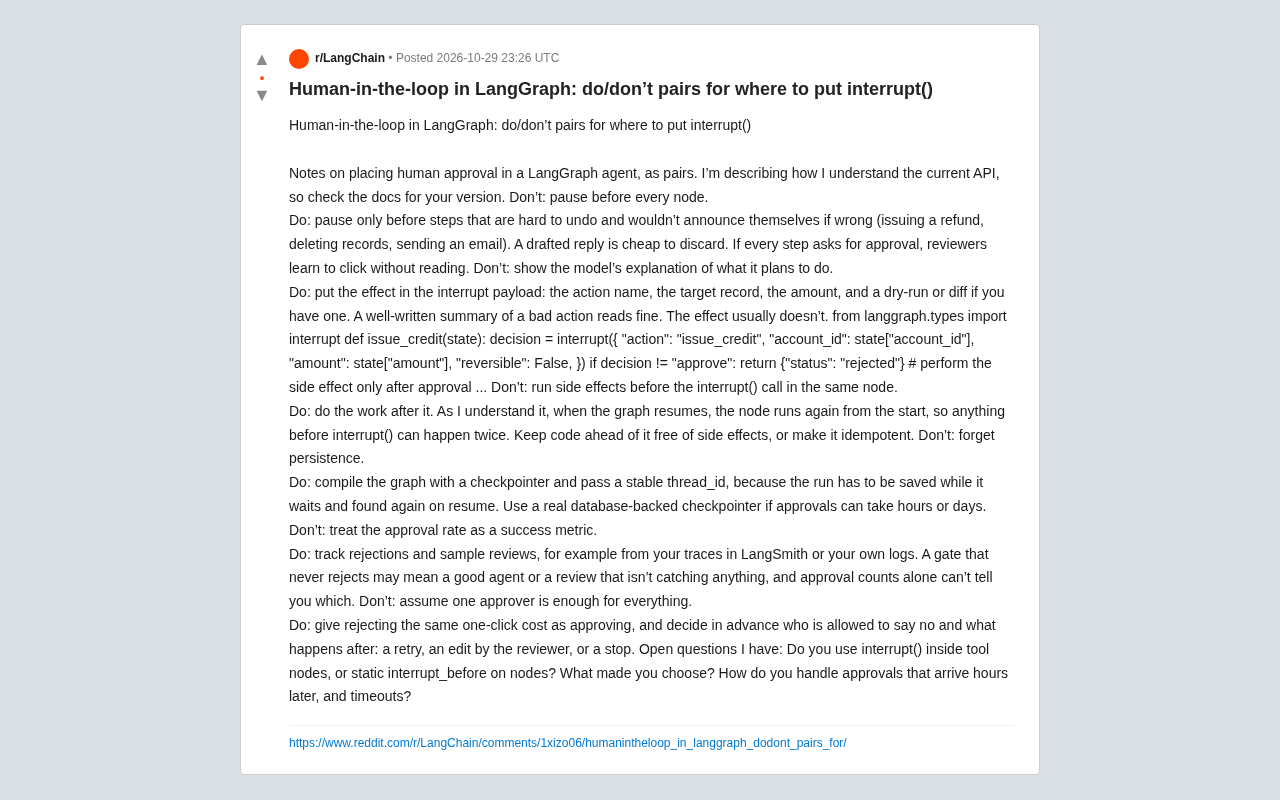
LangGraph人机协同:interrupt()该放哪?六组do/don't
解读Reddit上关于LangGraph人机协同的实践笔记:interrupt()该放在哪些节点、审批载荷怎么写、副作用为何必须放在interrupt()之后、checkpointer与thread_id如何配合,以及审批率为何不能当成功指标。
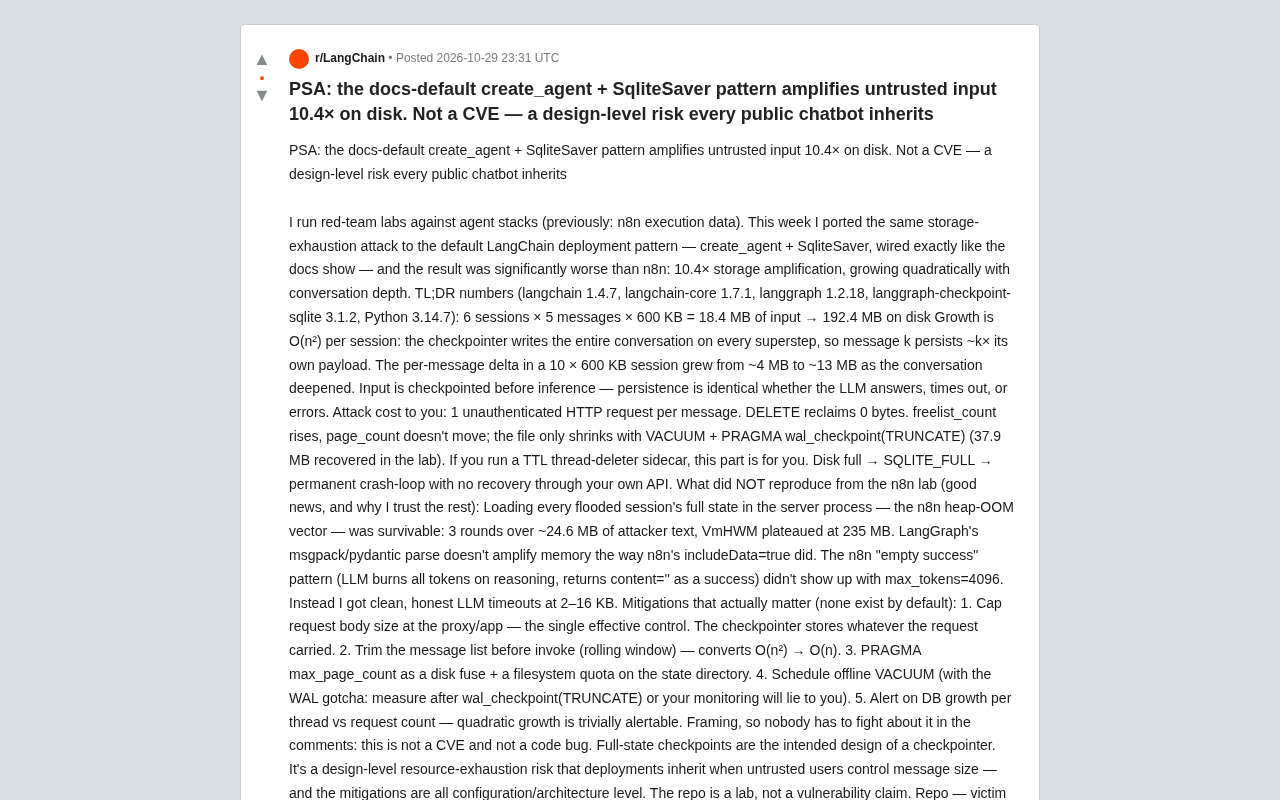
LangChain默认配置存10.4倍放大风险,公共聊天机器人如何自救?
红队研究员发现LangChain默认create_agent+SqliteSaver模式会将不可信输入放大10.4倍存储,且增长呈二次方。这不是CVE而是设计级风险,每个公共聊天机器人都可能受影响。本文详解攻击原理、实验数据及五条有效缓解措施。

多Agent系统如何为每个Agent选对模型
多Agent系统中每个Agent该用哪个模型?本文解析按Agent分配模型的实践:小模型处理高频查询、前沿模型负责语气与判断、本地模型满足数据合规,并覆盖fallback设计、评测先行与按任务成本决策等关键要点。

Sam Altman称本地推理浪费资源,开源社区为何不买账?
Sam Altman称本地推理是对稀缺资源的糟糕分配,认为云端集中利用更高效。开源社区为何反弹?本文拆解双方逻辑、利益立场与混合模式的现实边界。

Android Tracing 2.0:七倍提速与上下文传播的追踪革命
Android Tracing 2.0 全面解读:追踪 API 性能提升七倍,新增跨协程与线程的上下文传播、自定义元数据与可定制后端。Wyze 借其将启动速度提升 45%,R8 优化提速 25%,Compose 1.13 重组追踪现已可用。

