#模型压缩
共 13 篇相关文章
模型蒸馏视觉解析:小AI如何向大模型偷师,复制争议何来?
Reddit视觉解析深入探讨模型蒸馏:小模型如何从大模型学习,以及实验室为何担忧该技术被用于复制模型能力。文章拆解技术原理、争议焦点与开发者合规启示。

曲率感知剪枝CACTUS:同时保留影响函数的新方法
曲率感知剪枝方法CACTUS提出基于ADMM的优化器,在Qwen3-4B上50%剪枝时将C4困惑度差距缩小45%,梯度余弦相似度从0.670提升至0.755,并支持有效数据选择。

亚1比特大模型压缩:潜因子分解技术解析
亚1比特大模型压缩是什么?本文解析基于潜因子分解(Latent Factorization)的LLM超低比特压缩技术原理、价值与挑战,探讨大模型如何突破1比特量化边界实现高效部署。

MoR-MLLM:用递归混合机制打造高效多模态大模型
MoR-MLLM 基于 Mixture-of-Recursions 框架,提出按 token 自适应递归机制,为复杂 token 分配更多算力、跳过冗余运算,大幅降低多模态大模型的训练内存与计算复杂度,同时保持高性能。

LRCC:用条件计算改进低秩压缩的新思路
arXiv 新论文提出 LRCC(低秩条件计算),通过训练轻量级路由器为每个 token 动态选择低秩路径,在同等算力预算下显著优于静态低秩压缩,Llama-2-7B 下游准确率提升 7.6 个百分点。

生物医学翻译模型压缩实战:体积减69%,推理快98%
arXiv新论文研究生物医学神经机器翻译的模型压缩,结合知识蒸馏与量化技术,在法英翻译任务中实现体积减少69%、推理速度提升98%、碳排放降低98%,且不牺牲翻译质量,为资源受限的翻译服务提供了高效部署方案。
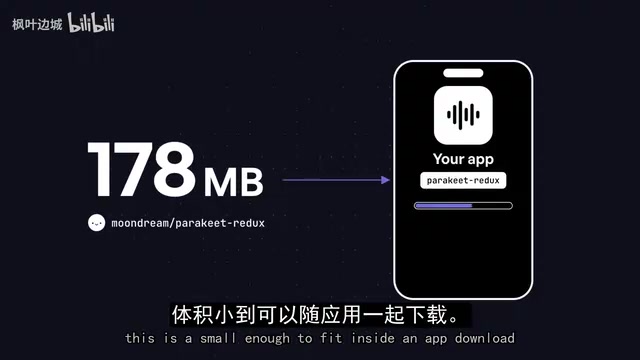
Parakeet Redux:178MB语音模型压缩背后的开源陷阱
Moondream 的 Parakeet Redux 将 1.2GB 语音模型通过三值量化压缩到 178MB,英语准确率几乎不降,多语言表现反升。本文解析其技术突破、速度实测与闭源引擎 Photon 带来的开源陷阱。

潜空间蒸馏压缩流式神经音频编码器:苹果端侧语音的内存优化之道
苹果研究通过潜空间蒸馏压缩流式神经音频编码器,解决端侧听写中 tokenizer 与稀疏激活基础模型争夺 DRAM 内存的问题,在降低功耗与延迟的同时保持语音识别质量。
AdaMem:让RAG按相关性智能分配记忆token的软压缩新方法
AdaMem 是一种相关性引导的 RAG 软压缩框架,通过查询相关的记忆token动态分配,让高相关段落获得更多记忆预算。在六个问答基准上超越均匀分配基线,64倍压缩下相对增益最高达19.7%,推理延迟降低4倍。
Bonsai 2 27B:9倍压缩下的近无损模型探索
Bonsai 2 27B 声称在近无损前提下将 27B 大模型压缩至原体积的九分之一。本文解析其压缩技术路径、社区反应与实际部署价值,并给出验证建议。
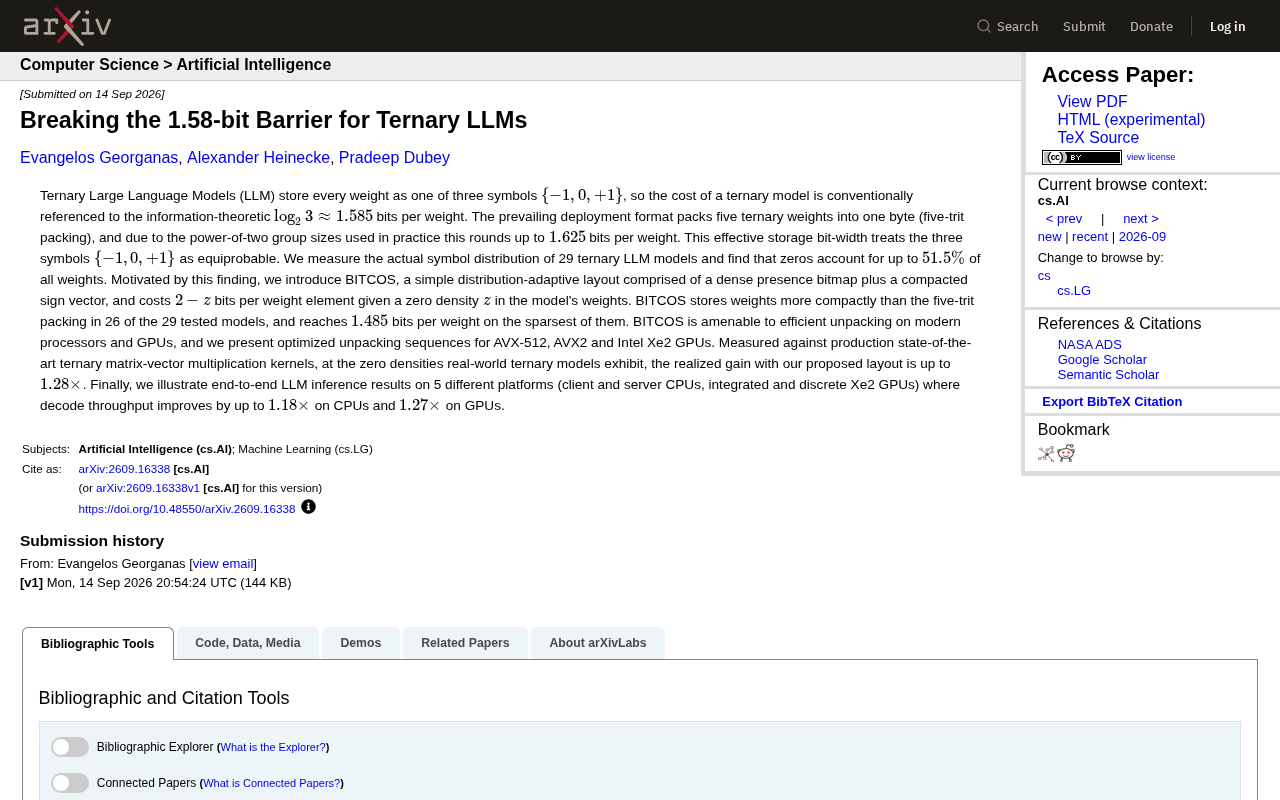
突破1.58比特极限:三元LLM如何逼近信息论边界
三元大模型(ternary LLM)的1.58-bit并非真正下限。本文解析为何利用权重稀疏分布与熵编码可以突破这一信息论壁垒,以及其对低比特量化与端侧部署的工程意义。
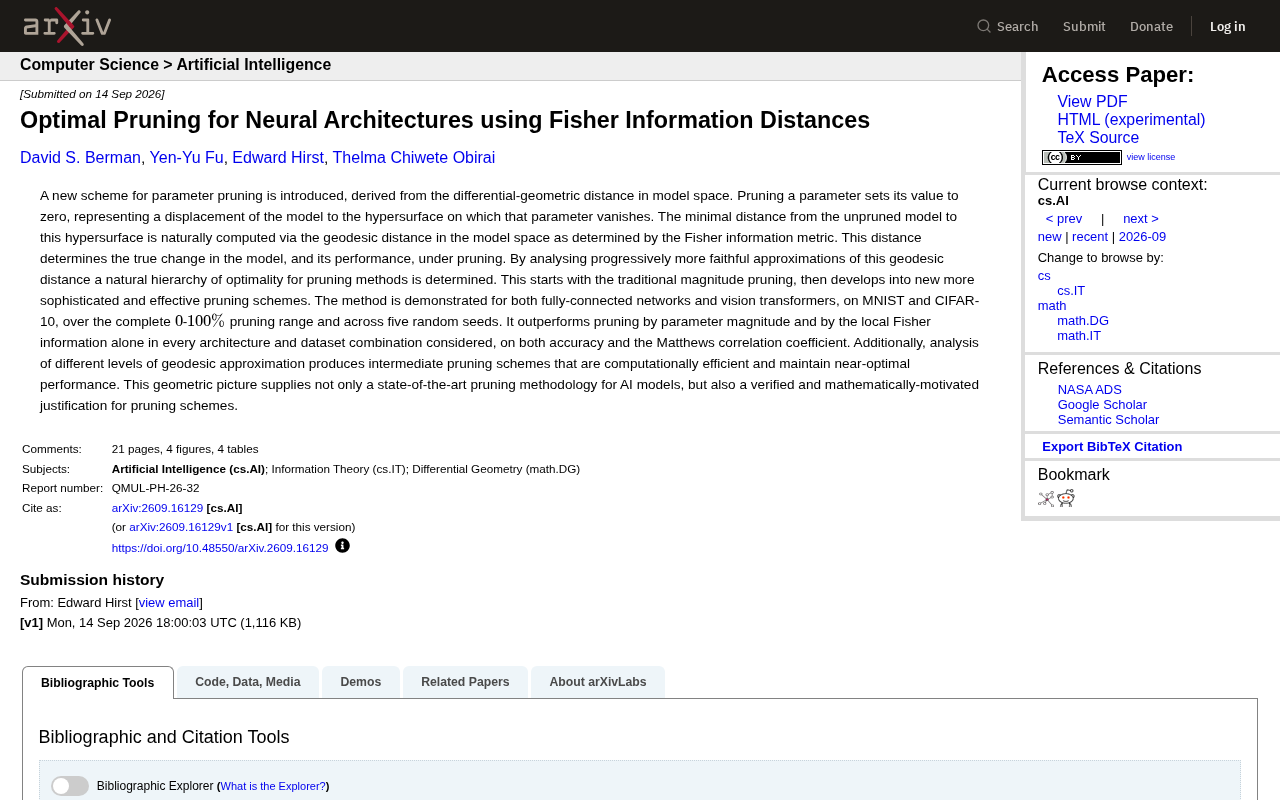
用Fisher信息距离实现神经网络最优剪枝:一种几何视角
arXiv新论文提出基于Fisher信息测地线距离的神经网络最优剪枝方法,将剪枝视为模型空间中的几何位移。该方法在全连接网络与视觉Transformer上全面超越幅值剪枝和局部Fisher基线,兼顾精度与计算效率。
