#评估方法
共 6 篇相关文章

·4 分钟
机器学习降雨预测的评估陷阱:气候基准难以超越
一项基于孟加拉国35个气象站数据的研究揭示,机器学习降雨预测常因随机划分评估而高估性能。气候学基准在时间评估下难以超越,滞后降雨特征仅带来有限技能,研究者呼吁采用泄漏感知协议。
阅读全文 →

·5 分钟
冠脉造影狭窄检测:高召回率优先的实战思路
探讨冠脉造影狭窄检测中高召回率优先的技术路径,分析YOLO跨域失败背后的标注格式问题,讨论血管半径剖面候选生成方法与不完整金标准下的评估困境。
阅读全文 →

·4 分钟
如何评估AI生成的研究摘要?三个关键维度
AI生成的研究摘要读起来流畅,但事实未必可靠。本文基于Reddit讨论,梳理评估AI研究摘要系统的三个核心维度:来源可追溯性、事实一致性与不确定性处理,并探讨其对深度学习从业者的实践意义。
阅读全文 →

·4 分钟
被忽略,而非被拒绝:小工具代理低注入成功率背后的真相
新研究审计33,000条轨迹发现,小工具代理的低提示注入攻击成功率主要反映代理忽略而非拒绝攻击。系统提示变化可使ASR从0.2%升至43%,且21.7%任务中代理安全但未完成用户请求。呼吁更细粒度评估。
阅读全文 →
·5 分钟
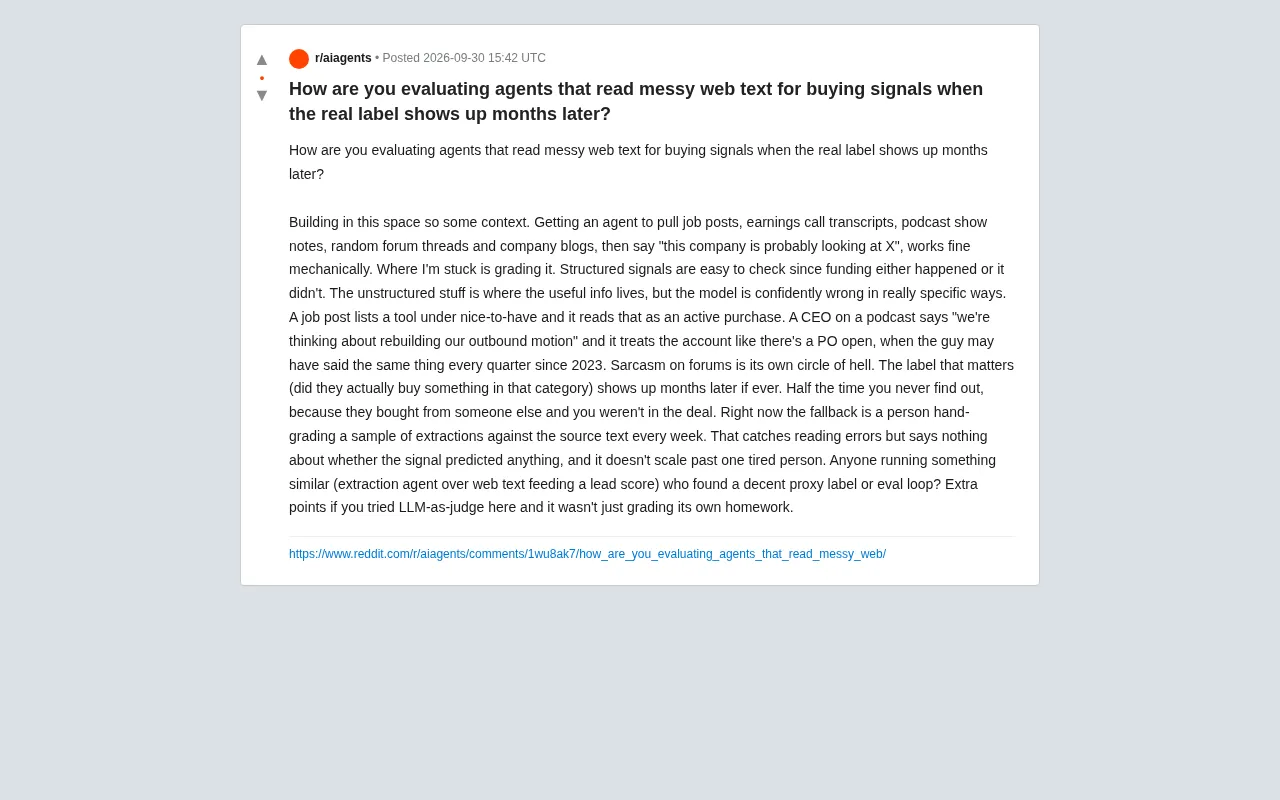
延迟标签困境:如何评估读取网络文本的购买信号Agent
当AI Agent从招聘启事、财报、播客等杂乱网络文本中提取购买信号,而真实采购标签要几个月后才出现时,该如何评估其有效性?本文剖析延迟标签、样本偏差与LLM-as-judge自评等核心难题,并梳理代理标签、置信度校准等破局思路。
阅读全文 →
·6 分钟
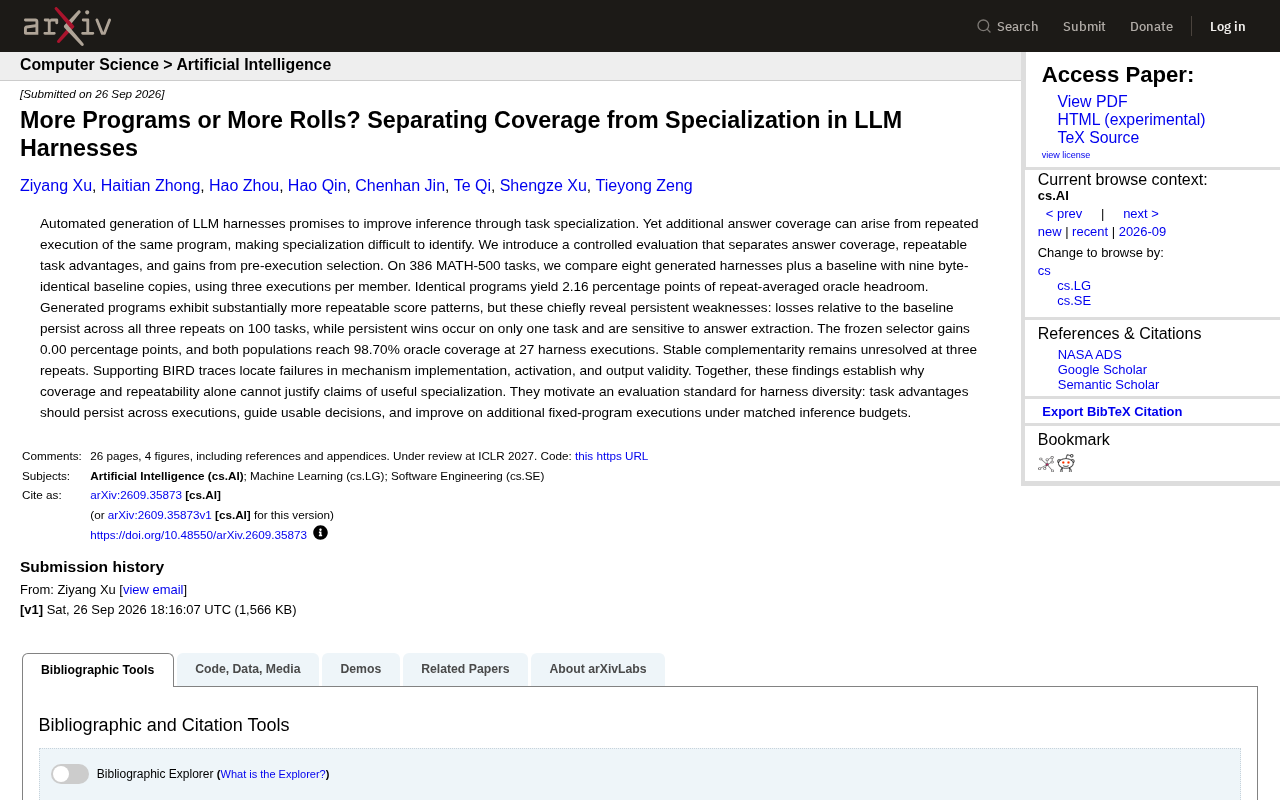
更多程序还是更多重复?拆解LLM Harness的覆盖率与专业化
arXiv新研究通过受控实验拆解LLM harness的答案覆盖率与专业化收益,发现重复执行贡献2.16个百分点,而生成程序的可重复模式主要暴露持续弱点。文章解读其评估方法与对AI推理框架的启示。
阅读全文 →