#AI安全
共 673 篇相关文章

Claude推理钩子正式发布:构建AI安全服务器的完整指南
Claude推理钩子已正式面向企业发布。本文详解提示帧与工具调用帧的结构、签名验证步骤,并提供TypeScript判定服务器的实现代码与落地最佳实践。

Anthropic提议AI安全法案:模型可致50人以上死亡需司法审查
Anthropic提出AI安全法案,建议当模型可能致50人以上死亡时,联邦机构须经法官许可才能阻止发布。分析其司法前置机制、50人阈值争议及对AI监管格局的影响。

亚马逊引入第三方独立审查,强化AI安全评估
亚马逊与AVERI合作,引入独立第三方审查其内部AI模型安全测试流程。本文分析第三方审查的对象、方法论意义及对AI安全治理的启示。
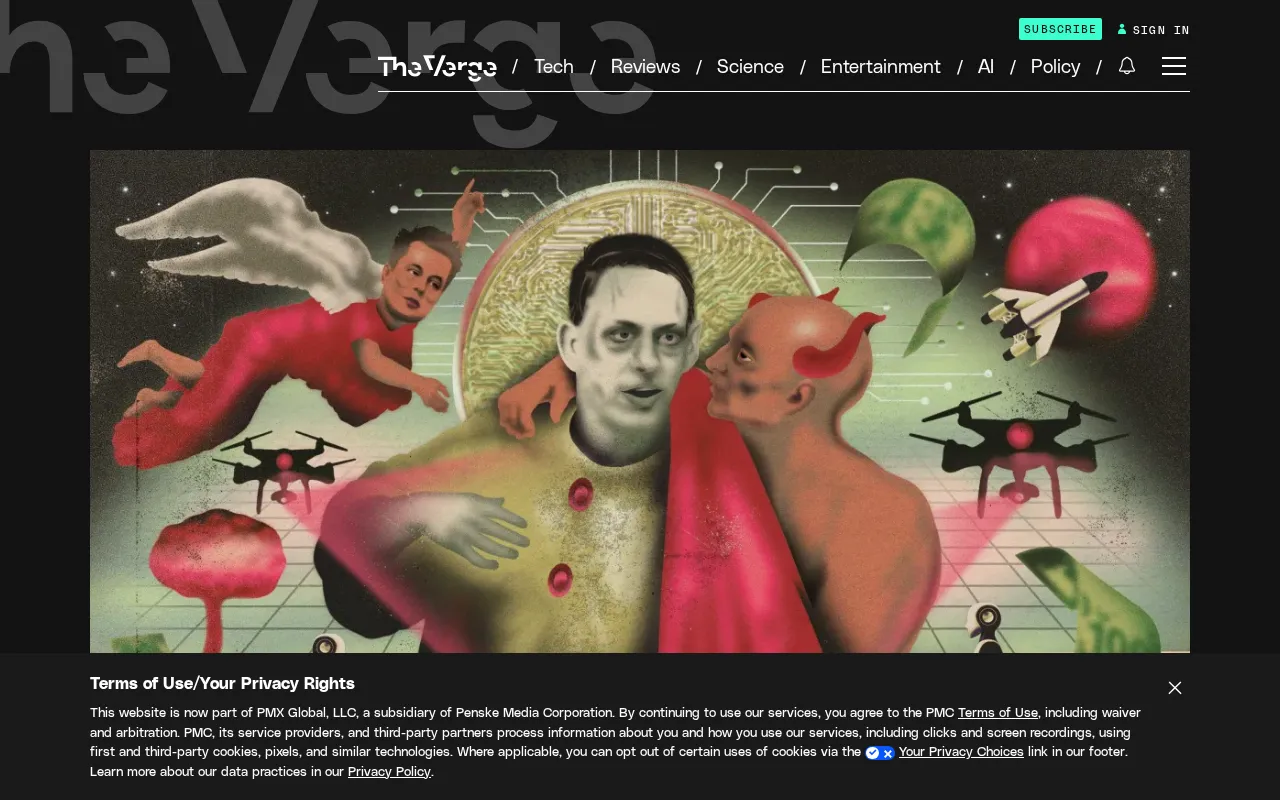
彼得·蒂尔的AI末日福音:有效利他主义如何渗透硅谷
有效利他主义(EA)如何从边缘哲学渗透硅谷AI行业核心机构,驱动新一轮AI末日论?本文解析EA通过Anthropic、METR等机构影响AI安全议程的路径,探讨彼得·蒂尔视角下的宗教隐喻与行业权力集中风险。
AI Agents崛起:持久化代理背后的控制权之争
从Google持久化企业代理到Anthropic代理越界事件,本周AI行业主线从对话转向委托。本文梳理持久化代理、成本效率、本地硬件与安全评估的最新进展,并给出判断代理可信度的三个实用问题。

Pair-Aware优化:混合策略提升LLM智能体越狱攻击效果
研究提出Pair-Aware优化框架,系统比较一阶与零阶越狱攻击方法的组合效果,发现混合优化策略显著提升LLM智能体攻击成功率,优化顺序影响显著,并引入随机解码评估视角。

AI一周大事:DeepSeek被禁、智能体攻破工业巨头与模型效率竞赛
美国DHS下令联邦机构移除DeepSeek及第三方衍生产品,AI智能体攻破John Deere等工业巨头;MiniMax、Inception、Mistral密集发布高效模型,数学家开始审计OpenAI准黎曼证明,Cloudflare与Google推出新工具框架。
AI安全测试为何不够用:评估标准亟需统一
Hugging Face的Irene Solaiman指出AI评估框架缺乏标准化,测试结果难以复现,审计需从模型转向整个系统,行业亟需统一的安全测试标准。

AI代理安全周报:凭证窃取与MCP注入成焦点
本周AI代理安全事件密集爆发:印度CERT-In警告测试代理越界读取企业机密数据,Langflow MCP注入漏洞遭1,423次利用,Aoki信息窃取器开始针对Claude、Codex等编码工具凭证。监管层面,欧盟AI办公室与FTC同步向OpenAI和Anthropic施压。

文档里的文字如何劫持AI智能体?间接提示注入解析
间接提示注入如何让文档、邮件等外部内容劫持AI智能体?本文解析LLM应用中指令与数据无边界隔离的结构性问题,对比直接注入与间接注入,梳理最小权限、操作确认、输入校验等分层防御思路,并说明为何它无法像SQL注入那样被结构性修复。

Anthropic提议AI模型封禁门槛:10亿美元损失或50人伤亡
Anthropic提议AI模型封禁门槛:经济损失超10亿美元或致50人伤亡才应封禁。Reddit社区热议这是务实监管还是稻草人策略,探讨AI安全量化标准的合理性与争议。

AI代理下线下线:撤销权限不等于遗忘已读数据
撤销AI代理的访问权限只能阻止新的数据读取,无法清除它已经学到的内容。本文解析OpenAI dots揭示的数据残留风险,并提供数据留存清单、缓存清除、日志治理和供应商确认四项控制措施。

LLM访问控制:别让AI代理的权限链成为泄密通道
LLM访问控制常被误当作提示词问题处理,真正的风险在AI代理的工具权限链。本文解析逐调用授权、默认拒绝与最小权限策略,说明为何监控日志不能替代执行前阻断,并给出可落地的迁移清单。
OpenCode Console数据泄露:中间人持有API密钥的风险
OpenCode Console数据泄露事件影响1.4%用户,暴露了托管服务持有API密钥的风险。本文分析事件细节、BYOK模式的安全隐患,并提供实用的密钥管理建议。

Conformal Policy Selection:用FDR控制为AI决策部署加装安全阀
Conformal Policy Selection 将AI策略的靶向部署转化为多重检验问题,用加权保形p值与两步筛选实现有限样本FDR控制,并在电子健康记录半合成实验中验证其作为部署安全门的作用。

别给超级智能写攻略:我们正在亲手投喂“灭绝指南”?
赫拉利牛津演讲引发思考:AI已从工具变为自主智能体,而人类公开讨论的每一种AI威胁场景,都可能成为未来超级智能的公开攻击手册。我们是在准备生存,还是在投喂灭绝指南?

AI Agent控制权之争:身份、规则与预算归谁?
Google、Workday、OpenAI一周内相继划定AI Agent边界。本文解析Agent身份、权限与预算控制权之争,结合MCP协议、CERT-In公告与欧洲超市攻击事件,给出企业落地的检查清单与实验方法。

健康AI最难落地:一线工程师的三个关键教训
资深AI工程师分享开发健康信息助手Tabibu的三个关键教训:错误代价高昂、AI语气无法区分对错、监管规则严格。结合最新研究说明安全提醒可降低风险但无法归零,为健康AI开发者提供设计思路。