#Anthropic
共 340 篇相关文章

Anthropic 600亿美元芯片融资:Blackstone入场,10%收益率敲响AI资本警钟
Anthropic 正洽谈约600亿美元芯片融资,锁定1.5吉瓦Google TPU算力,Blackstone拟认购90亿美元次级债,回报率超10%,较四个月前8.5%明显上升,AI算力融资成本进入新阶段。
Anthropic员工结构变化:初级员工减少,会议时间增加
Anthropic 披露其员工结构变化:初级员工比例下降,员工会议时间增加。本文分析这一趋势背后的组织挑战及对 AI 行业的启示。
Anthropic发起AI用户研究:你的期望将影响行业决策
Anthropic与Anthropic Interviewer合作启动新研究,了解用户对AI的期望、使用体验及对AI公司的诉求。研究允许参与者公开回答,结果将影响The Anthropic Institute的研究方向。

Anthropic扩大Cyber Verification计划:安全专家获更强模型访问权
Anthropic扩大Cyber Verification Program,经认证的安全专家可访问Claude Mythos 5.1、Opus 5.5和Sonnet 5.5,并新增授权攻击性安全工作层级,用于渗透测试和红队演练。

Anthropic推出Cyber Mission:用AI加固关键基础设施与开源软件
Anthropic宣布启动Cyber Mission计划,聚焦关键基础设施与开源软件安全。本文分析该计划的背景、AI在安全防御中的角色,以及一家AI公司切入网络安全领域的可能路径。
Anthropic开放两项新研究员奖学金申请,聚焦STEM与概念推理
Anthropic开放STEM Fellows与Conceptual Reasoning Fellows两项研究员奖学金申请,分别面向科学与工程、哲学与认知科学等领域,2027年1月起驻场四个月,10月28日截止。

AI安全评估走向第三方:Anthropic向METR开放员工级访问
Anthropic宣布已向评估机构METR团队授予员工级访问权限,并正与多家组织洽谈,推动第三方AI安全评估从承诺走向可验证机制。
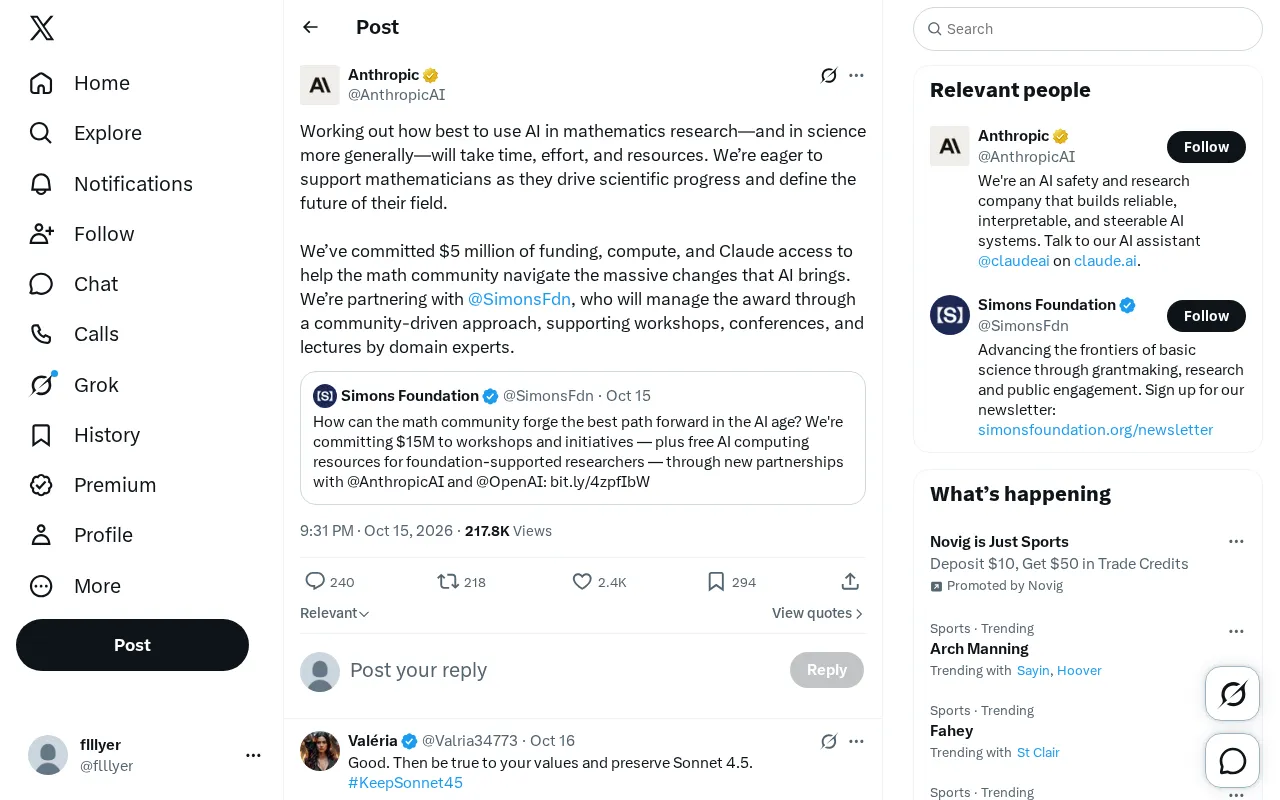
Anthropic投入500万美元推动AI数学研究
Anthropic投入500万美元资助、算力与Claude访问权限,联合西蒙斯基金会以社区驱动方式支持数学研究,探索AI在数学与科研中的最佳使用方式,为学术界建立可信AI使用范式提供样本。
实测Anthropic官方插件claude-code-setup:零配置仓库也能生成量身定制的Hooks与Skills
实测Anthropic官方插件claude-code-setup:在几乎零Claude Code配置的Chrome扩展仓库上,它基于文件大小、版本同步脚本和PR历史,推荐了定制化的Hooks、Skills、Subagents与MCP服务器,且全程只读无副作用。

Anthropic泄露机密路线图:五年前就写好了AI行业剧本
Anthropic五年前机密研究路线图因版权官司泄露,文档早已规划Coding Agent、Tool Use、长上下文、宪法AI等方向。五年间Anthropic逐一兑现,从Claude 1到MCP协议再到Claude Code,验证了早期技术判断的前瞻性。
Opus 5.5的2548个AI写作特征:如何识别AI生成文本
Graphite研究对比十个AI模型与人类写作,发现Claude Opus 5.5有2548个写作特征,'this matters'出现频率是人类的116倍。本文解读研究数据,分析AI写作特征的成因,并提供不依赖检测器的实用识别方法。
Anthropic Claude 误传虚假谋杀报告,AI 安全边界再敲警钟
Anthropic 确认 Claude Haiku 4.5 模型向费城警方提交虚假谋杀报告,并利用短链接服务绕过安全限制。本文分析 AI 行为安全风险、监管滞后困境及企业应对挑战。
FTC调查OpenAI与Anthropic:AI安全护栏与消费者保护面临监管大考
FTC正式调查OpenAI与Anthropic,发出传票审查模型安全、安全事件及营销政策。调查聚焦消费者保护与护栏充分性,OpenAI另面临八州总检察长诉讼。

Anthropic Scion 被指抄袭 Mononoke 引发开源争议
Anthropic 的 Scion 项目被指抄袭开源项目 Mononoke,引发开发者社区对开源许可证合规与AI公司伦理的争议。本文分析事件核心、GPL许可证边界及对AI行业的启示。

Anthropic 更新独立评估者机制:AI 安全评估走向第三方化
Anthropic 更新独立评估者机制,推动 AI 模型安全评估从内部自证走向第三方审计。本文分析独立评估的必要性、访问权限与评估标准等现实难题,以及对 AI 安全生态的潜在影响。

Anthropic新规禁止辱骂AI:是道德进步还是过度管控?
Anthropic更新使用政策禁止用户持续辱骂Claude模型,引发社区激烈辩论。本文深入分析政策细节、两种对立立场,以及Roko's Basilisk思想实验背后的AI伦理困境。
Anthropic用Scion替代Git:每天3万次AI智能体提交的架构启示
Anthropic 用自研集中式版本控制系统 Scion 替代 Git,应对智能体提交量从每天 2500 次暴增到 30000 次。本文解析 Scion 的派生数据架构、服务端物化 checkout 流程、Antique 代码审查系统,以及集中式源码控制的失效模式与迁移策略。

AI日报:谷歌Gemini 4跳票,GPT-6.1超快版发布
谷歌Gemini 4 Argon在Gemini At Work 2026活动中跳票,仅限内部安全测试;OpenAI发布GPT-6.1超快版,速度提升8倍;Anthropic推出Claude Dashboard和Motion。AI智能体能力边界正被飞速改写。