#Claude
共 152 篇相关文章
 产品体验
·5 分钟
实测15款大模型开发B站首页:GPT登顶,国产模型差距明显
用同一套提示词让15款主流大模型一次性开发B站视频平台应用,实测ChatGPT、Claude、Gemini及国产模型的真实编程能力。详细对比前后端表现、指令遵循度与架构设计,附分层使用策略推荐。
阅读全文 →
 产品体验
·4 分钟
Claude Opus 4.6 vs GPT 5.3编程实战对决:谁是AI代码之王
技术博主ThePrimeagen用相同的Rust+JSX终端应用任务实测Claude Opus 4.6与GPT 5.3 Codex编程能力。GPT以更精简的代码实现了真正的JSX编译,略胜一筹。更深刻的洞察是:AI对程序员是乘法效应,你的工程素养才是决定性因素。
阅读全文 →
 教程攻略
·7 分钟
Claude Opus 4.7国内合规使用方案实测指南
阅读全文 →
 产品体验
·4 分钟
Claude Sonnet 4.5 vs GPT-5 Codex:软体物理编程实战对决
深度对比Claude Sonnet 4.5与GPT-5 Codex在C++软体物理编程中的表现,通过复刻经典游戏Terep 2的驾驶模拟效果,从地形渲染、物理引擎到碰撞检测全面评测两大AI编程助手的真实能力。
阅读全文 →
 教程攻略
·7 分钟
Cursor+Claude AI编程入门:零基础快速上手完整指南
详解Cursor AI代码编辑器搭配Claude模型的使用方法,涵盖智能代码生成、Agent模式、定价方案及实战技巧,帮助零基础用户快速掌握AI编程工作流。
阅读全文 →
 科技前沿
·5 分钟
Opus 4.7快速模式登陆Windsurf:速度提升2.5倍,智能不减
Claude Opus 4.7快速模式正式上线Windsurf编程工具,输出速度提升约2.5倍且保持完整智能水平。本文解析该更新对AI辅助编程体验的实际影响及Windsurf的竞争策略。
阅读全文 →
 教程攻略
·8 分钟
AI工具会员充值方式对比:信用卡、礼品卡与代充平台优劣分析
详细对比国内用户订阅Claude、ChatGPT等AI工具的三种充值方式:国际信用卡、App Store礼品卡和第三方代充平台,分析各自优缺点、安全风险及实用建议,帮你选择最适合的付费方案。
阅读全文 →
 科技前沿
·2 分钟
Project Glasswing扩展:150家机构获Claude Mythos访问权
Anthropic宣布扩展Project Glasswing计划,将Claude Mythos Preview访问权限延伸至全球15个国家约150家组织机构,体现其渐进式AI部署策略与国际化布局。
阅读全文 →
 观点碰撞
·10 分钟
HTML正在取代Markdown?AI输出格式之争深度解析
Anthropic团队宣称HTML比Markdown更适合AI输出,Karpathy表示认同。本文深度解析HTML在信息密度、交互能力、可视化方面的优势,以及版本控制、Token效率等局限性,探讨AI输出格式的未来演进方向。
阅读全文 →
 行业洞察
·9 分钟
Claude新政解读:专用月度额度实为AFK用例大幅削减
深度解读Anthropic最新Claude订阅政策变化:程序化调用专用额度看似福利,实则大幅削减AFK自动化工作流可用量。分析Human-in-the-Loop与AFK场景的额度拆分逻辑、对开发者的实际影响及应对策略。
阅读全文 →
 科技前沿
·10 分钟
Anthropic源码泄露:未发布模型代号与隐藏功能深度解析
Anthropic因Claude Code的Source Map文件意外泄露完整源码,曝光了代号Capybara的百万Token模型、Opus 4.7与Sonnet 4.8版本号、卧底模式指令,以及Buddy电子宠物、Kairos自主智能体等未公布功能,揭示其从AI助手向全天候AI伴侣转型的战略野心。
阅读全文 →
 行业洞察
·8 分钟
AI账号轮换工具的风险揭秘:灰产背后的安全隐患
深度解析AI额度破解工具的运作模式,揭示账号轮换灰产背后的法律合规风险、数据泄露隐患,并提供API付费、订阅升级等正当替代方案。
阅读全文 →
 产品体验
·7 分钟
五大AI模型做游戏实测对比:零基础编程谁最强
实测DeepSeek R1、Claude Sonnet 3.7、ChatGPT o3 Mini、Grok 3、通义千问五大AI模型零基础做贪吃蛇游戏,从基础功能到自定义弹球机制,全面对比各模型编程能力与设计感,帮你找到最适合AI游戏开发的工具。
阅读全文 →
 科技前沿
·6 分钟
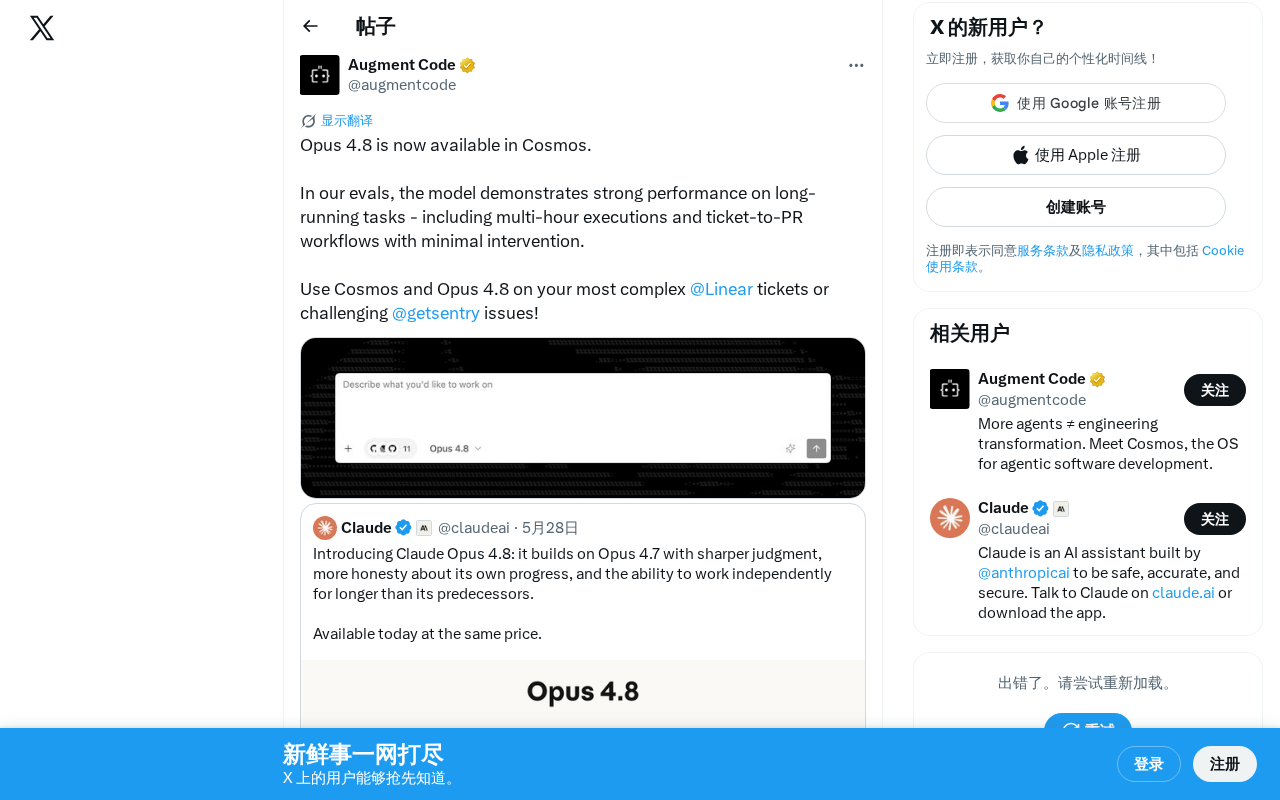
Opus 4.8登陆Cosmos:长时间任务自主执行能力解析
Claude Opus 4.8模型正式上线Cosmos平台,支持多小时连续任务执行和ticket-to-PR端到端工作流,与Linear、Sentry深度集成,大幅减少人工干预,标志着AI编程助手进入自主执行新阶段。
阅读全文 →
 科技前沿
·6 分钟
Kiro停止向中国用户提供Claude模型服务:影响与应对方案
Kiro官方宣布停止向中国用户提供Claude模型和Auto Agent功能,本文详解受影响范围、官方替代方案、付费用户退款政策,以及国内开发者的实用应对策略。
阅读全文 →
 科技前沿
·5 分钟
Claude Opus 4.8思考力度校准解析:AI推理模型的关键优化方向
Anthropic发布Claude Opus 4.8,重点优化思考力度校准能力。本文深入解析什么是思考力度校准、为何它对AI推理模型至关重要,以及这一技术方向对行业竞争格局的深远影响。
阅读全文 →
 科技前沿
·4 分钟
Claude Opus 4.8发布:细微差别理解与对话自然度全面升级
Anthropic正式发布Claude Opus 4.8,基于用户反馈实现三大核心改进:更好的细微差别理解、更自然的对话体验、更强的全场景协作能力,覆盖编程到知识工作全链路。
阅读全文 →
 产品体验
·8 分钟
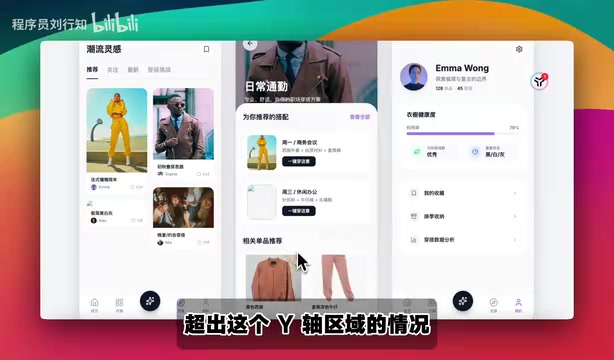
Claude Opus 4.8 实测:游戏开发与UI还原能力全面评估
深度实测Claude Opus 4.8在2D塔防、3D游戏开发、UI还原、工具生成等场景的真实表现,与Opus 4.7对比分析,附详细评分与实际案例截图。
阅读全文 →

