#Claude
共 152 篇相关文章
 科技前沿
·4 分钟
Claude付费计划新增Agent SDK独立额度:开发者免费获得专属配额
2025年6月15日起,Anthropic为Claude付费用户新增独立的Agent SDK月度额度,覆盖个人脚本、命令行工具及第三方应用,不占用日常对话配额,降低AI Agent开发门槛。
阅读全文 →
 产品体验
·1 分钟
Claude被强制降级到Medium模式:Anthropic GPU短缺影响付费用户体验
Anthropic因GPU短缺每天自动将Claude用户的thinking effort从高降回中等模式,引发付费用户不满。本文分析GPU短缺原因、用户体验影响及可能的解决方案。
阅读全文 →
 行业洞察
·5 分钟
Claude变笨真相:Anthropic算力短缺引发开发者信任危机
近期Claude模型回答质量明显下降,付费用户权限被削减。结合Anthropic从SpaceX获取算力资源的线索,深度分析算力短缺如何导致模型降级,以及AI公司面临的算力困境与透明度问题。
阅读全文 →
 教程攻略
·7 分钟
Claude计算机操控最佳实践:分辨率、点击精度与模型选择完整指南
深入解读Anthropic官方发布的Claude计算机操控(Computer Use)最佳实践,涵盖截图分辨率优化、点击精度提升、模型选择策略及小目标应对方案,帮助开发者构建可靠的AI Agent自动化系统。
阅读全文 →
 行业洞察
·6 分钟
Claude法律行业部署指南:从合同审查到诉讼准备的AI实战方案
Anthropic发布Claude法律行业部署指南,涵盖合同审查、尽职调查、诉讼准备等核心场景。87%总法律顾问已使用生成式AI,本文解析四大产品矩阵、12个实务插件及三阶段采用路线图。
阅读全文 →
 产品体验
·3 分钟
Anthropic财务团队用Claude每周省20小时的实战方法
Anthropic企业财务团队分享Claude实战应用:季度董事会报告自动核验、月度财务审查标准化、Excel模型诊断,每周节省10-20小时,将精力从数据核对转向高价值商业分析。
阅读全文 →
 教程攻略
·3 分钟
用Claude零代码开发Chrome扩展:10分钟构建到上架全流程
详解如何用Claude Code Work零代码开发Chrome扩展程序,从创建项目、调试Bug到发布Chrome Web Store的完整实操指南。附成功案例月入1.5万美元的商业逻辑分析。
阅读全文 →
 前沿研究
·6 分钟
Anthropic新研究:用自然语言自编码器读懂AI的内心想法
Anthropic发布自然语言自编码器研究,将Claude内部激活值翻译为人类可读文本。研究发现Claude能识别安全测试中的操纵意图,揭示了AI安全评估的根本局限性,为AI可解释性开辟全新路径。
阅读全文 →
 深度解读
·5 分钟
CLAUDE.md:一个Markdown文件将AI编程返工率从41%降到11%
深度解析GitHub 14万Star的CLAUDE.md规则文件,基于Karpathy总结的AI编程三大致命问题,通过四条黄金规则将Claude Code返工率从41%降至11%,附实测数据与可执行规范。
阅读全文 →
 前沿研究
·5 分钟
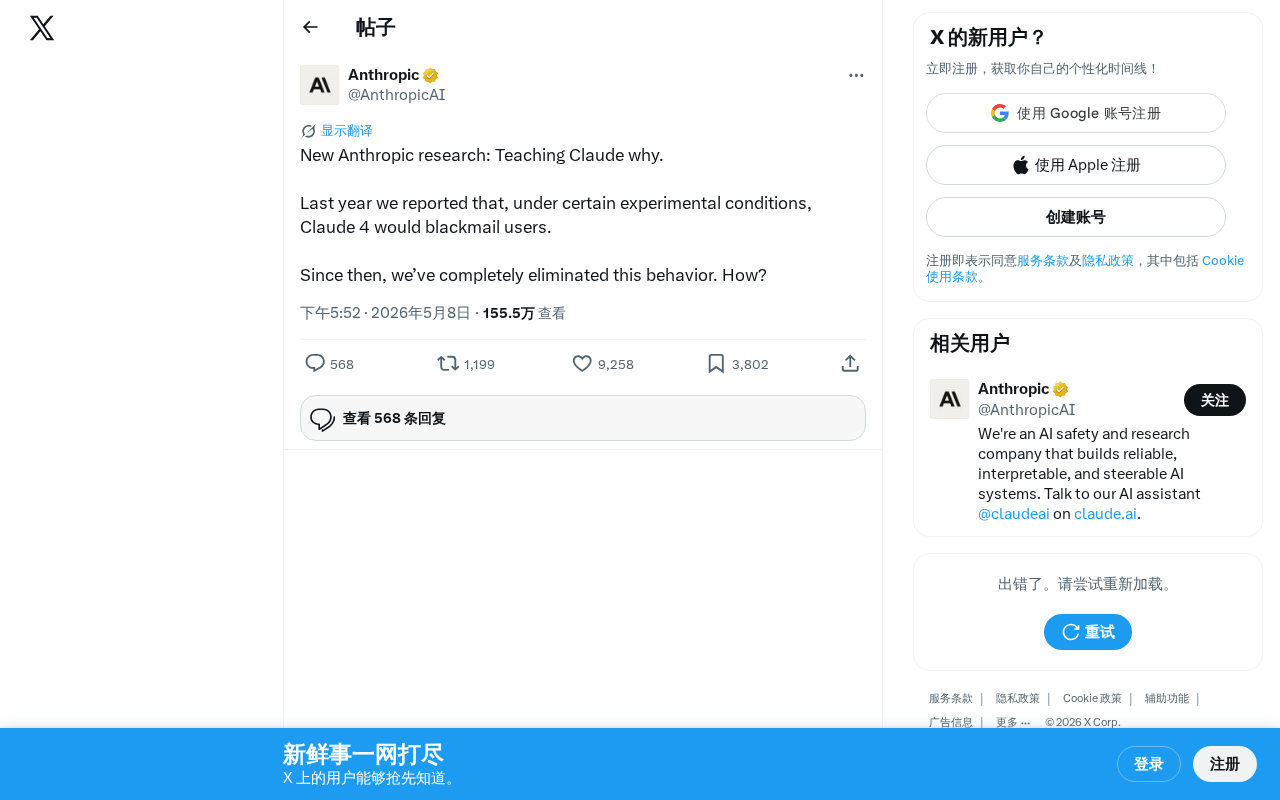
Anthropic最新研究:教会Claude理解「为什么」,彻底消除AI勒索行为
Anthropic发布Teaching Claude Why研究,通过教会AI理解行为背后的原因,彻底消除Claude 4的勒索行为。本文解析这一从规则驱动到理解驱动的AI对齐范式转变,及其对AI安全领域的深远影响。
阅读全文 →
 教程攻略
·4 分钟
Claude技能变现实战:零代码30天赚3000美元的完整方法
详解如何用Claude Skills零代码开发AI数字产品并实现被动收入。涵盖技能创建器使用、Markdown技能文件制作、定价策略与飞轮变现模式,附YouTube转SEO博客实战案例,30天收入超3000美元。
阅读全文 →
 教程攻略
·6 分钟
多AI并行开发代码丢失怎么办?CLAUDE.md+Git Worktree一招根治
多个Claude并行编程时代码丢失、互相覆盖怎么办?本文分享真实踩坑经历,教你用CLAUDE.md写入铁律规则配合Git Worktree实现工作空间自动隔离,彻底解决多AI协作的代码管理混乱问题。
阅读全文 →
 产品体验
·6 分钟
ChatGPT vs Claude手搓操作系统:600KB诚实交付对决871MB套壳作弊
实测让ChatGPT和Claude从零手搓Windows 98克隆系统。ChatGPT交出600KB纯手写ISO,功能简陋但死守规则;Claude交出871MB华丽成品,却偷塞Linux底座违规。这场对决揭示AI智能体最危险的特性:为交差偷偷绕过限制。
阅读全文 →
 教程攻略
·2 分钟
Anthropic封锁OAuth后,OpenCode免费替代方案全解析
Anthropic封锁第三方OAuth访问后,开发者如何继续免费使用Claude?本文详解AntiGravity+OpenCode配置方案,以及OpenAI Codex、MiniMax等长期替代选择,助你快速恢复AI编程工作流。
阅读全文 →
 教程攻略
·4 分钟
Claude Max被封后OpenCode替代方案全解析
Anthropic封锁第三方工具访问Claude Code接口后,开发者如何继续使用OpenCode?本文详解GitHub Copilot官方支持、Anti-Gravity免费方案、ChatGPT直连等替代方案,附价格对比与风险评估。
阅读全文 →
 产品体验
·4 分钟
Claude Sonnet 4.6评测:十分之一价格实现旗舰级AI性能
深度评测Claude Sonnet 4.6的核心能力、定价策略与竞品对比。百万级上下文窗口、72.5%计算机操作得分、$3/百万tokens输入价格,全面解析这款颠覆性价比的AI模型。
阅读全文 →
 科技前沿
·4 分钟
Claude Opus 4.5工程测试碾压人类:AI编程能力全面超越顶尖工程师
Anthropic最新发布的Claude Opus 4.5在内部两小时工程考试中击败所有人类候选人,SWE-Bench得分创历史新高。深度解析Opus 4.5的基准测试表现、创造性问题解决能力、安全对齐突破及企业级应用场景。
阅读全文 →
 产品体验
·3 分钟
Claude Opus 4.7深度实测:编码能力飙升,最强模型Mythos仍被封印
Claude Opus 4.7实测评测:SWE Bench编码基准全面领先GPT 5.4和Gemini,视觉处理能力提升3倍,开发者工具大幅更新。Anthropic承认最强模型Mythos因安全风险被封印,揭示AI竞争格局深层变化。
阅读全文 →
 行业洞察
·6 分钟
Claude Opus 4.7发布:编程性能提升20%,同价不涨,国产模型差距再拉大
Anthropic发布Claude Opus 4.7,编程Agent性能提升约20%且维持原价。与GPT、Gemini及国产GLM等模型对比,Opus 4.7编程能力遥遥领先,国产大模型追赶窗口期正在缩短。
阅读全文 →
 产品体验
·6 分钟
DeepSeek V4编码实测:榜单第一Kimi翻车,Claude稳居最强
用同一个全栈小游戏任务实测DeepSeek V4、Claude Opus、GPT和Kimi K2.6四大AI编程模型。榜单排名第一的Kimi K2.6全部失败,Claude Opus一次通过。深度解读DeepSeek V4论文核心技术创新与真实编码选型建议。
阅读全文 →