#RAG
共 302 篇相关文章
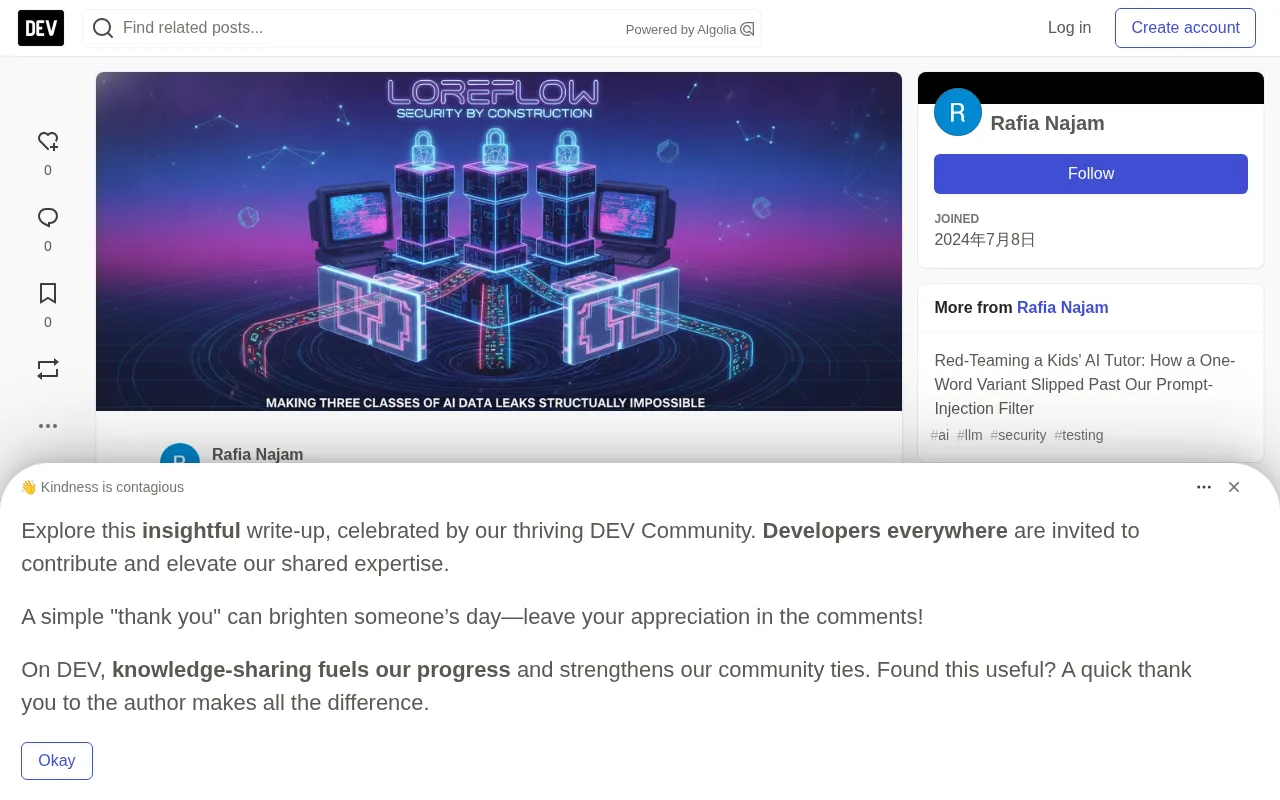
Loreflow架构解析:让三类AI数据泄露在结构上不可能发生
Loreflow通过纯函数证据投影、固定证据预算和逐字段枚举,让跨租户泄露、提示词注入外泄和静默字段泄露三类AI数据安全问题在结构上不可能发生。
AI总犯同样的错?7个工程化方案从根源解决
AI反复犯同样的错误?本文从上下文管理、永久规则、错误日志、RAG检索、自动化验证等7个工程化角度,系统讲解如何让AI真正从错误中学习,不再重复踩坑。

B站748集AI大模型零基础教程:从RAG到Agent实战全解析
B站748集AI大模型零基础教程全解析:从基础认知到提示词工程,进阶覆盖RAG、LangChain、Agent开发,实战落地企业知识库、智能客服、股票分析三大项目。
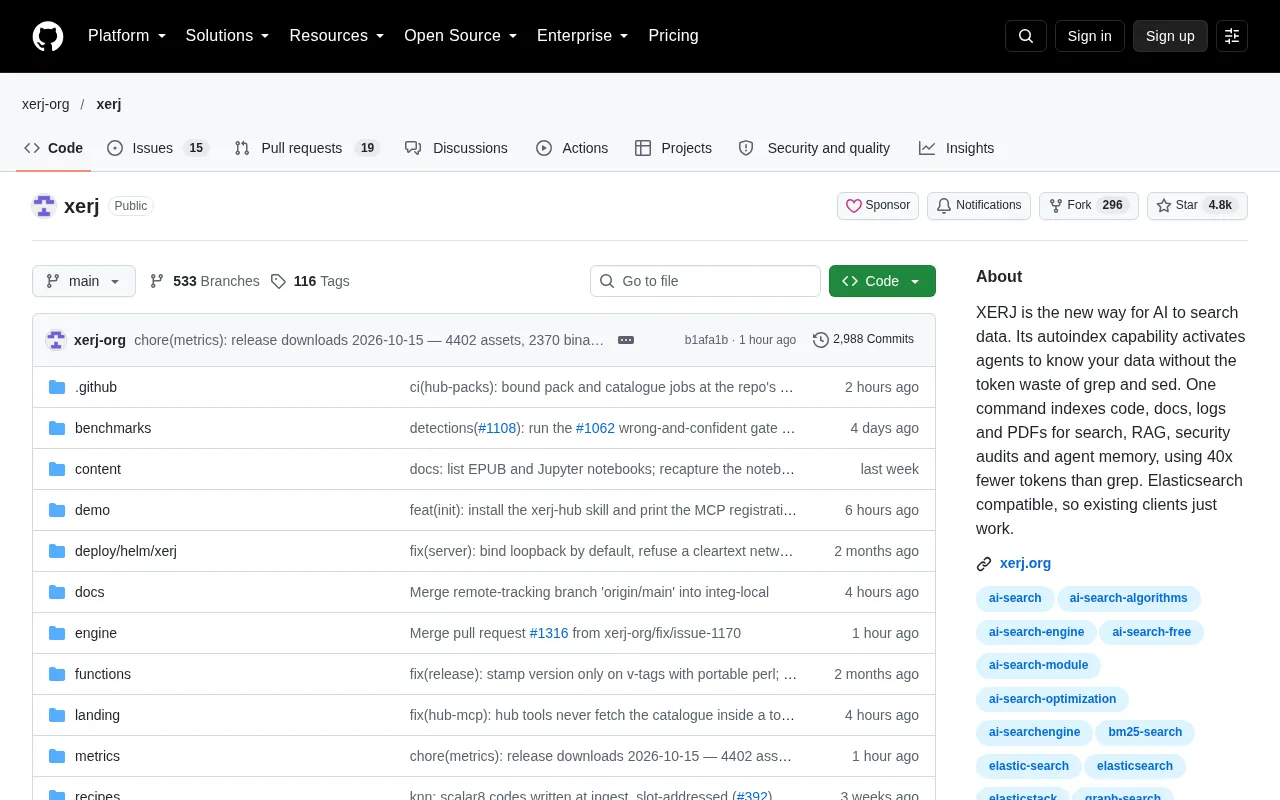
XERJ:AI搜索数据新方式,Token消耗降低40倍
XERJ是GitHub上的开源AI数据搜索工具,通过autoindex自动索引代码、文档、日志和PDF,Token消耗比grep低40倍,兼容Elasticsearch,支持RAG和Agent记忆场景。

别急着上向量数据库:先测好你的检索基线
构建RAG助手不必从向量数据库开始。本文介绍如何用现有全文检索与SQL过滤建立可测量的检索基线,通过五十个真实问题的评估集找出词汇鸿沟场景,再决定是否引入向量检索与混合检索方案。

RAG生产实践:LangChain等框架到底该不该用?
一位开发者分享生产级RAG引擎的实战经验:LangChain/LlamaIndex等框架该在哪些场景使用,哪些场景应该自己写原生代码。文档解析、检索融合、可观测性各有最佳选择。

RAG是什么?用n8n工作流讲透检索增强生成
用图书馆比喻讲透RAG(检索增强生成)的核心原理,并通过n8n工作流完整演示文档加载、Embedding向量化、Pinecone存储和检索生成的实操流程,揭示Embedding模型一致性的重要性。

LLM wiki 对比 RAG:实测用 wiki 替代检索反而更慢
Vellum Labs 在 1,176 行的 itsdangerous 代码库上对照测试 LLM wiki 与 RAG/代理式检索:wiki 首轮每题慢 55%、贵 34%,但能回答代码评审中产生的、源文件里没有的第五个问题。

RAG链路跑通之后:企业级检索增强生成的权限、溯源与数据一致性挑战
RAG 链路跑通只是开始。本文分析企业级检索增强生成落地的三道坎:文档权限控制、答案溯源审计、多源数据一致性,以及为什么这些不是提示词或链路能解决的问题。

RAG分块才是产品,模型只是引擎
RAG系统的效果不取决于嵌入模型,而取决于分块策略。本文解析结构感知分块、表格与脚注陷阱、对抗性评估问题,以及为什么你的分块器才是真正的产品。

Malav Naik:从数据工程到知识图谱驱动的AI系统构建者
Malav Naik,从印度古吉拉特邦到都柏林,拥有五年S&P Global数据工程经验,现为Trinity Care Nursing Homes构建AI自动化系统,其SkillBot项目结合RAG与230万条RDF三元组知识图谱,实现97%事实准确率。

为1万份文档构建RAG搜索引擎,我为何最终放弃答案生成
一位开发者分享为1万份俄语宗教文档构建RAG搜索引擎的实战经验:结构感知分块、混合检索、RRF融合、Cohere重排序,以及为什么最终决定放弃LLM答案生成、只用语义搜索返回原始文档。

RAG评估与幻觉护栏:如何检测和阻止AI幻觉
深入解析RAG系统的评估方法与幻觉护栏机制:如何通过上下文相关性和忠实度分别评估检索与生成环节,用LLM裁判自动拦截不忠实回答,以及建立回归测试集防止系统退化。

长PDF数据提取:LLM直读为何失效及Agentic IDP方案
长PDF整份喂给LLM为何输出糟糕?本文分析四种失败原因、分块方案的盲区,并给出Agentic IDP方案——逐页解析、跨页提取、Schema定义,附成本对比与数据完整性校验方法。

让网页在RAG分块中存活:面向AI引用的写作策略
检索增强生成(RAG)系统按段落而非页面评估内容。本文介绍如何模拟RAG分块、检测薄弱段落,并通过自包含答案、查询式标题、JSON-LD结构化数据等策略,让网页更易被AI搜索引用。

AI自信答错,问题未必出在LLM本身
AI自信给出错误答案,问题可能不在LLM本身。一位开发者拆解品牌营销文案生成系统的三层故障:品牌上下文、检索与生成,指出盲目改提示词治标不治本,先定位故障层才是可靠AI应用的关键。
为AI Agent结构化数据:五种方案与选型指南
为AI Agent结构化数据没有唯一最优方案。本文对比语义模型、知识图谱、RAG、Markdown+grep和开放格式五种方案,基于dbt、微软、Chroma等研究数据,帮你根据问题类型选择正确的数据架构。
复制不等于落地:ASC 破解长文 RAG 的忠实度奖励漏洞
新研究揭示长文 RAG 的忠实度奖励会被"复制"行为钻空子,模型靠粘贴原文拉高分数而非真正落地。论文提出 Authored-Sentence Credit(ASC),将奖励从答案级下放到句子级,在四个模型、五个语料上同时降低错误率并提升支持句数量,且回答质量不输基座模型。

