10年前的老CNN,竟比前沿大模型更会看皮肤癌
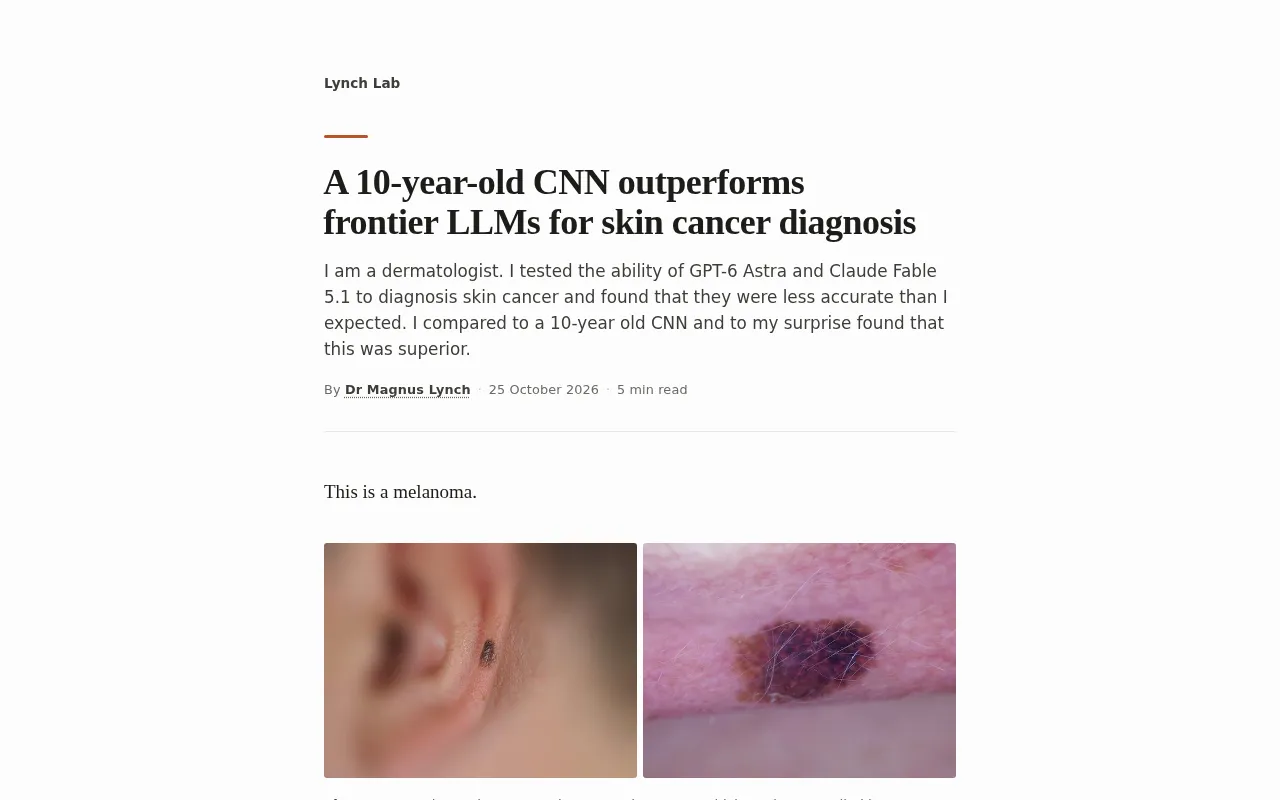
十年专用CNN在皮肤癌诊断上胜过前沿大模型,凸显任务匹配与数据管线价值。
文章围绕 Hacker News 上一则“十年历史 CNN 在皮肤癌诊断任务上优于前沿大语言模型”的讨论展开方法论分析。作者指出,皮肤癌诊断属于细粒度图像分类,CNN 的卷积归纳偏置与病灶局部特征高度匹配,而通用大模型的视觉编码器对医学影像的领域偏移更敏感。老模型的竞争力很可能来自多年迭代的数据治理管线,而非架构本身。文章进一步强调,任何“A 打败 B”的结论都高度依赖评测集构造,需警惕数据泄漏与类别不平衡。对从业者的启示是:垂直领域选型应优先评估任务匹配度、数据管线和可解释性,而非单纯追逐模型新旧。
一个反直觉的对比结果
Hacker News 上一条讨论引发关注:一个已有十年历史的卷积神经网络(CNN),在皮肤癌诊断任务上表现优于当前的前沿大语言模型。原始帖子只有一句结论和 61 个点赞、25 条评论,信息量不大,但它抛出的问题值得深挖——当所有人都在追逐通用大模型时,那些被时间验证过的专用小模型,是否被低估了?
需要说明的是,原始素材并未披露具体的模型名称、数据集、评测指标和实验设置,因此本文不引用具体数字,而是围绕这一结论展开方法论层面的分析,并标注哪些判断属于合理推断。
为什么专用 CNN 能赢过通用大模型
图像任务的"先天差异"
皮肤癌诊断本质上是细粒度图像分类问题:病灶的边界形态、颜色分布、纹理结构决定了良恶性判断。CNN 的卷积核天生适合提取这类局部空间特征,而多数通用大语言模型的主战场是文本,即便具备多模态能力,其视觉编码器往往是在通用图文数据上预训练的,对医学影像的领域偏移(domain shift)更为敏感。
一个十年前针对皮肤镜图像专门训练的 CNN,可能在架构上并不先进,但它的归纳偏置与任务高度匹配,加上训练数据分布贴近临床场景,反而形成了优势。
领域偏移(domain shift) 指模型在训练数据分布与部署数据分布不一致时出现的性能衰减。以皮肤镜图像为例,通用图文预训练中极少出现高质量、多肤色、标准化采集的病灶影像,模型学到的视觉表征会与临床图像存在系统性偏差。CNN 的优势在于其归纳偏置(局部连接、权值共享、平移不变性)与图像的二维空间结构天然契合,且可以针对目标域做端到端微调,从而把领域偏移压缩在可控范围内。相比之下,多模态大模型的视觉编码器通常冻结或仅做轻量适配,领域适应能力受限。
十年积累的不只是模型,还有数据管线
这类结论背后通常隐藏着一条容易被忽略的事实:老模型的竞争力往往来自配套的数据治理。皮肤镜图像的采集设备、光照条件、肤色分布、标注规范,都会显著影响模型表现。一个经过多年迭代的专用系统,其数据清洗和标注流程可能比模型结构本身更值钱。
换句话说,比较的未必是"CNN vs LLM",而是"成熟医学影像管线 vs 通用多模态能力"。这个视角下,结论就没那么令人意外了。
数据治理管线 包括采集标准化、去重、标注规范、质量抽检和版本管理。在医学影像中,同一患者的多个病灶、不同设备与光照条件、标注者间分歧都会引入噪声。成熟的管线通过患者级划分、多标注者一致性校验、图像质量筛查等手段降低这些风险,使模型学到的是病灶本身的判别特征,而非采集偏差。这也是为什么在复现或对比研究时,数据管线的透明度往往比模型架构更能决定结论的可信度。
这对 AI 应用落地意味着什么
通用大模型不是万能解
Hacker News 评论区的一个常见分歧是:这能否说明大模型被高估?更准确的理解是,任务专用性仍然是模型选型的首要变量。在医学影像、工业质检、遥感解译等垂直领域,一个参数量小、推理成本低、可解释性强的专用模型,可能比调用通用大模型 API 更划算,也更容易通过监管审查。
评测基准比模型本身更关键
任何"A 打败 B"的结论都高度依赖评测设置。皮肤癌诊断的常见陷阱包括:数据集是否存在重复样本、良恶性类别是否平衡、是否按患者而非图像划分训练测试集。如果评测集划分不当,模型可能只是记住了同一患者的相似病灶。原始讨论没有给出这些细节,因此对该结论应保持审慎——它更可能是一个值得复现的研究线索,而非定论。
患者级数据划分 是医学影像评测中的关键设计:若按图像随机划分训练集与测试集,同一患者的相似病灶可能同时出现在两侧,导致模型“记住”患者特征而非学习疾病特征,从而虚高指标。规范做法是按患者 ID 划分,确保测试集患者与训练集无重叠。此外还需报告类别平衡策略、敏感度/特异度、AUC 及置信区间,并说明是否使用外部独立数据集验证,否则“A 打败 B”的结论难以成立。
给技术选型的几点参考
- 先明确任务是否属于窄领域高精度需求,若是,优先评估专用小模型而非直接上通用大模型
- 比较模型时,重点关注数据管线和评测集构造,而不只是架构新旧
- 对"老模型逆袭"类结论,先检查数据集划分与类别平衡,再判断可信度
- 在受监管场景(医疗、金融)中,可解释性和可审计性往往比榜单分数更重要
结语
这条 Hacker News 讨论的价值不在于证明 CNN 优于 LLM,而在于提醒从业者:模型的新旧与任务表现之间没有必然关系。在垂直领域,数据质量、任务匹配度和评测严谨性,常常比参数规模更能决定最终效果。对这类结论保持兴趣,同时保持对评测细节的追问,是更健康的态度。
相关推荐
SEMA-Auto:自主多轮越狱攻击效率与成功率双突破
微软提出 SEMA-Auto 自主多轮越狱攻击方法,通过两阶段训练实现自主终止与高效攻击,在 AdvBench 上以 3 回合达 76% 成功率,超越静态与交互式基线。
宏碁Predator Atlas 8游戏掌机首次登陆美国,独家首发Best Buy
宏碁Predator Atlas 8游戏掌机首次登陆美国市场,Intel Arc G3 Extreme版本将在Best Buy独家销售。本文梳理型号选择、渠道策略与市场竞争格局。
WorkBuddy怎么用?本地AI智能体安装与工作台搭建指南
WorkBuddy是什么?本文整理B站保姆级教程要点,讲清这款本地AI智能体的完整工作流:从官网下载安装、连接器绑定办公软件,到多智能体并行处理文档与数据分析,并对比Codex说明新手选它的理由。