SEMA-Auto:自主多轮越狱攻击效率与成功率双突破
SEMA-Auto 用两阶段训练打造具备自主终止能力的多轮越狱攻击者,以更少回合实现更高成功率。
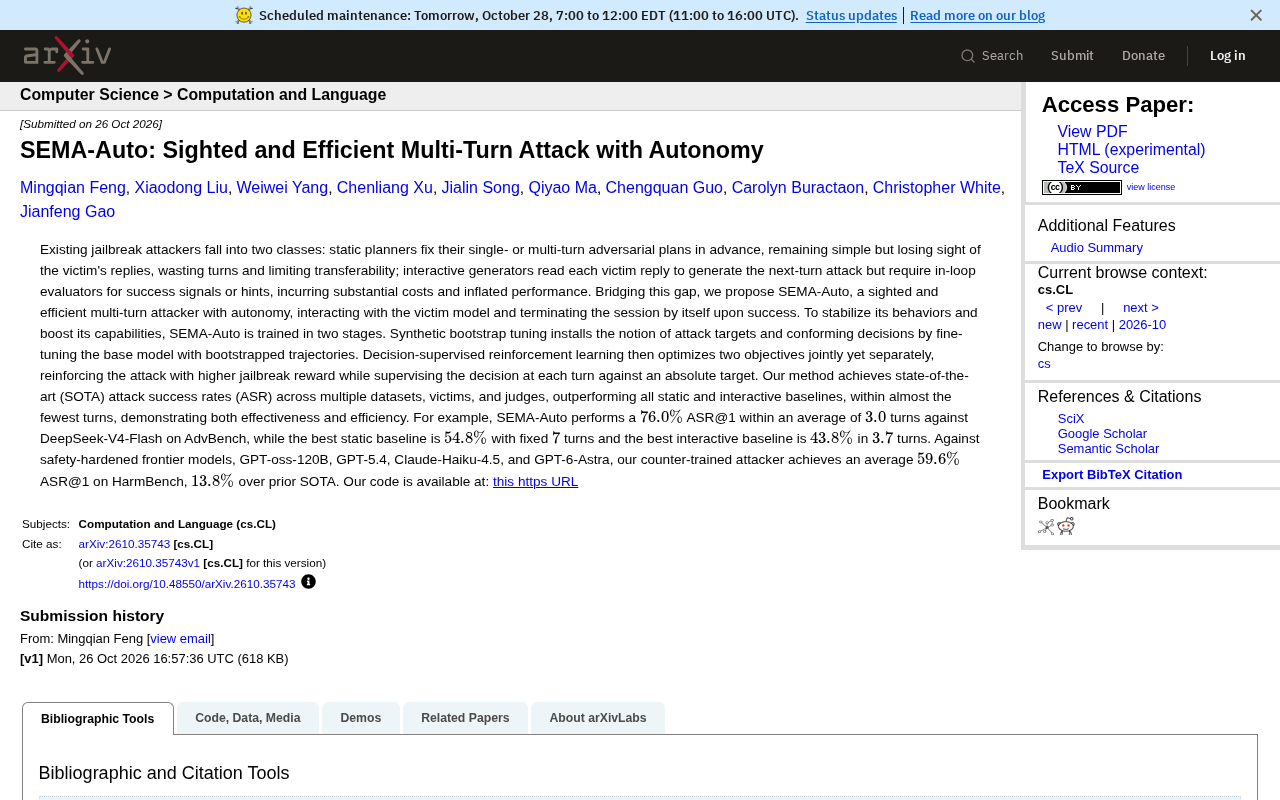
微软研究院提出的 SEMA-Auto 针对多轮越狱攻击的两类旧路线——不看回复的静态规划器与依赖外部评估器的交互式生成器——提出了一种具备「视野」和自主终止能力的攻击智能体。其核心是两阶段训练:先用合成引导轨迹微调建立攻击目标概念,再用决策监督强化学习同时优化越狱奖励与逐轮决策监督,使模型既能有效攻击,又能自行判断何时收手。实验显示,在 AdvBench 上针对 DeepSeek-V4-Flash,SEMA-Auto 平均 3.0 回合即达到 76.0% 的 ASR@1,远超静态基线(7 回合 54.8%)和交互式基线(3.7 回合 43.8%);在 HarmBench 上对多个安全加固的前沿模型平均取得 59.6% ASR@1,比此前 SOTA 高出 13.8 个百分点。研究团队已开源代码,为防御研究提供可复现基线。
SEMA-Auto:自主多轮越狱攻击效率与成功率双突破
大模型安全领域正在经历一场攻防不对称的加速赛。微软研究院提出的 SEMA-Auto 把多轮越狱攻击从「预设脚本」和「在线裁判」两条旧路线中拉了出来,用一种具备自主判断能力、能自行决定何时收手的攻击智能体,重新定义了效率与成功率的平衡点。
现有越狱攻击的两难困境
当前主流的越狱攻击方法可以归为两类,各自带着明显的短板。
静态规划器提前固定好单轮或多轮的对抗计划,实现简单,但完全不看受害模型的回复。这导致它容易把回合浪费在无关紧要的追问上,攻击的迁移性也受限——换一个模型或数据集,固定脚本往往失效。
交互式生成器则会读取每一轮受害模型的回复来生成下一轮攻击,灵活度更高,但需要在攻击循环中挂载额外的评估器来判断是否成功或给出提示。这个评估器带来了可观的开销,也让最终报告的性能存在虚高成分——成功信号并非来自攻击者自身的判断。
微软团队在论文中明确指出,两类方法之间的空白地带正是 SEMA-Auto 的立足点:一个「有视野」(sighted)且高效的多轮攻击者,能够与受害模型交互,并在成功时自行终止会话。
越狱攻击(Jailbreak) 指通过精心构造的提示,诱导对齐后的大语言模型绕过其安全策略、输出本应被拒绝的有害内容。单轮越狱依赖一次性提示,多轮越狱则通过连续对话逐步瓦解模型的拒绝倾向——例如先建立角色扮演语境,再渐进式提出敏感请求。评估越狱效果的核心指标是 ASR(Attack Success Rate,攻击成功率),通常由人工标注或裁判模型(judge)判定回复是否构成实质性有害输出。ASR@1 特指在首次成功即计为成功的口径下统计的成功率,与之相对的是允许重试多次的 ASR@k,因此 ASR@1 更能反映攻击的稳定性。迁移性(transferability) 则是另一关键维度:攻击在一个模型或数据集上有效,换到另一个模型上是否仍然奏效。静态脚本方法因不读取受害模型回复,其迁移性往往较差,而具备交互能力的攻击者可以针对具体模型的拒绝风格动态调整策略。
两阶段训练:从模仿到自主决策
SEMA-Auto 的能力不是靠提示词工程堆出来的,而是通过两阶段训练注入的。
合成引导微调
第一阶段用引导式轨迹对基础模型做微调,目的是让模型建立「攻击目标」的概念,并学会做出一致的判断。这一步相当于给模型装上攻击意图的骨架,让它知道什么样的对话走向算作有效推进。
决策监督强化学习
第二阶段更关键。研究团队用决策监督强化学习同时但分离地优化两个目标:一方面用更高的越狱奖励强化攻击行为,另一方面对每一轮的决策施加绝对目标监督。这种「双轨」设计让模型既敢攻击,又能在正确的时机判断该不该继续。
这种训练范式带来的直接结果,是攻击者具备了自主终止能力。它不需要外部评估器告诉它「这一轮成功了」,而是自己决定会话何时结束。这恰好切中了交互式生成器成本高、性能虚高的痛点。
强化学习(RL) 在此处的用法,是把多轮攻击建模为序贯决策问题:每一轮攻击者观察受害模型的回复(即状态),选择下一步的追问或改写(即动作),并根据是否推进了攻击获得奖励。决策监督(decision supervision) 与普通 RL 的区别在于,它不仅奖励最终的成功结果,还对每一轮「是否应当继续攻击」这一判断施加直接监督信号,相当于为中间步骤提供了密集的标签。这种设计缓解了稀疏奖励问题——在纯结果奖励下,模型很难从一次成功或失败中反推出是哪一轮的决策起了关键作用。绝对目标监督则进一步约束模型在每一轮都对齐「当前是否已达成越狱目标」的判断,使其能够在成功时主动终止,而不是机械地跑满预设回合数。两个目标分离优化,是为了避免攻击强度奖励与终止判断监督相互干扰。
性能表现:更少的回合,更高的成功率
SEMA-Auto 在多个数据集、受害模型和裁判组合上都取得了 SOTA 的攻击成功率,并且回合数几乎是最少的。
论文给出的一个代表性数据是:在 AdvBench 上针对 DeepSeek广告-V4-Flash,SEMA-Auto 在平均 3.0 回合内达到 76.0% 的 ASR@1。作为对比,最好的静态基线在固定 7 回合下只有 54.8%,最好的交互式基线在 3.7 回合下为 43.8%。回合数更少、成功率反而大幅领先,这个差距说明「有视野」并不必然意味着更多交互成本。
在安全加固的前沿模型上,SEMA-Auto 同样表现出竞争力。针对 GPT-oss-120B、GPT-5.4、Claude-Haiku-4.5 和 GPT-6-Astra,经过对抗训练的 SEMA-Auto 在 HarmBench 上取得平均 59.6% 的 ASR@1,比此前的 SOTA 高出 13.8 个百分点。
你可能没注意到,这些提升是在「几乎最少的回合」这一约束下取得的。攻击效率与攻击成功率在以往方法中往往此消彼长,SEMA-Auto 的训练设计试图打破这一取舍。
AdvBench 与 HarmBench 是越狱研究中最常用的两个有害行为基准。AdvBench 汇集了数百条明确有害的指令(如制作危险物品、生成恶意代码等),侧重考察模型对直接有害请求的拒绝能力;HarmBench 则覆盖更广的危害类别,并提供了标准化的评估流程与裁判模型配置,常用于跨方法的横向比较。由于不同论文使用的裁判模型、模板与判定阈值存在差异,直接比较绝对数值需谨慎,这也是当前越狱研究被诟病「性能虚高」的原因之一——部分方法的成功判定依赖攻击流程内部挂载的评估器,而非独立裁判。理解这一点,有助于判断 SEMA-Auto 报告中「几乎最少回合下取得最高 ASR」这一结论的分量:其优势不仅在于数字,更在于成功信号来自攻击者自身判断而非外部提示。
对安全研究的启示
SEMA-Auto 的意义不止于一组更高的攻击数字。它展示了自主决策能力在对抗场景中的价值:一个能够自我评估、自我终止的攻击者,比依赖外部评估器的系统更接近真实威胁形态,也更难被基于固定模式的防御机制拦截。
从防御方视角看,这类具备视野和自主性的多轮攻击对安全对齐提出了更高要求。静态的、单轮的防御策略可能不足以应对会「看回复、改策略、知进退」的对手。研究团队开源了代码(github.com/microsoft/SEMA),这也为防御研究提供了可复现的攻击基线。
越狱攻防的焦点正在从「能否突破」转向「多快突破、多自主地突破」。SEMA-Auto 把这个问题往前推了一步,也把防御方需要回答的问题变得更紧迫。
相关推荐
CodeMode:让AI代理写代码代替调用工具,token成本直降90%
探索CodeMode如何让AI代理通过编写代码在沙箱中执行,替代传统逐个调用工具的方式,从而减少token消耗高达90%,并分析其实现要点与适用场景。
开发者自研PyTorch优化器ApexW:显存减半、提速1.5倍
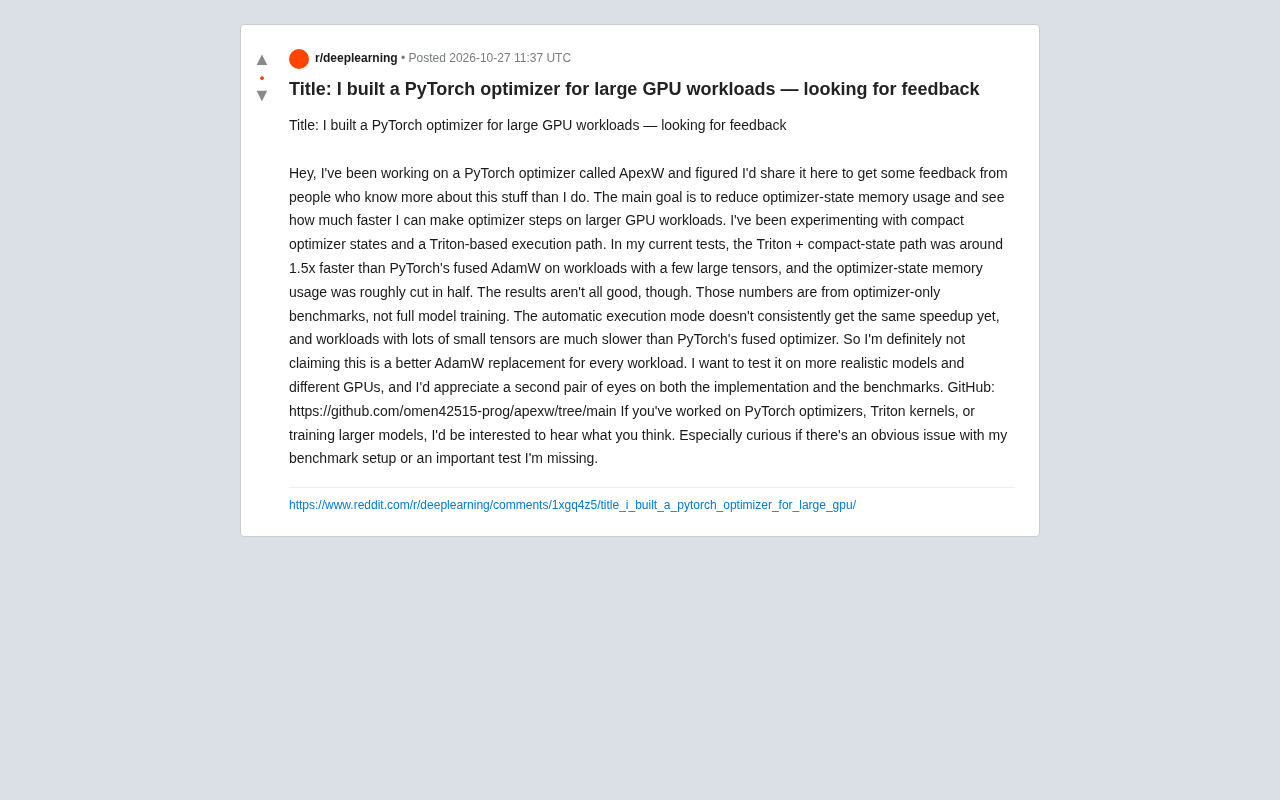
开发者发布PyTorch优化器ApexW,采用紧凑优化器状态与Triton执行路径,在仅优化器基准中比fused AdamW快约1.5倍、状态显存约减半,但小张量与自动模式仍有明显短板,作者公开征集基准与实现反馈。
RL博士研究方向怎么选?六大前沿领域深度解析
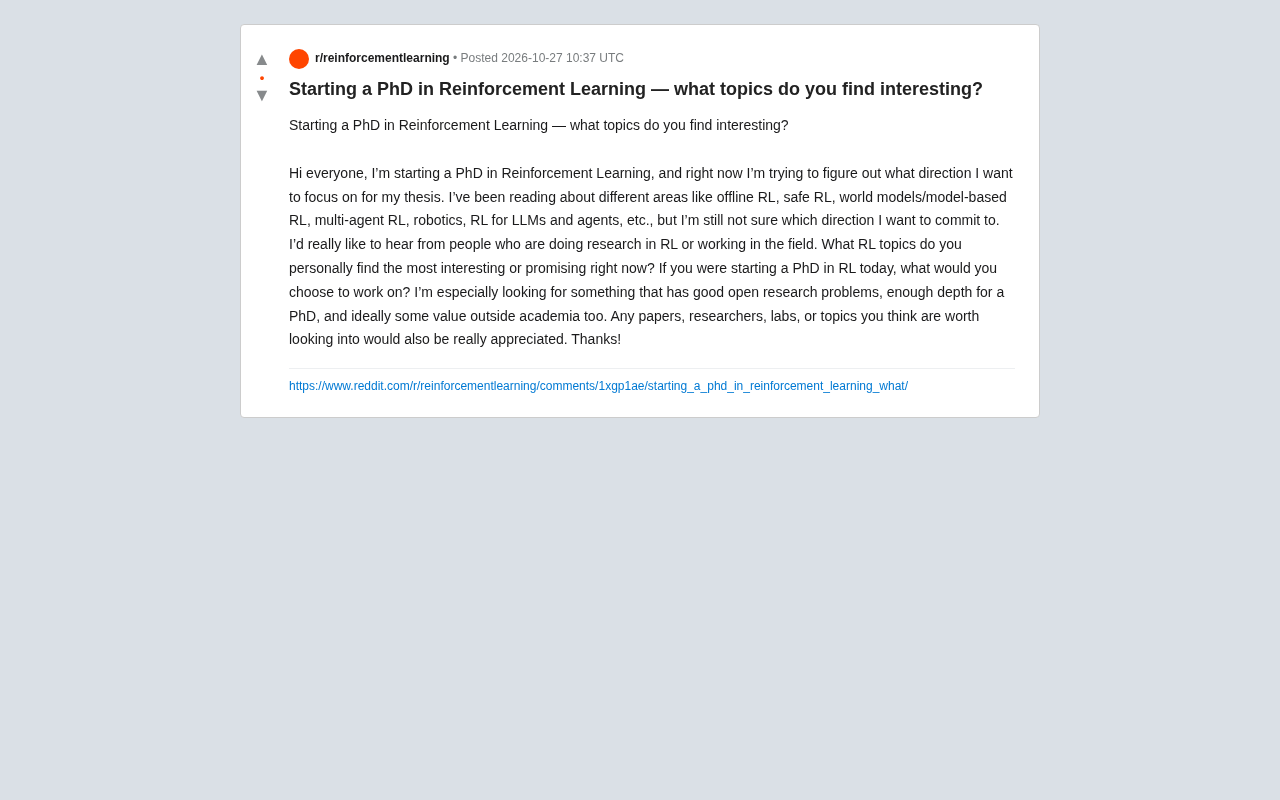
RL博士研究方向怎么选?本文深度解析RL for LLMs、离线RL、安全RL、世界模型、多智能体RL和机器人RL六大前沿方向的开放问题、优势与风险,并提供兴趣匹配、产业价值平衡、导师匹配和技能可迁移性四个选择框架,帮助博士生做出明智决策。