12GB显卡跑Qwen3.8-Flash-Next:自研引擎实现65 tok/s
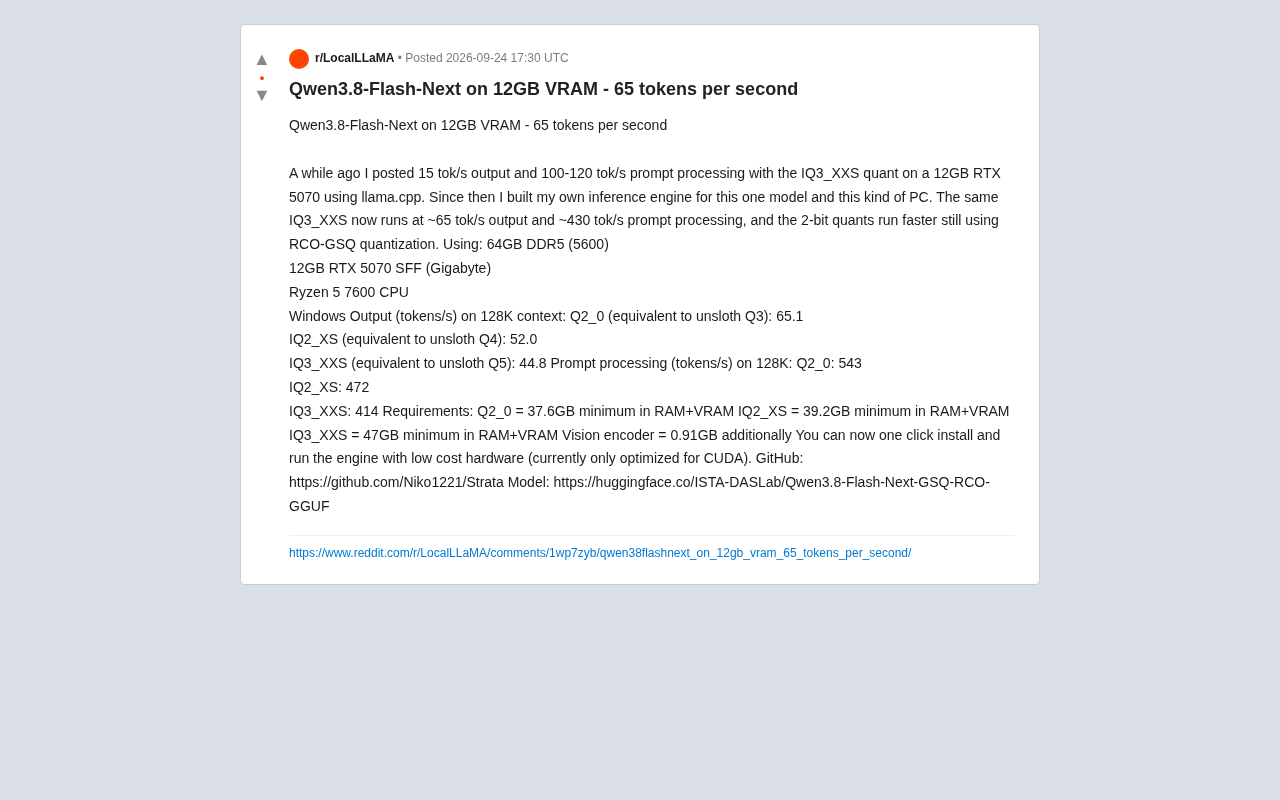
开发者自研Strata引擎,在12GB显存RTX 5070上将本地大模型推理速度从15提升至65 tok/s,较llama.cpp提速近4倍。
一位开发者通过自研专用推理引擎Strata,在配备12GB显存的RTX 5070消费级显卡上运行Qwen3.8-Flash-Next模型,输出速度从此前llama.cpp的15 tok/s跃升至65 tok/s,提示处理速度达543 tok/s,性能提升接近4倍。这一成果的核心在于放弃通用性、针对特定模型与硬件进行深度优化,并结合64GB DDR5系统内存与VRAM协同加载,配合ISTA-DASLab的RCO-GSQ低比特量化技术,使仅12GB显存的中端配置得以流畅运行完整大模型。引擎与量化模型均已开源,支持一键安装,但目前仅限CUDA环境,通用性有限。
一位开发者在Reddit分享了一项引人注目的本地推理优化成果:在仅有12GB显存的RTX 5070上运行Qwen3.8-Flash-Next模型,输出速度达到约65 tokens/s,提示处理速度更是高达543 tokens/s。这个数字对消费级硬件而言相当可观,也再次证明了本地大模型部署正在快速逼近实用门槛。
从15到65 tok/s的性能跃升
作者提到,此前使用llama.cpp运行IQ3_XXS量化模型时,输出速度仅为15 tok/s,提示处理为100-120 tok/s。而在为这一特定模型和这类PC配置专门构建了自研推理引擎后,同样的IQ3_XXS量化速度提升到了约65 tok/s输出、430 tok/s提示处理——接近4倍的性能提升。
这种跃升的关键在于针对性优化。通用推理框架需要兼顾各种模型和硬件组合,而专为单一模型、单一硬件档位打造的引擎可以把每一处调度、内存布局和计算路径都压榨到极致。作者将其命名为Strata引擎,并已开源。
llama.cpp是目前最主流的开源本地大模型推理框架,由Georgi Gerganov于2023年开发,核心优势在于跨平台、跨硬件的广泛兼容性,支持CPU、CUDA、Metal(Apple Silicon)等多种后端。正因为要兼顾如此多的硬件和模型组合,llama.cpp在内存布局、调度策略和计算内核上不得不做出大量通用性妥协,无法对某一特定模型或GPU架构进行极致调优。相比之下,Strata引擎放弃通用性,专门针对Qwen3.8-Flash-Next的模型结构(如注意力头数、层间依赖关系)以及RTX 5070的硬件特性(如Ada/Blackwell架构的Tensor Core利用率、L2缓存大小)进行深度适配,从而在同等量化精度下榨出接近4倍的吞吐量提升。这种"专用引擎 vs 通用框架"的性能差距在工业推理场景中早有先例,此次在消费级硬件上的复现同样具有参考意义。
硬件配置与量化方案
作者的测试平台并非高端配置,反而颇具代表性:
- 显卡:12GB RTX 5070 SFF(Gigabyte)
- 内存:64GB DDR5-5600
- CPU:Ryzen 5 7600
- 系统:Windows
这套配置的总成本在消费级范围内,却能跑起一个需要接近40GB内存+显存的量化模型。核心思路是RAM与VRAM协同:显存不足的部分卸载到大容量系统内存,靠64GB DDR5撑起模型的完整加载。
值得关注的是作者采用的RCO-GSQ量化技术。他提到2-bit量化在这套方案下运行得更快,模型托管在Hugging Face上(ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF),这套量化方法与ISTA-DASLab的研究相关联,指向了更前沿的低比特量化路线。
RCO-GSQ是ISTA-DASLab(奥地利科学技术研究所数据分析与学习实验室)提出的一种面向大模型的低比特量化方案。GSQ(Grouped Sparse Quantization)通过对权重分组并引入稀疏性来降低精度损失,而RCO(Residual Compression and Optimization)则在此基础上对量化残差进行进一步压缩与校正,从而在极低比特率(如2-bit)下保持相对可接受的模型质量。传统的2-bit量化往往因精度损失过大而不可用,RCO-GSQ通过更精细的误差补偿机制改善了这一问题。这也是作者提到"2-bit在这套方案下反而跑得更快"的原因——在精度可接受的前提下,更低的比特数意味着更小的内存带宽压力和更快的矩阵运算,而RCO-GSQ的技术保障使这个精度-速度权衡点得以前移。
具体性能数据
在128K上下文长度下,三种量化档位的表现如下:
输出速度(tokens/s)
| 量化 | 等效精度 | 输出速度 |
|---|---|---|
| Q2_0 | 相当于unsloth Q3 | 65.1 |
| IQ2_XS | 相当于unsloth Q4 | 52.0 |
| IQ3_XXS | 相当于unsloth Q5 | 44.8 |
提示处理速度(tokens/s)
| 量化 | 提示处理 |
|---|---|
| Q2_0 | 543 |
| IQ2_XS | 472 |
| IQ3_XXS | 414 |
内存需求(RAM+VRAM总和)
- Q2_0:至少37.6GB
- IQ2_XS:至少39.2GB
- IQ3_XXS:至少47GB
- 视觉编码器额外占用0.91GB
数据清晰展示了量化档位与速度、精度、内存占用之间的权衡:越激进的量化(Q2_0)速度越快、占用越小,但精度相对更低;IQ3_XXS精度更高,代价是接近47GB的内存门槛和更慢的推理速度。
表中的"等效精度"对比需要额外说明:IQ系列(如IQ2_XS、IQ3_XXS)是llama.cpp引入的重要量化(Importance Quantization)格式,它并非均匀地对所有权重使用相同比特数,而是根据各权重对模型输出的重要性分配不同精度——关键权重保留更高精度,次要权重则被更激进压缩。这使得IQ2_XS虽然名义上是2-bit量化,实际平均比特率略高,模型质量接近均匀4-bit量化(即unsloth Q4)。理解这一点对于解读表格至关重要:Q2_0的"65.1 tok/s"并不意味着它与IQ2_XS使用了等量的信息——Q2_0是均匀2-bit,质量更低但速度最快;IQ2_XS以少量速度代价换来了相当于Q4的有效精度,在速度与质量之间提供了更优的帕累托点。
一键安装的开源方案
对普通用户而言,这项工作最有价值的地方在于易用性。作者表示引擎现已支持一键安装运行,目前仅针对CUDA优化。相关资源均已公开:
- 引擎代码:GitHub上的Strata项目
- 量化模型:Hugging Face上的GSQ-RCO-GGUF版本
这意味着拥有类似配置的用户可以直接复现这套性能,无需自己折腾复杂的编译和调参流程。
需要提醒的是,这套方案高度针对特定模型和硬件优化,通用性有限。它更像是一个"如何把消费级硬件的推理性能推到极限"的范例,而非可以随意迁移到其他模型的通用框架。当前仅支持CUDA也意味着AMD或Apple Silicon用户暂时无法受益。
本地推理的意义
这类工作的价值在于,它不断压低运行大模型所需的硬件门槛。当一张12GB的中端显卡配合大容量内存就能以65 tok/s流畅运行支持视觉的Qwen3.8-Flash-Next时,本地部署对于注重隐私、需要离线能力或希望避免API成本的用户来说,正变得越来越现实。
专用引擎带来近4倍提速的案例也提示了一个方向:在通用框架之外,针对具体模型和硬件的深度优化仍有巨大的性能空间可挖。
相关推荐
DeepSeek Harness 实测:八步装机教程与三大避坑指南
DeepSeek 开源工作台 Harness 发布当天获三万星。本文实测整理八步装机全流程与三大避坑指南:Node 版本、0.1 接口变动、第三方插件源码审查,并解析「一切皆插件」的架构设计。
从DeepSeek看基模创业:颠覆式创新为何独立发生?
对话栾宇深度解析DeepSeek等基础模型创业的成功逻辑:为何颠覆式创新独立发生、懂技术的领导者为何关键、战略定力与决绝投入如何决定成败。
AI编程token告急?混搭开源模型省下4倍成本实测
海外AI编程博主实测:用GPT-6 Astra规划、GLM开源模型实现代码的混搭策略,成本降至纯Claude的四分之一而质量持平。详解规划用强模型、实现用小模型的分层工作流,破解AI编程token与速率限制难题。