97%通过率背后的陷阱:聚合评估指标如何掩盖关键失败

97%的聚合通过率掩盖了多语言切片61%的真实失败率,揭示AI评估中聚合指标与数据泄漏的系统性陷阱。
一个拥有1800条测试用例、长期维持97%通过率的AI评估套件,在对多语言表单进行队列切片后,暴露出该子集仅61%的真实通过率,而聚合仪表盘始终显示绿色。深入排查发现,根因有两层:随机划分导致近重复模板同时出现在训练集与测试集,数据泄漏人为抬高了基线;大量简单用例的稳定通过,在统计上淹没了多语言切片集中爆发的失败。文章由此提出改进方向:将关键切片维护为独立回归数据集并在CI中设置队列级质量门,关注逐用例的实验差异而非聚合分数,同时坦承小样本高权重切片的门槛定义仍是尚待解决的开放难题。
当97%的通过率变成一个谎言
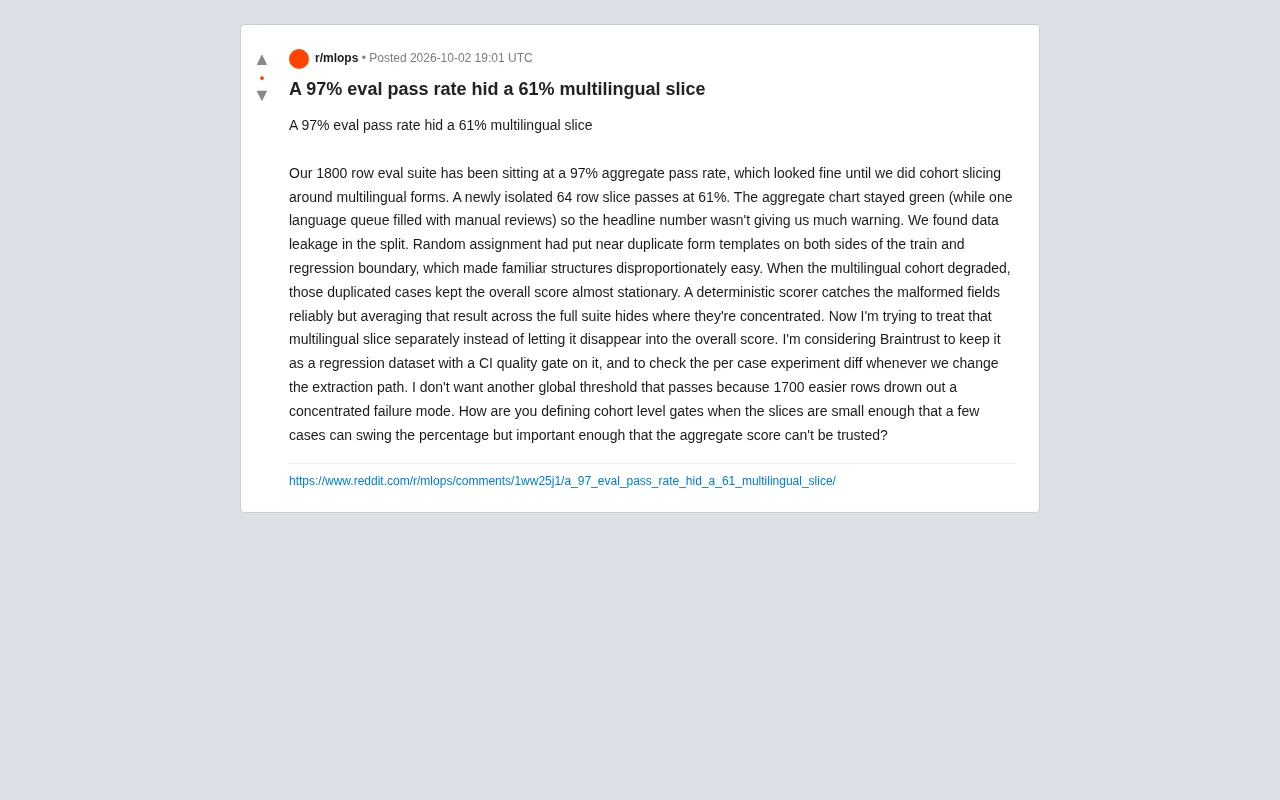
一个拥有1800行测试用例的评估套件,长期稳定在97%的聚合通过率。从仪表盘看,一切都是绿色的,团队也因此安心——直到他们对多语言表单做了一次队列切片(cohort slicing)。
结果令人警醒:新隔离出来的64行多语言切片,通过率只有61%。但聚合图表依然一片祥和,而同时,某个语言的处理队列正被大量人工审核任务填满。换句话说,那个被寄予厚望的"头部数字"几乎没有发出任何预警。
这个来自Reddit的真实案例,揭示了AI评估体系中一个被长期低估的问题:聚合指标(aggregate metrics)天然会稀释掉集中的失败模式。
问题的根源:数据泄漏与随机划分的陷阱
深入排查后,团队发现问题出在数据划分(split)上,存在数据泄漏(data leakage)。
随机分配的方式,把近乎重复的表单模板同时放到了训练集和回归测试集的两侧。这意味着那些"熟悉的结构"对模型来说异常简单——它在测试时见到的,本质上是训练时见过的变体。
这种泄漏带来了一个隐蔽的副作用:当多语言队列的真实表现开始退化时,那些被重复的简单用例始终稳稳通过,像压舱石一样,让整体分数几乎纹丝不动。
这里暴露出两个相互叠加的问题:
- 数据泄漏让一部分用例失去了评估价值,人为抬高了基线
- 聚合平均把集中爆发的失败均摊到了1700多个简单用例里,使其彻底隐形
一个确定性评分器(deterministic scorer)能够可靠地捕捉到字段格式错误,但当你把这个结果在整个套件上做平均时,它就无法告诉你"错误集中在哪里"。
数据泄漏(Data Leakage) 在机器学习评估中是指测试集中的信息在训练阶段就已经被模型"见过",从而导致评估结果虚高。在表单抽取场景中,这种泄漏往往以模板重复的形式出现:同一家公司的表单可能共享几乎一致的字段结构,随机划分时这些近似副本会被分散到训练集和测试集两侧。模型实际上是在"复认"而非"泛化"。正确的做法是按来源实体或模板 ID 进行分组划分(group/stratified split),确保同一模板的所有变体只出现在一侧。这与传统机器学习中处理时序数据时防止未来信息泄露的逻辑一致——边界必须对应真实的决策边界,而不是统计上的随机切割。
为什么聚合指标会系统性误导
这个案例的价值在于,它不是一个孤立的bug,而是评估方法论层面的结构性缺陷。
设想一下:1700个容易的用例 + 100个困难的多语言用例。即便困难用例全军覆没一半,聚合通过率可能只从97%掉到93%左右——这种变化很容易被当成正常波动忽略。但对那个语言的真实用户而言,体验已经崩塌了。
平均数掩盖分布,这是统计学上的常识,却在工程实践中被反复踩坑。当你的产品服务于多个异质性的用户群体(不同语言、不同表单类型、不同地区),一个全局阈值(global threshold)几乎必然会出现"多数淹没少数"的情况。
真正危险的不是分数低,而是分数高到让你停止追问。
这一现象在统计学中有一个经典对应:辛普森悖论(Simpson's Paradox),即在分组数据中普遍成立的趋势,合并后可能完全消失甚至反转。AI评估领域的"聚合陷阱"是其工程变体:当子群体规模悬殊时,大群体的高分会在数学上压制小群体的低分,使整体指标看起来健康,而实际受损的群体对聚合数字几乎没有拉力。这在服务多语言、多地区用户的系统中尤为危险——使用频率低的语言恰恰往往也是数据覆盖最薄弱的语言,双重弱势叠加,却在仪表盘上集体隐身。
解决思路:从全局阈值到队列级质量门
帖子作者提出的改进方向,值得所有做AI评估的团队借鉴:把多语言切片单独拎出来,不让它消失在整体分数里。
具体做法包括:
把关键切片作为独立回归数据集
作者考虑使用 Braintrust 这类工具,将多语言切片维护为一个独立的回归数据集,并在 CI 流程中对它单独设置质量门(quality gate)。这样一旦这个切片退化,CI 就会直接拦截,而不是等到人工审核队列堆积才被发现。
质量门(Quality Gate) 是 CI/CD 流程中的一种自动拦截机制:当某项指标跌破预设阈值时,流水线自动失败并阻止变更合并或部署。将其引入 AI 评估意味着把"模型是否退化"这一判断从人工周期性审查,变成每次提交都自动执行的强制检查点。Braintrust、LangSmith 等 LLM 评估平台均支持将评估数据集与 CI 钩子集成,针对特定切片触发独立评估任务并返回通过/失败信号。这与软件工程中单元测试覆盖率门槛的理念一脉相承——不同之处在于,AI 系统的"测试"本身带有概率性,因此门槛的定义需要额外考虑统计置信度。
关注逐用例的实验差异
每当修改抽取路径(extraction path)时,检查 per-case 的实验 diff,而不是只看聚合分数的变化。逐用例对比能让回归具体到"哪一条",而非"整体掉了几个点"。
警惕小样本的统计波动
作者也坦诚抛出了一个尚未解决的难题:当切片足够小(比如只有64行)时,几个用例就能显著摇摆百分比;但这个切片又足够重要,重要到整体分数根本不可信。如何在这种小样本、高权重的切片上定义合理的队列级门槛?
这是一个开放问题。可能的方向包括:对小切片使用绝对失败数而非百分比作为门槛、引入置信区间、或为不同切片设置差异化的通过标准。但没有一个银弹能同时解决样本小和权重高的矛盾。
对小样本切片设置百分比门槛时,置信区间往往宽到几乎没有参考价值。以64个样本为例,若观测到61%通过率,其95%置信区间(Wilson区间)大约为48%到73%——上下浮动超过12个百分点。一种更稳健的替代策略是设置绝对失败数上限:例如,规定该切片的失败用例不得超过10条,超过即触发门控。这种方式对样本量不敏感,且在直觉上更贴近"我们能容忍多少个真实用户受影响"的业务语义。另一方向是贝叶斯方法:用历史失败率作为先验,结合新观测更新后验分布,从而在样本稀少时保守估计真实风险,避免因少数几个用例的随机波动触发误报或漏报。
给评估体系的几点启示
这个案例对正在搭建 LLM 或抽取类系统评估流程的团队,提供了几条可直接落地的经验:
第一,永远不要只信聚合指标。 聚合通过率适合做趋势监控,但绝不应作为唯一的质量把关依据。至少要按关键维度(语言、用例类型、来源)做切片。
第二,优先排查数据划分的泄漏。 随机划分在面对高度结构化、存在模板重复的数据时非常危险。应该按模板、按来源做分组划分(group split),确保训练与测试边界干净。
第三,为高价值切片设置独立的质量门。 与其追求一个漂亮的全局数字,不如为每个关键队列单独设防,让问题在它集中爆发的地方被拦截。
一个97%的通过率,如果买来的是对61%失败切片的盲视,那它不仅没有价值,反而是有害的——因为它让团队在该警觉的时候选择了安心。
相关推荐

亚马逊新款Alexa平板来袭:超值价格背后的广告隐忧
亚马逊新款Alexa平板以229至549美元的超值价格冲击安卓平板市场,有望成为默认选择。但低价背后是广告补贴与购物推送的隐忧,本文分析其机遇与潜在陷阱。

ChatGPT移动端上线DOT:随身AI代理如何帮你搞定工作
OpenAI的ChatGPT移动端正式上线DOT主动式AI代理,支持iOS和Android。本文详解DOT的设置流程、个性化配置,以及它如何自主编码、跨Slack协作完成复杂任务。

Claude Code v2.1.296 更新解析:子代理、权限与跨平台修复
Claude Code v2.1.296 版本更新详解:新增子代理 autoCompactWindow 与工作流模型控制,加固 Bash 权限与密钥脱敏,优化 Windows 兼容性,并下调 Sonnet 5.5 缓存读取价格。