Academa:用大语言模型自动生成长篇STEM讲座视频

引言:当AI开始「讲课」
在线教育领域正在经历一场由生成式AI驱动的变革。生成式AI(Generative AI)是指能够根据训练数据创造全新内容的人工智能系统,涵盖文本、图像、音频、视频等多种模态。自2022年底ChatGPT引爆公众关注以来,生成式AI已渗透至内容创作、客服、编程辅助等众多领域。而在线教育则经历了从MOOC平台(如Coursera、edX)的兴起,到短视频知识平台(如可汗学院)的普及,再到如今AI辅助教学工具的涌现。两者的深度交汇,意味着教育内容的生产方式可能从"人力密集型"转向"AI驱动型"。
值得一提的是,MOOC(Massive Open Online Courses,大规模开放在线课程)的概念起源于2008年加拿大学者George Siemens和Stephen Downes的实验性课程,但真正引爆全球关注是在2012年——被《纽约时报》称为"MOOC元年"。斯坦福大学教授Andrew Ng和Daphne Koller创立了Coursera,MIT和哈佛联合推出了edX,核心理念是将世界顶级大学的课程免费开放给全球学习者。然而十余年发展下来,MOOC面临的核心挑战是完课率极低(通常仅5%-15%)以及优质内容的生产瓶颈——每门课程仍高度依赖教授个人投入。可汗学院则走了另一条路,创始人Sal Khan最初只是在YouTube上传简短的数学辅导视频,逐步发展为涵盖数学、科学、经济学等学科的免费教育平台,其短视频+练习的模式更适合自主学习节奏。正是这些平台的成功与局限,为AI驱动型教育内容的探索铺设了舞台。
近日,一个名为 Academa 的项目登上了 Hacker News 的 Show HN 板块,其核心卖点极具吸引力:利用大语言模型(LLM)自动生成长篇幅的STEM(科学、技术、工程、数学)讲座视频。Hacker News 是由硅谷知名创业孵化器 Y Combinator 运营的技术社区,是全球开发者和科技创业者最重要的信息交流平台之一。其 Show HN 板块专门供开发者展示自己的个人项目或早期创业产品,是许多后来大获成功的技术产品(如Dropbox早期原型)的首次亮相之地。Y Combinator自2005年成立以来,已孵化出包括Airbnb、Stripe、Reddit在内的数千家创业公司,其社区对技术趋势的嗅觉往往具有前瞻性——Hacker News上的讨论热度常常是某一技术方向即将爆发的先行指标。
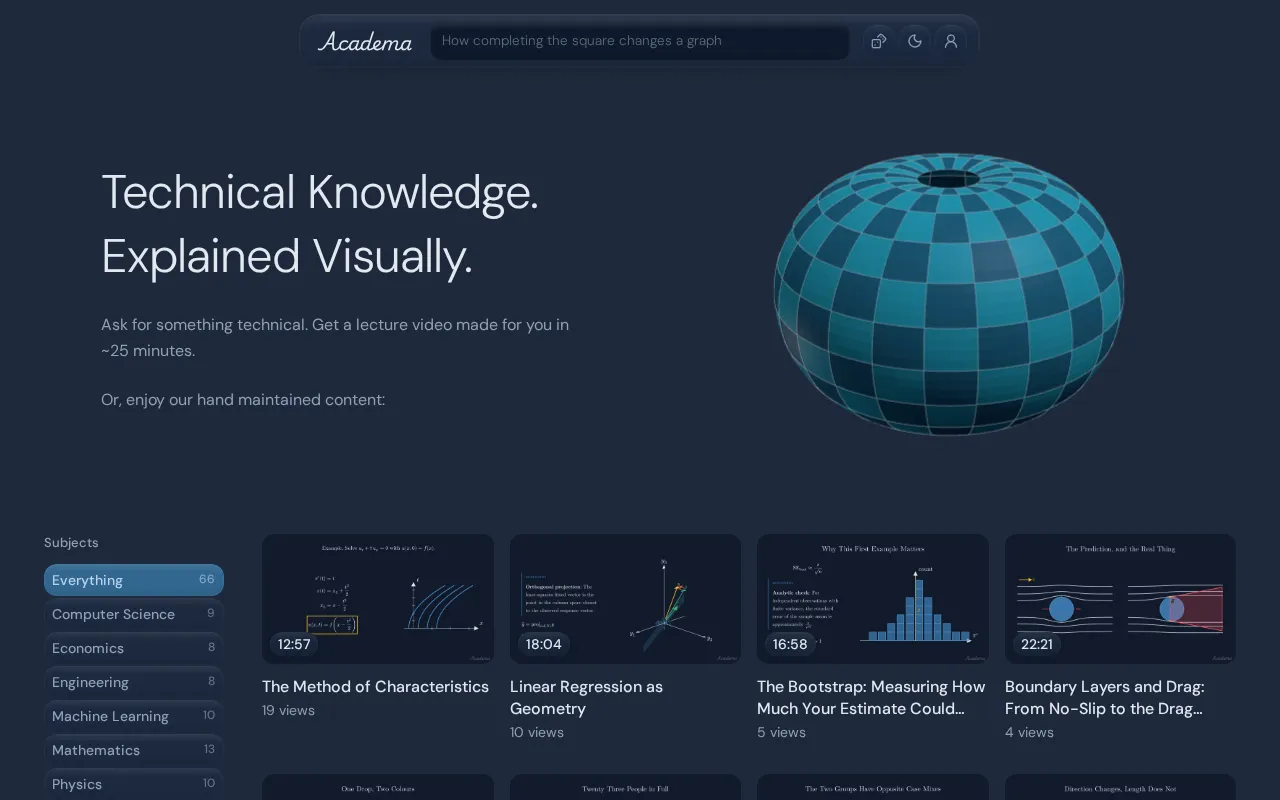
这不同于我们熟悉的短视频摘要或AI问答助手。Academa 试图解决的是一个更硬核的问题:如何让AI像一位真正的教授一样,就一个复杂的技术主题,进行结构完整、逻辑连贯、时长可观的系统性讲解。虽然项目目前在 Hacker News 上的热度还不算高(7个赞、2条评论),但一个项目在 Show HN 上的投票数和评论数在一定程度上反映了技术社区对该方向的兴趣——而低热度并不必然意味着方向有误,许多超前概念往往需要时间才能被广泛理解和接受。它所代表的方向——AI生成结构化长内容——值得深入探讨。
Academa 到底在做什么
从「回答问题」到「讲授课程」
当前主流的AI教育应用大多围绕问答式交互展开:用户提问,AI作答。Khan Academy 推出的 AI 导师 Khanmigo 基于 GPT-4 构建,能够进行苏格拉底式问答引导;Duolingo 利用 LLM 提供个性化语言练习。这种模式适合碎片化学习和答疑,但难以替代系统性的知识传授。一门优质的STEM课程需要循序渐进的知识铺垫、前后呼应的概念关联,以及对难点的反复强化。从教育学的角度看,这涉及到布鲁姆认知层次模型(Bloom's Taxonomy)中从"记忆""理解"到"应用""分析""评价""创造"的逐级跃升——问答模式主要覆盖前两个层次,而系统性讲座才能有效引导学习者向高阶认知能力攀升。
Academa 的定位恰恰是填补这一空白。它瞄准的是「long-form」(长篇幅)内容生成,输出的不是几分钟的知识点讲解,而是接近真实课堂时长的完整讲座。这对底层的内容规划能力提出了极高要求:模型需要在长上下文中保持逻辑一致性,避免概念前后矛盾或重复冗余。
STEM 领域的特殊挑战
选择 STEM 作为切入点,既是机遇也是难点。STEM 内容具有高度的结构化和逻辑严谨性——数学推导、物理定律、算法流程都有明确的正确与错误之分。然而,LLM 本质上是概率性的文本预测系统,而非符号推理引擎,这导致它们在多步数学推导、物理量纲分析等场景中容易出现"幻觉"(Hallucination)——即生成看似合理但实际错误的内容。
要理解这一问题的根源,需要认识到大语言模型的核心架构——Transformer。这一架构由Google研究团队在2017年的论文《Attention Is All You Need》中提出,通过自注意力机制(Self-Attention)让模型能够在处理每个词时"看到"输入序列中的所有其他词,从而捕获长距离依赖关系。LLM的训练分为预训练(在海量文本语料上进行无监督学习,习得语言的统计规律和世界知识)和微调(包括RLHF——基于人类反馈的强化学习,使输出更符合人类偏好)两个阶段。关键在于,LLM本质上是在每一步预测"下一个最可能的token",而非真正"理解"内容——这解释了它为何在生成流畅文本方面表现卓越,但在需要严格逻辑推理的任务上容易犯错。值得注意的是,近年来的研究尝试通过将符号计算引擎(如Wolfram Alpha、Python解释器)与LLM结合来弥补这一缺陷——OpenAI的Code Interpreter和Wolfram插件就是这一思路的具体实现,它们允许模型在需要精确计算时调用外部工具,而非仅依赖概率预测。
LLM的幻觉问题是当前AI安全研究的核心议题之一。在STEM领域,幻觉的表现形式尤为隐蔽——模型可能生成格式完美但结论错误的数学证明,或引用根本不存在的学术论文。2023年的多项研究表明,即使是GPT-4级别的模型,在复杂数学推理任务上的错误率仍可达20%-40%。这使得AI生成的教育内容如果缺乏人工审核,可能比传统教育中的错误更难被学习者察觉,因为AI的表述通常非常自信且格式规范。学术界将这种现象称为"校准不良"(Poor Calibration)——即模型的置信度与其实际准确率之间存在显著偏差,模型即使在错误时也表现得同样"确定"。
这意味着:
- 优势:知识边界清晰,便于验证与评估,AI不易「自由发挥」跑偏主题。
- 挑战:对准确性零容忍。一个公式的错误、一处推导的跳步,都可能误导学习者。这也是当前大语言模型在数学与科学推理上的已知短板。
技术架构分析:视频生成的多模态流水线
从文本到视频的完整链路
尽管项目披露的技术细节有限,但从「LLM生成长篇STEM讲座视频」这一描述,可以推测其大致的技术架构。一个完整的AI视频生成流水线通常包含以下环节:
- 课程大纲规划:由LLM根据主题生成结构化的讲义提纲,确定知识点的讲解顺序。这一步的质量直接决定了整个讲座的教学效果。优秀的课程大纲需要遵循教学设计原则——例如"先决条件分析"(prerequisite analysis),确保每个知识点出现前其依赖的基础概念已被充分讲解。在传统教育中,这种知识依赖图谱(knowledge graph)的构建是资深教师的核心能力之一,而让LLM自动化完成这一过程,本质上要求模型具备对学科知识结构的全局理解能力。
- 讲稿撰写:逐节生成详细的口语化讲解文本,这是长内容连贯性的核心考验。口语化讲解文本与书面学术写作有本质区别——它需要更多的过渡语句、适当的冗余(帮助听众跟上思路)、以及将抽象概念具象化的类比。例如,MIT教授Walter Lewin的物理学讲座之所以经典,很大程度上得益于他将复杂物理原理转化为生动演示的能力,这种"教学直觉"是当前LLM难以完全复制的。
- 视觉素材生成:将公式、图表、示意图等以幻灯片或动画形式呈现,可能涉及代码生成(如生成绘图脚本)或图像生成模型。在STEM教育中,视觉表达的精确性至关重要——一个坐标轴标注错误或函数图像的微小偏差,都可能导致学习者形成错误的直觉。工具链层面,这可能涉及Manim(3Blue1Brown创建的数学动画引擎)、Matplotlib、TikZ等专业绘图工具的自动化调用。
- 语音合成(TTS):将讲稿转换为自然流畅的语音旁白。新一代神经网络TTS系统如ElevenLabs、OpenAI TTS、微软Azure Neural TTS等,已能生成接近真人的自然语音,支持多语言、多情感风格和语速控制。对于教育讲座而言,TTS的关键指标不仅是自然度,还包括对STEM专业术语的正确发音(如化学分子名称、数学符号的口语化表达)、适当的停顿与重音(帮助学习者理解逻辑重点),以及长时间聆听的"耐听度"。目前顶尖TTS系统在处理公式读法(如"∫从0到π的sin(x)dx")等高度专业化场景时仍需专门优化。TTS技术的发展经历了从拼接合成(concatenative synthesis)到参数合成(parametric synthesis)再到端到端神经网络合成的演进——2017年Google DeepMind的WaveNet标志着神经网络TTS时代的开启,随后Tacotron、VITS等模型进一步提升了合成质量和效率。
- 音视频合成:将旁白、字幕、视觉素材对齐并渲染为最终视频。
多模态AI生成是当前技术前沿的热点方向。2023至2024年间,OpenAI的GPT-4V实现了视觉理解与文本生成的融合,Sora展示了从文本描述生成高质量视频的可能性,Google的Gemini模型从设计之初就是原生多模态的。在教育视频生成场景中,多模态协同的核心挑战是"对齐"——语音旁白的节奏需要与幻灯片切换精确同步,公式推导的视觉动画需要与口头讲解的逻辑步骤一一对应,图表出现的时机需要契合知识点引入的顺序。这种时序对齐的复杂度远超单一模态的内容生成,目前业界尚无成熟的端到端解决方案,大多依赖分阶段生成后拼接的流水线架构。在工程实现上,这种流水线架构通常需要一个"编排层"(orchestration layer)来协调各模块的输入输出,类似于电影制作中导演的角色——它决定了何时切换幻灯片、何时插入动画过渡、何时暂停语音以留给学习者思考时间。
长上下文一致性是核心难题
在上述流程中,最能体现技术水平的是长篇内容的一致性维护。生成一段两分钟的讲解并不难,难的是生成一小时讲座时,始终围绕主线、术语统一、难度递进。
上下文窗口(Context Window)是指LLM在单次推理中能够处理的最大token数量。早期的GPT-3.5上下文窗口仅为4K tokens(约3000字),而到2024年,Claude 3的上下文窗口已扩展至200K tokens,Gemini 1.5 Pro更是达到了100万tokens。上下文窗口的扩大对长内容生成至关重要:一小时的讲座文稿约含1.5万至2万字,加上必要的提示词和参考资料,轻松超过早期模型的处理上限。但更大的上下文窗口并不自动意味着更好的长程连贯性——研究表明,LLM在处理长文本时存在"中间遗忘"(Lost in the Middle)现象,即对上下文窗口中间部分信息的关注度显著低于首尾部分,这对长讲稿的质量一致性构成直接威胁。这一现象由斯坦福大学等机构的研究者在2023年的一篇重要论文中系统性地揭示,他们发现即使是声称支持超长上下文的模型,在需要利用中间位置信息回答问题时,准确率也会显著下降。这意味着在生成长讲座时,早期定义的关键术语或概念框架可能在中后段被"遗忘",导致术语不一致或概念重复定义。
要应对这一挑战,需要精心设计的提示工程(Prompt Engineering)、分段生成与全局校验机制。提示工程在长内容生成中的复杂度远超短文本场景:典型策略包括Chain-of-Thought(思维链)提示让模型逐步展开推理过程;分层提示(先生成大纲,再逐节展开)以维护结构一致性;角色设定(如"你是一位拥有20年教学经验的MIT物理教授")以控制内容风格和深度。更高级的方法还包括自我一致性检查(让模型回顾并校验已生成内容)和迭代精炼(多轮生成-评估-修改循环)。在实际工程中,分段生成策略尤为关键:系统可以先生成完整大纲,然后为每一节生成内容时将大纲和前几节的摘要作为上下文注入,同时维护一个"全局状态文档"记录已引入的术语定义、已使用的类比、以及难度梯度的当前位置,从而在不超出上下文窗口限制的前提下保持全局一致性。
此外,项目可能还引入了检索增强生成(RAG)来锚定权威知识源,降低事实性错误的风险。RAG是一种将外部知识库与LLM相结合的技术范式,最早由Meta AI研究团队于2020年提出。其核心思路是:在模型生成回答前,先从可信的外部知识源(如教科书数据库、学术论文库、维基百科等)中检索与当前主题最相关的文档片段,然后将这些片段作为上下文注入到模型的提示词中,引导模型基于事实性信息生成内容。在STEM教育场景中,RAG可以有效缓解LLM的幻觉问题:例如生成量子力学讲座时,系统可以实时检索费曼物理学讲义或MIT OpenCourseWare中的权威内容作为锚点,确保公式推导和概念解释的准确性。RAG的关键挑战在于检索质量——如果检索到的文档不相关或过时,反而可能引入噪声。RAG的技术实现通常包括三个核心组件:文档嵌入(使用embedding模型将知识库文档转化为向量表示)、向量检索(使用FAISS、Pinecone等向量数据库进行相似度搜索)和上下文融合(将检索到的文档片段与用户查询一起构造提示词)。在STEM场景中,检索的额外挑战在于数学公式和代码片段的语义表示——传统的文本embedding模型在处理"∇²ψ + V(r)ψ = Eψ"这样的薛定谔方程时,往往无法准确捕获其数学语义,导致检索效果不佳。
价值与局限:理性看待AI生成讲座
教育内容规模化生产的潜力
Academa 这类工具的想象空间在于教育内容的规模化生产。全球在线教育市场规模预计到2030年将超过4000亿美元(据Grand View Research数据)。然而,优质教育内容的供给始终是瓶颈:制作一门完整的MIT水平STEM课程,通常需要教授数百小时的备课和录制时间,加上专业团队的后期制作,单门课程成本可达数万至数十万美元。这导致了严重的内容不均衡——英语世界的热门学科(如机器学习、数据科学)课程资源过剩,而小语种、冷门学科(如拓扑学、材料科学的细分方向)则严重匮乏。根据UNESCO的数据,全球约有7000种语言,但超过90%的在线教育内容仅覆盖约20种主要语言,而在STEM高等教育领域,英语内容的占比更是超过80%。这种语言壁垒意味着非英语母语的学习者——尤其是非洲、东南亚和南美的学生——在获取前沿知识方面面临系统性劣势。
如果AI能够将这一流程自动化,理论上可以:
- 快速覆盖长尾、小众的知识主题,极大地拓展教育内容的覆盖广度;
- 为不同水平的学习者定制难度,实现真正的个性化学习路径——这与教育技术领域长期追求的"自适应学习"(Adaptive Learning)目标不谋而合,即系统根据学习者的实时表现动态调整教学内容和难度;
- 大幅降低优质教育资源的生产成本——从数万美元降至数百美元,尤其惠及发展中国家和非英语学习者群体。结合LLM日益成熟的多语言能力,同一套STEM课程理论上可以被快速本地化为数十种语言版本,而翻译成本几乎可以忽略不计。
现阶段的核心局限
然而,我们也需要保持清醒。作为一个早期的 Show HN 项目,Academa 目前的社区反响平平,尚缺乏大规模的质量验证。几个核心问题依然悬而未决:
- 准确性保障:AI生成的STEM内容能否达到教学级别的严谨度?谁来把关纠错?考虑到LLM的幻觉问题在数学推导和科学事实领域尤为突出,缺乏人工审核的全自动内容生成管线存在传播错误知识的风险。一种可能的缓解方案是引入"人机协同审核"工作流:AI生成初稿后,由领域专家进行定向审核,重点检查公式推导的正确性和概念定义的精确性。但这也引出了一个经济学问题——如果审核成本过高,AI生成的成本优势就会大打折扣。
- 教学法设计:优秀的讲座不仅是信息的堆砌,更是对认知规律的把握。教育心理学中的"认知负荷理论"(Cognitive Load Theory)由澳大利亚教育心理学家John Sweller于1988年提出,是现代教学设计的理论基石之一。该理论认为人的工作记忆容量极为有限(通常只能同时处理4-7个信息单元),因此教学内容的组织方式直接影响学习效果。认知负荷分为三类:内在负荷(由学习材料本身的复杂度决定)、外在负荷(由不良的教学设计造成)和相关负荷(有助于知识建构的认知投入)。优秀的教师会通过示例、类比、逐步引导等策略降低外在负荷、管理内在负荷并促进相关负荷。"最近发展区"(Zone of Proximal Development)则是苏联心理学家维果茨基提出的概念,指学习者在独立能力与在指导下能达到的能力之间的区间——有效教学应精准定位在这一区间内。AI要真正模拟优秀教师,不仅需要知道"讲什么",更需要理解"何时讲"和"怎么讲",而这恰恰是当前LLM最难以量化和评估的能力维度。更具体地说,一位经验丰富的STEM教师能够实时"读取"课堂氛围——从学生的表情判断是否需要放慢节奏、从提问的类型判断哪些概念未被充分理解——这种基于反馈的动态调整能力,在AI生成的预录制讲座中完全缺失。
- 学习体验:脱离真人教师的讲座,学习者的注意力与互动如何保障?研究表明,在线学习中学习者的平均注意力持续时间远低于面授课堂,而AI生成的标准化内容可能进一步削弱学习者的沉浸感和参与动机。MIT和哈佛对edX平台的联合研究发现,在线课程视频的最佳时长约为6-9分钟——超过这一时长后,学习者的参与度急剧下降。这一发现对试图生成"长篇讲座"的Academa提出了直接挑战:是应该生成连续一小时的讲座,还是更应该将内容切分为多个短模块并在模块间嵌入互动练习?此外,社会临场感(Social Presence)——学习者感受到与教师或同伴之间真实联系的程度——是影响在线学习效果的关键因素,而AI生成的内容在这一维度上天然处于劣势。
结语:AI长内容生成的试金石
Academa 或许还只是一个雏形,但它指向的趋势清晰而重要:生成式AI正从「短内容工具」向「长内容创作者」演进。当模型能够胜任系统性、结构化的知识组织与表达时,其在教育、培训乃至知识管理领域的应用价值将被重新定义。
对于关注AI应用落地的从业者而言,这类项目的看点不在于当前它做得多好,而在于它揭示的技术边界正在如何被推移。长篇STEM讲座生成的难度——它对事实准确性的严苛要求、对长程逻辑连贯性的极端依赖、对多模态内容协同的技术整合——恰恰是检验大语言模型「深度推理」与「长程规划」能力的一块试金石。随着上下文窗口的持续扩大、RAG技术的成熟以及多模态生成能力的提升,这块试金石上的成色,将越来越清晰。
更深远地看,Academa所代表的方向可能催生一种全新的教育内容生态:AI负责大规模生产"足够好"的基础教育内容,人类教师则将精力集中在高价值的教学活动上——如项目指导、批判性讨论、个性化辅导和情感支持。这种分工不是AI对教师的替代,而是对教育资源配置方式的根本性重构。在这一进程中,技术能力的提升固然重要,但更值得关注的是评估标准的建立——我们如何定义"AI生成的STEM讲座达到了可接受的教学质量"?这个问题的答案,将决定AI在教育领域的实际渗透深度。
相关推荐
Jev前沿模型问世:成本降40-400倍,速度提升20-200倍
新前沿模型Jev宣称成本降低40-400倍、速度提升20-200倍,引发Hacker News热议。本文解析其性价比卖点、效率突破的可能路径,以及如何理性看待这组惊人数字。

同款模型三大AI Agent横评:DeepSeek Harness、ZCode与Hermes谁更强
同一个GLM Flash模型、相同提示词,分别放进DeepSeek Harness、ZCode和Hermes三大AI Agent中横评对比。实测显示Agent框架差异显著,速度、代码量与最终效果各有高低,DeepSeek Harness综合表现最佳。

DeepSeek扒谱时喊"困了"?聊聊LLM思维链里的拟人化现象
B站UP主发现DeepSeek在扒谱、BPM识别任务的思维链中出现"困了""想睡觉"等拟人化表达。本文解析LLM为何会模仿疲劳、思维链如何放大拟人化现象,以及如何应对模型输出跑偏。