Agent 调用 Agent:以 Git 为中枢的递归协作新范式

Agent 互相调用的趋势背后,是 Git 作为状态中枢带来的编排简化与递归协作。
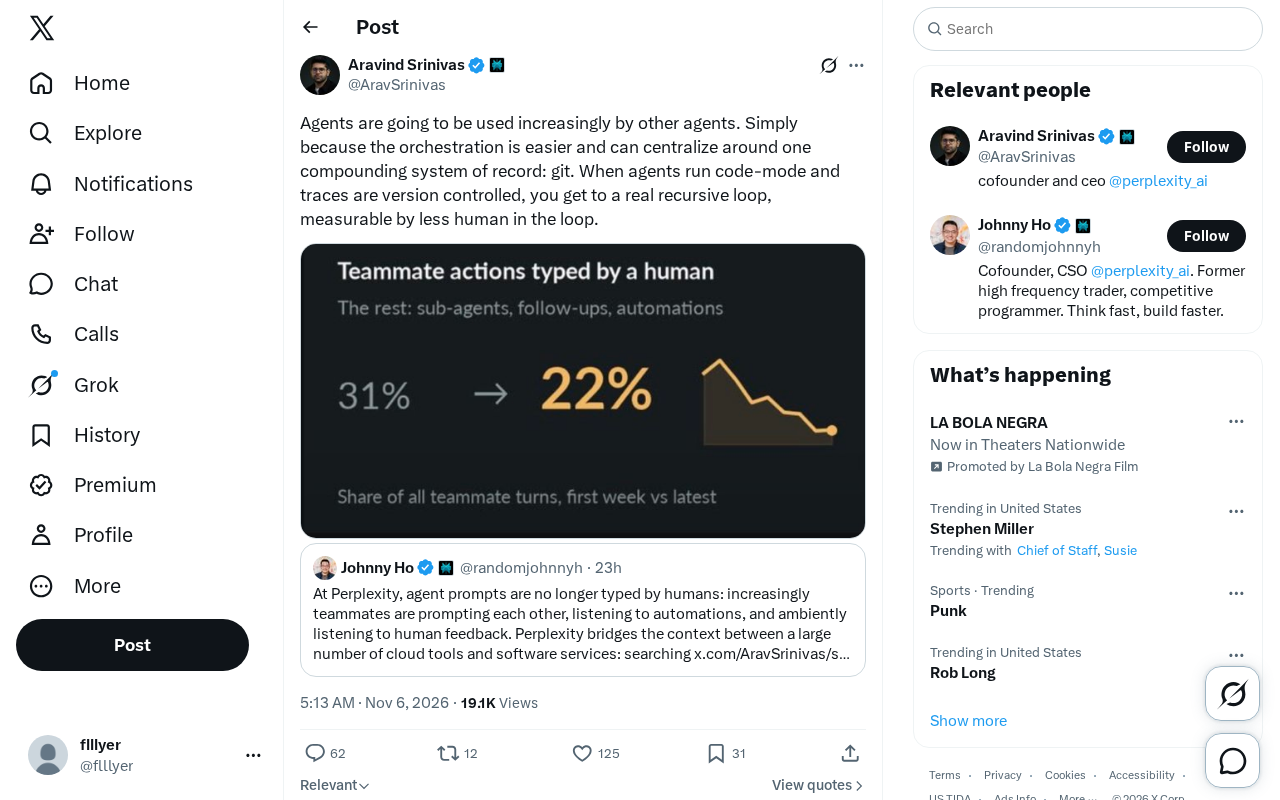
文章从 Twitter 上的一则观察出发,指出 AI Agent 将越来越多地被其他 Agent 调用,驱动力不是模型能力炫技,而是工程上的必然:编排更简单,且能围绕 Git 这一可复利的系统记录中心化。Git 提供状态可追溯、变更可复现、协作可并行三样能力,使 Agent 的每次生成与调用都以 commit 形式沉淀为可审计、可检索的知识,形成复利效应。建立递归循环需要两个前提:Agent 以 code-mode 运行,且 traces 被版本控制。二者结合后,上层 Agent 可检查、回滚或分叉下层 Agent 的轨迹,人类介入频率随之下降,成为衡量系统成熟度的标尺。文章最后给出开发者启示:优先用 Git 作共享状态层、重视轨迹可版本化、把人类介入次数作为核心优化指标。
从单点智能到代理网络
当我们在谈论 AI Agent 时,通常想象的是一个独立助手完成某项任务。但 Twitter 上的一则观察指向了更激进的趋势:Agent 将越来越多地被其他 Agent 调用。原因不是炫技,而是工程上的必然——编排更简单,并且能围绕一个可复利的系统记录中心化:Git。
这个判断的价值在于,它把 Agent 的协作问题从“模型能力”拉回到了“软件工程”的层面。当一个 Agent 以 code-mode 运行,其执行轨迹被版本控制管理时,真正的递归循环才得以建立,而衡量这种循环的关键指标是“更少的人类介入”。
为什么是 Git?
Git 之所以成为 Agent 协作的天然中枢,核心在于它提供了三样东西:状态可追溯、变更可复现、协作可并行。当多个 Agent 围绕同一个仓库工作时,每一次代码生成、每一次工具调用、每一次修复尝试都以 commit 的形式留下痕迹。这相当于为 Agent 的决策过程建立了一个可审计的“系统记录”。
与传统的 API 编排相比,Git 作为记录中心的优势在于复利效应:每一次成功的 Agent 交互都能沉淀为可检索的知识,后续 Agent 可以直接继承前序工作的上下文,而不需要重新推导。这种“一个复合系统”的思路,让 Agent 网络的整体效率随使用而增长,而非停留在单次调用的水平。
Agent 编排(Agent orchestration) 指协调多个 Agent 或 Agent 与工具之间的调用顺序、数据传递与错误处理。传统做法是自建调度器:用消息队列传递任务、用状态数据库记录进度、用自定义协议约定 Agent 间的通信格式。这类方案的问题在于,调度逻辑本身会随系统复杂度膨胀,成为另一个需要维护的软件项目。以 Git 作为编排层则不同,它复用了版本控制中已经被验证数十年的原语——分支隔离并行任务、merge 整合结果、commit history 充当通信日志、rebase 调整执行顺序。编排层因此被压缩为薄薄一层约定,而不是一套新造的中间件。这种思路的代价是 Agent 必须按仓库的粒度组织工作,收益则是状态管理、并发控制和历史审计都由 Git 原生承担。
递归循环的关键:code-mode 与轨迹版本化
原推文特别强调了两个前提条件:Agent 运行在 code-mode 下,以及 traces 被版本控制。这两点缺一不可。
code-mode 意味着 Agent 以编写和执行代码的方式与环境交互,这天然适配 Git 的工作流——代码本身就是版本化的对象。而 traces 的版本控制则更进一步,它把 Agent 的推理轨迹、工具调用序列、中间结果都纳入仓库管理。二者结合,才形成“递归循环”:上层 Agent 可以检查下层 Agent 的轨迹,基于历史记录做决策,甚至回滚或分叉某条执行路径。
这种模式下,人类介入的频率成为衡量系统成熟度的标尺。当 Agent 能读懂前一个 Agent 留下的轨迹并自主接续时,人类从“每一步都要确认”退到“只在关键节点审核”,这正是递归循环走向实用的标志。
code-mode(代码模式)是相对于 chat-mode 的一种 Agent 运行范式。在 chat-mode 下,Agent 通过自然语言与工具交互,每次调用都要经过模型生成文本再解析为结构化参数;而 code-mode 让 Agent 直接生成并执行代码片段来完成任务,工具调用被表达为函数调用或脚本。这种方式的优势在于:执行流程本身就是可读、可测试、可版本化的程序文本,错误可以像调试代码一样定位,而非从对话历史中逆向推测。对 Git 工作流而言,code-mode 天然契合,因为生成的产物就是仓库中的文件,diff 即变更、commit 即决策节点,无需额外的序列化层来记录 Agent 行为。
traces(轨迹) 指 Agent 执行过程中留下的完整记录,包括推理步骤、工具调用序列、中间输出与最终结果。将 traces 纳入版本控制,意味着把 Agent 的“思考过程”当作代码资产来管理:可以 diff 两次执行的差异、回滚到某个中间状态、或在某个分叉点尝试不同策略。它与普通日志的本质区别在于结构化与可复现——日志用于事后排查,版本化的 traces 用于主动复用和递归接续,这正是上层 Agent 能读懂下层 Agent 工作的前提。
编排简化的真实含义
“编排更容易”这句话容易被低估。在多 Agent 系统中,最棘手的问题往往不是单个 Agent 的能力上限,而是 Agent 之间的通信成本、状态同步和错误传播。以 Git 为中心,相当于用一套成熟的版本控制协议替代了自定义的编排逻辑:分支即任务隔离,merge 即结果整合,commit history 即通信日志。
这种做法的代价是 Agent 必须适应 Git 的工作范式,但收益是编排层可以做得极薄。对于构建复杂 Agent 系统的团队来说,这意味着可以把精力从“造调度器”转移到“设计 Agent 的职责边界”上。
对开发者的启示
这则观察虽然简短,但指向了几个可操作的实践方向。第一,在设计多 Agent 系统时,优先考虑将 Git 作为共享状态层,而非另建一套数据库或消息队列。第二,重视 Agent 轨迹的可读性与可版本化,这直接决定了递归循环能否闭环。第三,把“人类介入次数”作为系统优化的核心指标之一,它比单纯的准确率更能反映协作效率。
Agent 调用 Agent 不会只是概念演示,当编排成本和状态管理被 Git 这类成熟工具承接后,递归协作的门槛会显著降低。真正的挑战将从“能不能跑通”转向“如何设计出值得被复用的 Agent 轨迹”。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。