Agentic AI实战指南:核心原理、落地挑战与实践建议

什么是Agentic AI
随着大语言模型(LLM)能力的飞跃式提升,AI领域的焦点正从单纯的"对话生成"转向更具自主性的**智能体(Agent)**范式。所谓Agentic AI,指的是能够自主规划、决策并执行多步骤任务的AI系统,而非被动地等待人类逐条指令。
这类系统的核心特征在于:它不仅能理解用户意图,还能将复杂目标拆解为可执行的子任务,调用外部工具(如搜索引擎、代码解释器、API接口),并根据执行结果动态调整策略。可以说,Agentic AI标志着AI从"工具"向"协作者"的角色转变。
从技术演进脉络看,Agentic AI并非凭空出现。它建立在Prompt工程、思维链(Chain-of-Thought)、检索增强生成(RAG)以及函数调用(Function Calling)等一系列技术积累之上,是这些能力的系统化整合与工程化落地。
其中,**思维链(Chain-of-Thought)**由Google Brain团队于2022年在论文《Chain-of-Thought Prompting Elicits Reasoning in Large Language Models》中正式提出。其核心洞察是:让模型在给出最终答案前,先生成一系列中间推理步骤,能够显著提升模型在数学推理、逻辑判断等复杂任务上的准确率。这一发现为后续Agentic AI中的规划与推理机制奠定了理论基础。**检索增强生成(RAG)**则通过在推理时动态检索外部知识库,弥补了LLM训练数据存在时效截止点的固有局限,使Agent能够接触到最新、最准确的领域知识。
Agentic AI的核心组成
一个完整的AI智能体系统通常由几个关键模块构成,理解这些模块有助于把握Agentic AI的运作逻辑。
规划与推理
规划能力是AI Agent与普通聊天机器人的本质区别。面对复杂目标,Agent需要将其分解为一系列有序步骤。常见的实现方式是**ReAct(Reasoning + Acting)**范式——让模型在"思考"和"行动"之间交替进行,通过观察行动结果来修正后续推理。
ReAct范式在思维链的基础上更进一步,将"推理"与"执行"交织成一个显式的迭代闭环:模型先产生 Thought(下一步该做什么及为何这样做),再执行对应的 Action(如调用搜索工具、读取文件),最后接收 Observation(工具返回的结果),并以此作为下一轮推理的输入。这种"思考→行动→观察"的循环结构,使模型能够根据真实环境的反馈动态修正计划,而非仅凭初始信息一次性生成完整方案——这在面对信息不完整或环境动态变化的真实任务时尤为关键。
此外,一些更先进的架构引入了反思(Reflection)机制,让Agent在执行失败后能够总结经验、重新规划,从而提升任务完成的鲁棒性。代表性工作如Reflexion框架,通过让Agent以自然语言形式生成对失败原因的分析,并将其作为记忆存储,在后续尝试中避免重复犯错,显著提升了Agent在编程、决策等基准测试上的表现。
工具调用
工具调用赋予了AI Agent突破自身知识边界的能力。通过标准化接口,Agent可以访问实时数据、执行计算、操作文件系统,甚至控制其他软件。这一能力是Agent从"纸上谈兵"走向"实际行动"的关键一步。
在工程实现层面,**函数调用(Function Calling)**是目前主流LLM厂商(OpenAI、Anthropic、Google等)提供的核心能力之一。开发者以结构化的JSON Schema格式向模型声明可用工具的名称、参数及描述,模型在推理时若判断需要使用某工具,则输出包含工具名称和参数的结构化调用指令,由外部程序执行后将结果回传给模型。这种"模型决策、程序执行"的分工模式,既保留了LLM的语义理解能力,又确保了工具执行的确定性和安全性,是当前Agentic系统工程化的主流实践路径。
记忆机制
为处理长周期任务,Agent需要具备记忆能力。短期记忆通常通过上下文窗口实现;长期记忆则往往借助向量数据库来存储和检索历史交互信息,使Agent能够在跨会话场景中保持连贯性。
向量数据库(Vector Database)是支撑Agent长期记忆的关键基础设施。它将对话历史、用户偏好、任务中间结果等非结构化信息,通过嵌入模型(Embedding Model)转化为高维向量并持久化存储。在检索时,系统将查询内容同样向量化,通过计算余弦相似度或点积等距离度量,快速从海量历史记录中召回语义最相关的片段,注入到Agent当前的上下文中。代表性产品包括Pinecone、Weaviate、Chroma、Qdrant等。这一机制使Agent可以突破单次会话的上下文窗口硬限制,在跨会话场景中"记住"用户偏好或历史任务状态,是实现真正长周期自主任务不可或缺的基础设施。
Agentic AI落地过程中的挑战
尽管Agentic AI前景广阔,在实际工程落地中仍面临几道绕不开的坎,也是当前技术社区讨论的焦点。
可靠性问题:任务链条越长,单个步骤的错误越容易累积放大,最终导致整个任务偏离预期。这一现象在工程上常被称为"误差传播"(Error Propagation)——假设每个步骤的成功率为90%,仅经过10个步骤后,整个任务的成功率就会降至约35%。因此,如何设计有效的错误检测与恢复机制,包括步骤级别的结果校验、失败后的自动回滚与重试策略,是构建生产级LLM Agent的核心难题。
成本控制:多步骤推理和频繁工具调用意味着大量的Token消耗与API请求,规模化部署时成本压力显著。一个看似简单的用户请求,经过Agent的拆解规划,可能触发数十次LLM推理调用,累计消耗的Token数量可达直接问答场景的数十倍。在能力与效率之间找到平衡点——例如对简单子任务使用轻量级模型、引入缓存机制减少重复调用——是每个团队必须面对的权衡。
安全与可控性:赋予AI自主执行能力的同时,必须防范意料之外甚至有害的操作。合理的权限边界、人工审核环节(Human-in-the-loop)以及沙箱隔离机制,都是保障系统安全的必要手段。
**Human-in-the-loop(HITL)**并非简单地让人类"盯着"AI操作,而是一种在关键决策节点设置人工审核门控的系统设计模式。在Agentic AI工程实践中,HITL通常以"确认步骤"的形式嵌入工作流:Agent在执行高风险操作(如发送邮件、修改生产数据库、调用付费API、删除文件)前主动暂停,将即将执行的动作以可读形式呈现给人类操作员,待明确授权后方可继续。合理设计HITL的触发条件至关重要——过于频繁的审核请求会削弱自动化价值、降低用户体验;而对高风险操作缺乏必要的人工把关,则可能引发不可逆的后果。找到这一平衡点,是Agentic AI系统安全工程设计的核心课题之一。
Agentic AI开发实践建议
对于希望构建Agentic AI应用的开发者,业界的普遍共识是:从小处着手。与其一开始追求全自主的复杂Agent,不如先从边界清晰、步骤有限的任务入手,逐步验证和迭代。
在工具选择上,目前已有多个成熟的开源框架可供参考,例如LangChain、LlamaIndex、AutoGen、CrewAI等,它们对规划、记忆、工具调用等基础组件进行了抽象封装,能显著降低开发门槛,开发者可在此基础上根据业务需求定制。
此外,务必建立完善的可观测性体系。在Agentic AI系统中,可观测性的内涵远超传统软件的日志记录。由于Agent的执行路径具有动态性与不确定性,开发者需要追踪每一次LLM调用的完整输入输出、工具调用的参数与返回值、推理链的逐步轨迹以及Token消耗明细。目前业界已形成以OpenTelemetry为基础的追踪规范,LangSmith、Langfuse、Phoenix等专为LLM应用设计的可观测性平台也应运而生——它们能将Agent"思考与行动"的全过程以可视化方式呈现,使开发者可以清晰定位某个步骤究竟在哪里出了问题、为什么出问题,极大降低了调试多步骤任务时的认知负担。这往往是生产环境中最容易被忽视、也最不应该被忽视的环节。
结语
Agentic AI代表了AI应用的下一个重要方向,将AI的能力从"回答问题"延伸到"解决问题"。当前技术仍处于快速演进阶段,可靠性、成本和安全等问题尚待完善,但其展现出的自主性与实用潜力已足够令人期待。
对开发者和企业而言,深入理解Agentic AI范式——从思维链到ReAct、从向量记忆到HITL安全机制、从工具调用到可观测性工程——积累真实的工程实践经验,正是当下最值得投入的事情。正如任何新兴技术一样,早期探索者往往能在未来竞争中占据先机。
核心要点
相关推荐

9家AI订阅套餐积分换算:每亿Token真实成本揭秘
B站UP主实测火山、阿里、腾讯、百度、智谱、小米、MiniMax等9家AI订阅套餐,统一换算每亿Token真实成本,拆解固定额度与三档系数两类计费逻辑,揭示缓存、时段折扣和窗口限额对实际额度的影响。

Vibe Coding入门:用意图表达代替手写代码
Vibe Coding 是什么?B站137集实战课程给出定义:核心不是写代码而是表达意图。本文解析 Vibe Coding 的生产力逻辑、适合人群与入门预期,帮助零基础者判断是否值得投入学习。
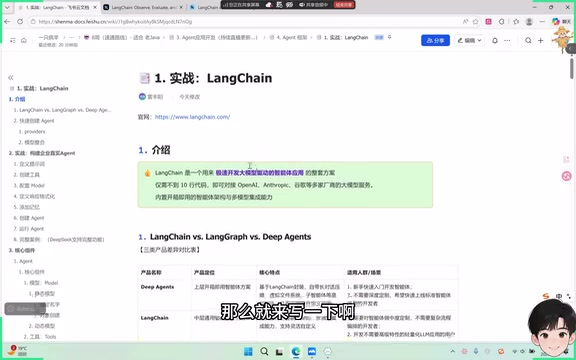
LangChain入门指南:从LangGraph到Deep Agents的智能体开发路线
理清LangChain、LangGraph和Deep Agents的封装关系,掌握智能体开发框架的学习路线与选型逻辑,适合大模型开发入门者参考。