AI Agent不是幻觉,而是用错了"时间版本"的现实

Agent 错误常因检索到真实但属于错误时间版本的事实,OETRA 用显式证据义务修复时间错配。
文章指出 Agent 输出错误未必源于幻觉,而可能是检索到了真实但属于另一时间点的信息版本——数字合法、引用可查,却对当前问题不成立。作者用跨季度营收分析说明这类时间错配如何让分析结论无意义,且传统事实核查难以发现。为此提出 OETRA 方法:先为每个所需事实创建显式证据义务,再逐条检索、校验时间与语义兼容性,并在图结构中保留来源身份与报告期。在 480 份财报记录、1,005 个时间性 QA 上评测显示高槽位覆盖率,但有 167 个错误答案的证据链完整,说明检索解析与答案构建需分开评估。
当"正确"的数字组合出错误答案
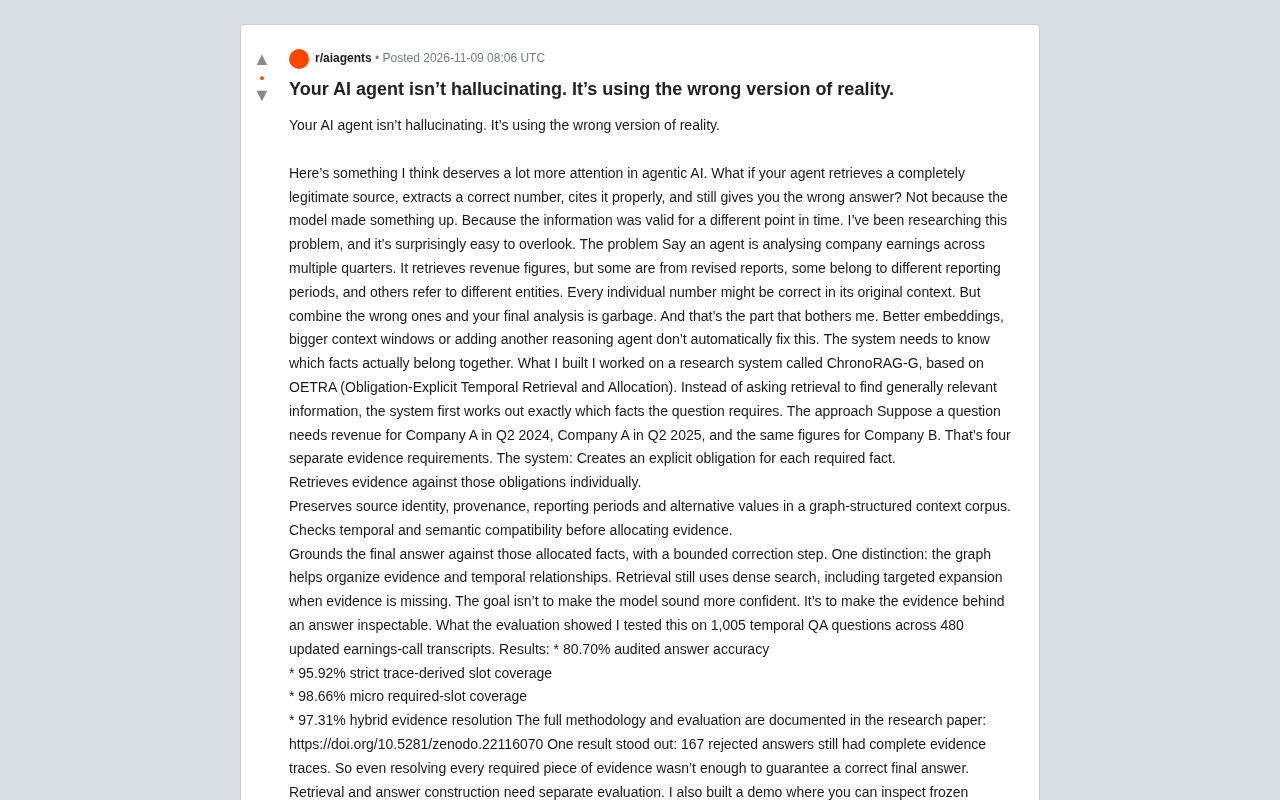
AI Agent 产生错误输出时,我们习惯归咎于"幻觉"。但 Reddit 上一位研究者提出的观点值得重新审视:Agent 检索到了一个完全合法且真实可查的信息源,提取了其中正确的数字,还规范地附上了引用——最终却给出了错误答案。问题不在于模型编造了内容,而在于这条信息属于另一个时间点。
这个区分看似细微,却指向了 Agentic AI 中一个被严重低估的失效模式:事实本身为真,但它对当前问题并不成立。 更好的嵌入模型、更大的上下文窗口、或者再叠加一个推理 Agent,都不会自动修复这类问题。系统需要知道的是:哪些事实在时间维度上真正属于同一个问题。
时间错配如何让分析结果"垃圾化"
作者用一个具体的金融场景说明了问题的严重性。假设一个 Agent 在分析某公司跨多个季度的营收数据,它检索到了若干营收数字——其中一部分来自修订后的财报,一部分属于不同的报告期,还有一些指向了不同的实体。
每一个数字在其原始语境中都是正确的,引用链接也能点开验证。但当系统把这些"各自正确"的数字拼装到一起时,最终的分析结论就是无意义的。这类错误的隐蔽性极强:传统的事实核查流程几乎无法发现它,因为每一步都能追溯到合法来源。
常见的工程直觉在这里失效了。向量检索擅长找到"语义相关"的内容,却无法判断"这条证据是否满足当前问题的时效约束"。扩大上下文窗口只是把更多互相冲突的时间版本一起塞进 prompt,反而可能放大混乱。
向量检索(dense retrieval)是当前 RAG 系统的主流范式:把查询和文档片段分别编码为高维向量,再按余弦相似度等度量召回最接近的片段。它的优势在于语义泛化——即使问法与原文措辞不同也能命中。但相似度本质上只刻画“语义接近”,不携带时间约束:同一家公司 Q2 2024 与 Q2 2025 的营收表述在向量空间里几乎无法区分,修订前后的财报版本也高度相似。因此纯向量召回会把多个时间版本一并返回,且不提供任何机制判断哪一条满足当前问题的时间前提。这也是作者在 OETRA 中保留 dense search 作为召回手段、但额外引入显式义务与时间分配层的原因。
OETRA 思路:先明确需要什么证据,再去找
作者为此构建了一个研究系统 ChronoRAG-G,底层方法是 OETRA(Obligation-Explicit Temporal Retrieval and Allocation,义务显式的时间检索与分配)。它的核心转变在于:不再让检索模块去"找相关资料",而是先精确推导出回答问题需要哪些具体事实。
举例来说,若一个问题需要公司 A 在 Q2 2024 的营收、公司 A 在 Q2 2025 的营收,以及公司 B 的对应数字,这实际上构成了四个独立的证据义务。系统的处理流程是:
- 为每个所需事实创建一条显式义务(obligation)
- 针对每条义务单独检索证据,而非一次性模糊搜索
- 在 graph 结构的上下文语料中保留来源身份、出处、报告期与备选值
- 在分配证据前检查时间与语义兼容性
- 基于已分配的事实做最终答案接地,并带有有界的纠正步骤
一个容易被误读的细节:图结构在这里的作用是组织证据与时间关系,检索本身仍然使用 dense search,包括在证据缺失时进行定向扩展。作者的目标并非让模型"听起来更自信",而是让答案背后的证据可被逐条审查。
证据义务(evidence obligation)借鉴了形式化推理中的“义务”概念:把“回答该问题所必需的一条具体事实”写成可检查的约束,例如“实体=公司A、指标=营收、报告期=Q2 2024、版本=最新修订”。一条义务就是一个待满足的槽位(slot),而非一段自然语言查询。这样做的好处是:检索目标从“相关”变成“可验证地满足”,每个槽位都能独立判定命中与否、是否时间兼容、是否需要用备选值替换。评测中的“槽位覆盖率”指标正是基于这种结构——严格覆盖率要求槽位由完全匹配的来源填充,微观覆盖率则允许在语义等价的前提下放宽,两者结合可区分“找没找到”和“找得对不对”。
评测数据说明了什么
作者在 480 份更新过的财报电话会议记录上,用 1,005 个时间性 QA 问题做了评测,结果如下:
- 80.70% 的审计答案准确率
- 95.92% 的严格可追溯槽位覆盖率
- 98.66% 的微观必需槽位覆盖率
- 97.31% 的混合证据解析率
其中一项发现尤其值得关注:167 个被判定为错误的答案,其证据追溯链却是完整的。 这意味着即使系统成功解析了每一个必需的证据片段,也不足以保证最终答案正确。检索质量和答案构建质量必须被分开评估——这是当前很多 Agent 评测体系的一个盲区。
作者还搭建了可交互的 demo,允许查看冻结的评测运行、时间对齐情况、证据分配与失败轨迹,而不是让人仅仅接受这几个数字。
财报电话会议记录(earnings call transcript)是时间性 QA 的高难度语料:公司会在季度电话会上披露营收、指引等数字,随后可能因重述、口径调整或后续披露而修订,同一指标在不同季度的版本在措辞上高度相似。作者选用 480 份“更新过”的记录,意味着语料中同时存在原始版与修订版,天然构成时间冲突场景。1,005 个时间性 QA 问题则要求答案必须锚定到特定报告期与特定版本。这种设计使评测能够直接暴露“数字正确但版本错误”的失效,而非仅仅测试模型能否检索到相关段落。
哪些场景会真正需要它
金融研究是这个方法最直接的应用场景,因为评测本身就在这个领域完成。但作者的视野更广:企业 Agent 在处理不断变化的合规政策、修订版合同、历史业务记录、或者每隔几周就更新一次的文档时,都会遇到同一类问题。
仅仅知道一个事实为真是不够的。Agent 需要知道它在什么时候为真、由哪个来源支撑、以及它对当前正在回答的问题是否有效。作者明确表示这些是潜在应用方向,而非已投入生产的声明——当前评测也仅限于金融时间性 QA。
留给 Agent 构建者的开放问题
文章结尾抛出的问题针对所有处理动态业务数据的人:你如何处理时间冲突与修订信息?你是去验证 Agent 实际使用了哪个版本的事实,还是主要依赖检索分数、引用和最终答案评测?
作者的观点可以概括为一句话:Agent 知道某个事实何时为真,与知道它是否为真同样重要。 在越来越多 Agent 接入实时业务数据的背景下,"时间版本"这一维度的工程化,可能比继续堆叠推理能力更值得投入。
完整方法论与评测见研究论文(DOI: 10.5281/zenodo.22116070)。
相关推荐

Hermes Agent零基础教程:自进化AI智能体实战
Hermes Agent零基础教程:详解这个GitHub两月获41.7K星的开源自进化AI智能体,从Harness Engineering核心理念、学习循环、三层记忆系统到WSL安装与实战配置,小白也能轻松上手。
AI Agent落地实战:用WorkBuddy打造智能办公助理
本文通过实战案例演示如何用腾讯WorkBuddy完成文件批量转换与归档,对比聊天大模型与AI Agent的能力差异,分析WorkBuddy的积分体系、适用场景与产品定位,为办公自动化选型提供参考。
从单卡瓶颈到千亿参数:大模型分布式并行6大关键问题
基于B站教程梳理大模型分布式并行核心知识:从decoder-only架构的逐token生成与X乘W计算本质出发,解析单卡瓶颈下数据并行、张量并行、流水线并行等6个关键问题,适合私有化部署与模型训练场景的学习者建立系统认知。