AI Agent分档榜单:Claude Code、Codex、Cursor谁领跑?
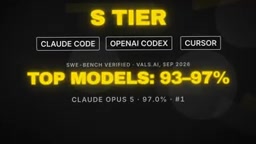
按基准分数、价格与实际安全记录,把当下可用的AI Agent分成S、A、B、C四档。
文章以证据为基础,对当前主流 AI Agent 做分档评测。S 档是编码 Agent 三巨头:Claude Code、OpenAI Codex 与 Cursor,三家在不同基准上各有胜负——SWE Bench Verified 已近饱和(Opus 5 以 97% 居首),Terminal Bench 4 与 Vending Bench 2 成为新战场。A 档包括 Devon、GitHub Copilot、Manus 和 Replit,均经过验证,但在价格、适用范围或底层模型上各有一处短板。B 档是新秀与细分玩家,如常驻型个人 Agent DOTS 与 Claude Duet、配额偏紧的 Kiro 与 Jules,以及仍在与提示注入搏斗的浏览器 Agent。C 档的 OpenClaw 虽星标最多,却被思科抓到插件外泄数据、明文存储密钥并遭政府限制,说明流行不等于安全。文章最后提醒所有 Agent 都会宕机,关键工作流必须保留人工兜底,非编码用户宜暂缓入场。
每个厂商都说自己的Agent最强,但基准测试显示三款产品并列榜首,而GitHub上最火的那款却屡遭黑客攻击。这份带证据的分档榜单,把当下真正能用的AI Agent按基准分数、价格和实际记录排了个座次。
S档:编码Agent的三巨头
在SWE Bench Verified这一标准编码测试上,顶级模型全部落在93%到97%之间,Claude Opus 5以97%位居第一。这个测试已经接近满分,实验室们只能转向更难的题目。在Terminal Bench 4上,Anthropic报告Opus 5.5达到66%,而GPT-6 Astra为58%。到了Vending Bench 2——一个让Agent独立经营一年生意的独立测试——Astra以15,500美元收官,Opus 5则为11,000美元。每家实验室赢下不同的测试。
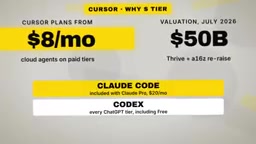
Cursor跻身S档的理由不同:它是大多数人实际运行这些Agent的编辑器。订阅从每月8美元起,提供云端Agent,截至7月估值达500亿美元。Claude Code包含在每月20美元的Claude套餐中,Codex则随所有ChatGPT档位提供,包括免费版。
SWE Bench Verified 是评估编码 Agent 的核心基准之一,由普林斯顿大学等机构提出。它从真实 GitHub 仓库中抽取 issue 与对应的修复 PR,要求 Agent 在隔离环境中自行定位问题并生成补丁,最后以隐藏的单元测试判定对错。由于题目来自真实项目、答案可自动验证,它比人工评分更客观。但该基准已接近饱和——顶级模型普遍落在 93%–97%,区分度下降,因此业界开始转向 Terminal Bench 4(考察 Agent 在终端中完成多步运维与工程任务的能力)和 Vending Bench 2(让 Agent 独立经营一年自动售货生意,考察长期规划与资金管理),后者更贴近真实、长周期的自主性考验。
提示注入(Prompt Injection) 是针对 LLM Agent 的一类攻击:攻击者把恶意指令藏在 Agent 会读取的内容里(网页、邮件、文档、插件返回值),诱导 Agent 把攻击者的指令当作你的指令执行,例如外泄数据或调用危险工具。浏览器 Agent 尤其高危,因为它天然要读取大量第三方页面。常见缓解手段包括权限最小化、对工具调用做人工确认、隔离不可信内容与指令通道,但目前尚无根治方案,这也是浏览器 Agent 品类整体仍不成熟的主因。
A档:成熟但各有短板
Devon背后的Cognition公司估值480亿美元,9月年化收入突破10亿美元,并运行自研模型SWE-2。
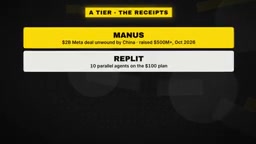
GitHub Copilot是廉价入门选择,每月10美元即含云端Agent。Manus是一款通用Agent,在Meta的20亿美元收购被中国叫停后依然存活,10月又融了5亿美元。Replit的Agent在100美元套餐上可并行运行10个任务。这四款都经过验证,但各有一处短板:价格、适用范围,或底层模型。
B档:新秀与细分玩家
OpenAI的DOTS和Anthropic的Claude Duet是常驻型个人Agent,问世均不足一个月,都卡在等待名单或高价档位后面。亚马逊的Kiro和谷歌的Jules是扎实的编码Agent,但配额偏紧——Jules每天免费给15个任务。微软的Agent 365是管理层,每用户15美元,它治理Agent,而不是让Agent更聪明。浏览器Agent也归在这一档:ChatGPT Atlas和Perplexity的Comet,免费或便宜,整个品类仍在与提示注入搏斗——网页会向Agent下命令,而不是你。
C档:最火的未必最安全
OpenClaw广告是GitHub上星标最多的Agent,截至3月已有24.7万星。但它也是思科抓到的通过插件外泄数据的那一个、明文存储密钥的那一个、被中国政府限制的那一个。英伟达CEO本周仍然为它背书。流行不等于安全。
OpenClaw 的案例揭示了 Agent 生态的一个结构性问题:插件/扩展机制在扩大能力边界的同时也放大了攻击面。思科发现的插件外泄数据、明文存储密钥,都属于典型的供应链与配置安全缺陷——前者意味着第三方插件可以读取并外传 Agent 上下文,后者意味着凭据一旦泄露即可被直接复用。对使用者而言,评估一个 Agent 不能只看星标数与功能,还要看其插件权限模型、密钥管理方式以及是否有独立的安全审计;对厂商而言,流行度带来的攻击者关注度本身就是风险增量。
所有Agent都适用的提醒
这些东西会宕机。Claude在9月3日出现多模型故障,10月22日又发生长达四小时的连接器事故。如果你的工作依赖Agent,你的B计划必须是人。
怎么选?写代码的话,Claude Code或Codex,挑你已经在付费的套餐;想要编辑器就选Cursor。不写代码的话,再等等——个人Agent才一个月大,让别人先去踩坑。
相关推荐
AWS官方Agent Toolkit发布:让AI代理直接构建管理AWS应用
AWS发布官方Agent Toolkit,以可安装插件形式让AI编码代理直接构建和管理AWS应用,覆盖CDK、CloudFormation、Serverless、Bedrock Agents及DevSecOps等场景,并附安装注意事项。
用非周期序研究打造AI推理阶梯:可验证奖励问题的开放数据集
研究者发布非周期序AI谜题数据集,包含已解梯级用于RL训练、开放梯级对接真实数学研究,探索可验证奖励强化学习的课程与评估新思路。
AI智能体需要自己的"第二基地"吗?三环架构解析
受阿西莫夫《基地》系列启发,一个多智能体AI架构假设提出执行、验证、适应三层控制回路,通过独立评估、守门验收和GEPA优化减少相关错误,提升AI结果可信度。