AI Agent为何需要Skills?告别上下文膨胀的模块化方案
Agent Skills通过模块化按需加载知识,解决AI Agent上下文窗口膨胀导致的成本与幻觉问题。
本文介绍了一种应对AI Agent上下文窗口膨胀问题的实践方案——Agent Skills。当Agent接入大量工具和业务知识时,每轮对话都完整加载所有内容,会导致token成本飙升并引发模型幻觉。Skills的核心思路是将知识拆分为模块化技能包,每个技能以一个包含skill.md的文件夹表示。skill.md采用双层结构:轻量的Front Matter仅存储name和description(约25个token),重量的Body则包含详细操作指令。Agent每轮只加载所有技能的Front Matter,由模型根据描述判断所需技能,再按需加载对应Body,从而大幅减少无关知识的加载。此外,Skills具备可移植性,可在团队间或平台上直接复用,降低重复开发成本。
AI Agent在实际应用中有一个绕不开的痛点:上下文窗口(Context Window)膨胀。当你给Agent接入几十个工具、塞进大量组织规则和业务知识后,每一轮对话都要加载这些内容,不仅烧钱,还容易引发幻觉。这篇文章基于一位YouTube技术博主的讲解,拆解一种正在被行业采用的解决思路——Agent Skills(智能体技能)。
上下文膨胀:Agent绕不开的成本陷阱
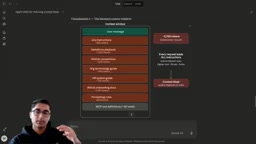
想象一个典型场景:你的Agent连接了一个包含80个工具的MCP(Model Context Protocol)服务器。在每一轮Agent循环中,这80个工具的描述、定义、Schema都会被完整加载进上下文窗口。再加上用户消息、历史上下文,以及一个塞满了Jira使用说明、GitHub规范、Salesforce操作手册的庞大系统提示词(System Prompt),整个上下文迅速被撑爆。
问题的核心在于:并非每个问题都需要全部知识。当用户只是问“我有哪些Jira工单”时,系统却把Salesforce playbook、Wiki文档、新人入职指南等毫不相关的信息一股脑儿加载进来。这些冗余内容带来三个直接后果——token消耗飙升、API成本上涨、以及模型因信息过载而产生幻觉。
博主在之前的内容中提到过“渐进式工具披露”(Progressive Tool Disclosure)作为缓解工具膨胀的手段,而这次讨论的Skills,则是针对知识与指令层面的膨胀问题提出的互补方案。
MCP(Model Context Protocol)是Anthropic于2024年底推出的开放协议,旨在为AI模型与外部工具、数据源之间提供标准化的连接接口。你可以把它理解为AI领域的"USB-C"——任何实现了MCP协议的服务器,都能被兼容的Agent直接调用,而无需为每个工具单独编写集成代码。MCP服务器通常会暴露一批"工具"(Tools),每个工具都携带名称、描述和参数Schema(用于告诉模型如何调用它)。当一个MCP服务器挂载了80个工具时,这些工具的完整描述信息会在每次推理前被注入上下文,这正是上下文膨胀的主要来源之一。
Skills是什么:按需加载的模块化知识包
Agent Skills的本质,是把知识拆分成一个个模块化、可按需调用的包。Agent不再一次性背负所有知识,而是在真正需要时才“即时取用”(just-in-time)对应的技能。
从结构上看,Skills的组织非常直观。你会有一个/skills目录,下面放置若干子文件夹,比如Jira、Salesforce、GitHub,每个代表一项独立技能。关键规则是:任何子文件夹只要包含一个skill.md(Markdown文件),就能被识别为一项可用技能。
技能不止于一个Markdown文件。每个技能文件夹内还可以附带具体的执行资源——比如用于数据分析的Python脚本、自动化的Bash脚本,或是模板、示例文档等。举例来说,如果某项技能需要用pandas生成分析报告,你完全可以把定制脚本放进对应文件夹,让Agent在执行时调用。这种设计让Skills既是知识载体,也是能力载体。
剖析skill.md:Front Matter与Body的双层结构
一个技能的Markdown文件由两部分组成:Front Matter(前置元数据)和Body(主体内容)。
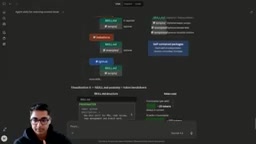
Front Matter只包含两样东西,且仅此两样:name和description。name对应技能名称,description则说明这项技能是什么、何时该被使用。这部分极其精简。
Body则承载真正的细节。以GitHub技能为例,Body里会写明PR(Pull Request)的约定、分支命名规范等具体操作指令。这些是Agent实际执行任务时才需要查阅的详细规则。
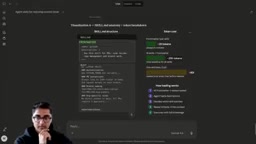
这种双层设计是整个机制高效运转的基础:轻量的Front Matter负责“索引”,厚重的Body负责“执行”,两者分离,各司其职。
Front Matter是一种源自静态网站生成器(如Jekyll、Hugo)的元数据格式,通常以两行 --- 包裹,内部使用YAML语法书写键值对。在Markdown生态中,它被广泛用于存储文档的标题、标签、日期等结构化信息。Skills机制借用这一惯例,将技能的轻量索引信息(name与description)与正文内容在同一个文件中分层存储,既保持了文件的单一性,又实现了"索引与详情"在解析时的物理分离——系统只需读取 --- 块内的少量字段,就能完成技能发现,而无需解析整个文件。
运行机制:模型如何智能挑选技能
理解了结构,再看运行流程就清晰了。
在每一轮Agent循环中,系统只把所有技能的Front Matter加载进上下文窗口——也就是每个技能的name和description。由于这部分极小,博主估算单个Front Matter大约只占25个token。即便你有10个技能,总成本也微乎其微。
接下来是关键一步:模型根据这些description,判断用户的问题需要哪项技能。比如用户问“存在多少个GitHub仓库”,模型凭借GitHub技能的描述就能推断出这是所需技能。一旦确定,系统才把该技能对应的Body完整加载进上下文。
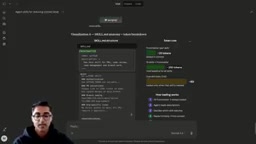
结果就是:上下文窗口里只有GitHub这一项技能的详细指令,Jira的规则、HR系统指南、格式化约定等全部被排除在外。虽然加载Body仍会增加token,但相比把所有知识一次性塞进系统提示词,这种按需加载的方式大幅降低了token占用和调用成本。
可移植性:Skills的另一重价值
除了解决上下文膨胀,Skills还有一个被博主特别强调的优势——可移植性。
如果有人在网上(比如GitHub)发布了一个设计精良的技能,你可以直接把它拷贝进自己的skills目录就能使用。这意味着技能可以像组件一样被分享、复用和沉淀,而不是每个团队都从零编写一套庞大的系统提示词。
写在最后
Skills提供的是一种更优雅的知识组织哲学:与其把所有可能用到的信息一股脑儿倒进单一的系统提示词,不如将它们拆成模块化、可按需调用、可跨项目移植的技能包。对于正在构建生产级Agent系统的开发者而言,这套思路直接作用于三个核心指标——降低token成本、减少幻觉、提升可维护性。随着Agent接入的工具和知识越来越多,这类模块化方案很可能成为标准实践。
这一思路与软件工程中的"延迟加载"(Lazy Loading)原则高度一致:系统资源只在真正被需要时才完成加载,而非在启动时全量初始化。在大型语言模型的推理场景下,每个token不仅意味着API成本,还直接影响模型的注意力分配——过长的上下文会稀释关键信息的权重,这是幻觉产生的机制之一。Agent Skills通过将"知识索引"与"知识内容"解耦,本质上是在用软件架构的方法论来管理LLM的认知负荷,这也预示着未来Agent系统的工程实践将越来越向传统软件设计模式靠拢。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。