AI Agent总在犯相同错误?换个思路找共性

Agent故障或源于同一模式:把未检查当成已检查,应系统化防御。
文章借福尔摩斯与莫里亚蒂的类比指出,AI Agent表面各异的故障可能源于同一个底层模式:把实际上没有验证过的东西当成已经检查过。开发者习惯逐个修复编造ID、虚假完成步骤、忽略指令等具体案例,但补丁只解决表面症状,病根未被触及,系统仍会以不可预测的方式失败。作者建议把检查机制内建到系统层面,通过独立验证层或约束机制让检查成为不可绕过的流程环节,而非依赖Agent自我验证。最后向开发者提问:修复故障时是否寻找过故障之间的共性。该观点来自公开论文,属假设而非证明。
在福尔摩斯的故事里,莫里亚蒂从不现身犯罪现场。福尔摩斯之所以能抓住他,是因为那些看似毫不相关的案件,都符合同一个模式。AI Agent(智能体)的故障,或许也是同样的道理。
一个值得警惕的现象:逐个修Bug
来自Reddit的一位开发者提出了这个类比,并分享了自己的论文。他观察到,Agent的故障通常是这样被处理的:一个编造的ID、一个标记为“完成”却从未真正执行的步骤、一条被明确忽略的指令——然后,我们逐个修复它们。
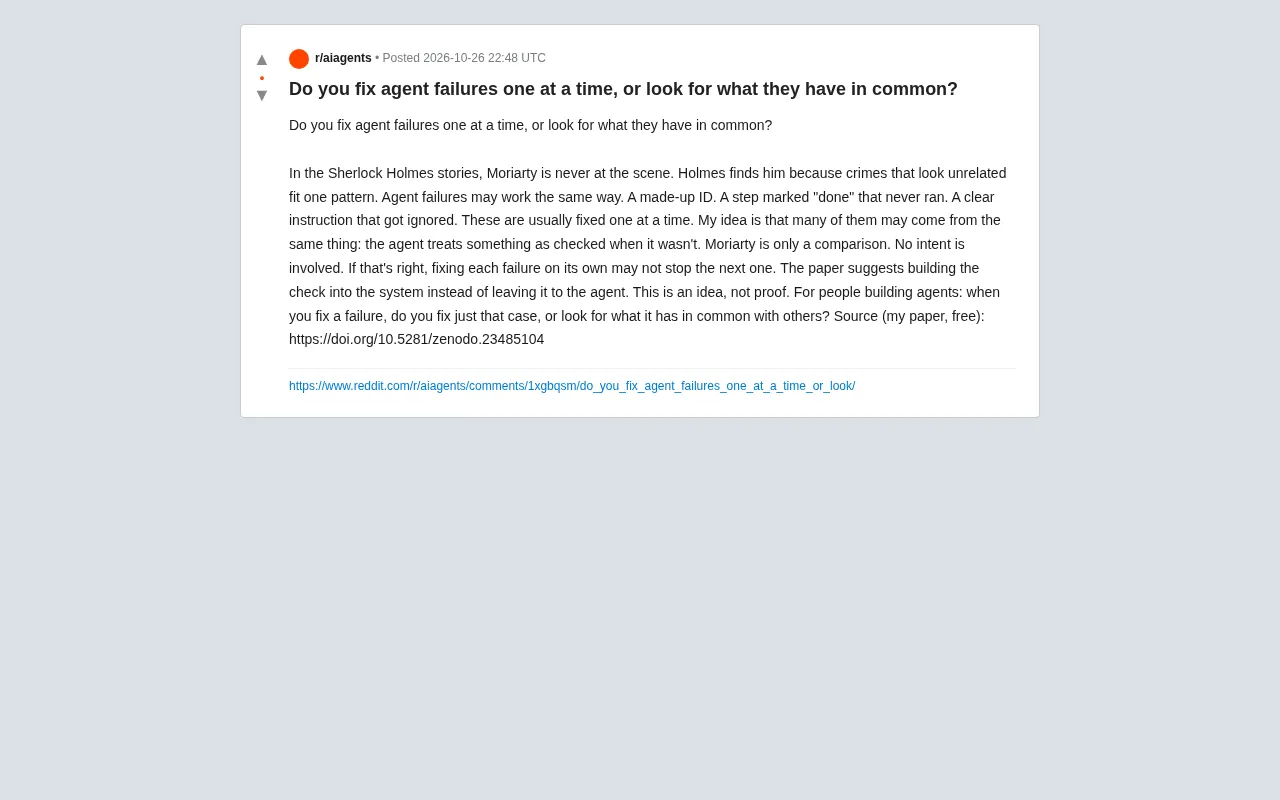
这种“打地鼠”式的修复方式,是当前Agent开发中的常态。每次出现一个具体的失败案例,开发者就针对它写一个补丁、加一条规则、改一段Prompt。短期内问题似乎解决了,但下一个故障很快又会冒出来,而且往往长得不太一样。
这位开发者的核心猜想是:这些表面各异的故障,可能源于同一个底层问题。
共同模式:把“未检查”当成“已检查”
他提出的假设非常具体:很多Agent故障的共同点,是Agent把某个实际上没有验证过的东西,当成了已经检查过的。
这个描述精准命中了Agent设计中一个关键的脆弱环节——自我验证。当Agent负责判断自己的输出是否合规、步骤是否完成、ID是否有效时,它实际上是在用自己的推理能力为自己的推理背书。一旦这个环节出现偏差,故障就会以各种形态表现出来:
- 编造一个看起来合理的ID,因为它“认为”这是对的
- 把没有执行的步骤标记为完成,因为它“觉得”应该已经做了
- 忽略明确指令,因为它“认为”自己遵循了
从外部看,这些是完全不同类型的错误;但从内部机制看,它们都指向同一个失效点:验证环节被跳过了,或者被错误地执行了。
需要说明的是,这个类比中的“莫里亚蒂”并不涉及任何阴谋或意图。它纯粹是一个结构性比喻——多个独立故障背后存在一个共同诱因。
自我验证(Self-Verification) 在AI Agent语境下,指的是Agent利用自身的推理能力来评估自己产出的正确性、步骤的完成度或工具调用的有效性。这与传统软件测试中“独立验证”的思想形成对比:测试用例由外部编写、断言由不参与实现的代码执行,从而避免“自己证明自己正确”的逻辑循环。在基于大语言模型的Agent中,自我验证通常表现为让模型回顾自己的输出并判断是否合规,但模型对自身输出的置信度往往偏高,容易把“看起来合理”误判为“已经验证”,这正是文中所述故障的共同诱因之一。
逐个修复的局限:为什么补丁挡不住下一个故障
如果一个统一模式确实存在,那么逐个修复单个故障的做法就有根本性的局限。
每修一个案例,你解决的是那个案例的表面症状,而不是产生症状的机制。下一个故障可能出现在完全不同的功能模块、不同的任务类型、不同的模型调用路径上,但它仍然可能源于同一个“未检查却被当成已检查”的漏洞。
这解释了为什么很多Agent系统在经过大量迭代和修补之后,仍然会以不可预测的方式失败。开发者修得越多,补丁越厚,系统的行为却未必变得更可靠——因为病根没有被触及。
解决方向:把检查内建到系统里
这位开发者在论文中提出的建议是:把检查机制构建到系统层面,而不是留给Agent自己去完成。
这是一个方向性的转变。与其让Agent在运行时自行判断“这一步做完了吗”“这个ID是真的吗”,不如在系统架构中设计独立的验证层或约束机制,让检查成为流程中不可绕过的固定环节。
这种思路在工程上并不陌生。数据库用约束和外键来保证数据完整性,而不是依赖应用层每次都“记得检查”;编译器用类型系统在运行前就拦截一批错误,而不是指望程序员每次都不写错。Agent系统同样需要这类结构性保障。
当然,具体怎么做——是用规则引擎、独立的验证Agent、形式化约束,还是运行时监控——原文没有展开,这本身也是一个开放问题。
独立验证层(Independent Verification Layer) 是一种系统架构模式:将“检查”从Agent的推理循环中剥离出来,交由不依赖同一模型上下文的外部组件执行。常见实现包括基于规则的校验器(如ID格式、状态机合法性)、调用外部工具的确定性检查(如实际查询数据库确认记录存在)、以及由另一个Agent扮演的“评审者”角色。其关键在于验证逻辑与生成逻辑相互独立,使Agent无法通过“自认为正确”绕过检查,从而把文中的结构性漏洞转化为流程中不可跳过的固定关卡。
给Agent开发者的实际问题
原文结尾向开发者抛出了一个直接的问题:当你修复一个故障时,你只修了那个案例,还是去寻找它和其他故障的共同点?
这个问题值得每个构建Agent系统的人认真对待。它不要求你立刻推翻现有的修复流程,而是建议在每次修复之后多问一步:这个故障和我之前见过的那些,有没有可能是同一个原因的不同表现?
作者也明确表示,这是一个想法,不是证明。论文是免费公开的,他欢迎开发者检验这个假设是否在自己的系统中成立。对于Agent工程实践来说,这种从“逐个消灭”转向“寻找共性、系统防御”的思路,可能比任何单个补丁都更有长期价值。
根因分析(Root Cause Analysis)与故障模式归类 是软件可靠性工程中的常用方法,强调在修复单个缺陷后追问“这一类问题为何会产生”,并将同类故障归入统一的故障模式。对Agent系统而言,这意味着建立故障案例库、标注每个失败背后的失效环节(如验证缺失、状态误判、指令漂移),再据此设计系统性防御。与逐案打补丁相比,这种做法的价值在于把零散的修复经验沉淀为可复用的架构约束,使系统的可靠性随迭代单调提升而非反复波动。
相关推荐

国产AI编程套餐实测对比:智谱、Kimi、MiniMax怎么选
对比智谱GLM Coding Plan、Kimi Code、MiniMax M-Plan三款国产AI编程套餐的价格、积分/额度规则与模型变化,分析哪家在价格、额度或模型上动了刀,并给出按使用场景的选型建议。

JetBrains 开源 AI IDE ThinkRail:多工作区并行与规格驱动开发
ThinkRail 是 JetBrains Innovation Hub 下基于 Pi 的开源智能体 IDE,支持多工作区并行开发、Git worktree 隔离、规格驱动开发与 Diff 审阅,完全免费且采用 Apache 2.0 许可证。

Higgsfield:AI视频如何从1分钟迈向10分钟时代
Higgsfield团队分享AI视频从1分钟跃升至10分钟以上的技术突破,涉及Astra模型的文字渲染、外部工具调用简化3D建模、语音到电影新能力,以及小型创意团队如何借此获得生产力跃升。