AIGC大模型入门:从提示词到Agent实战全解析

从文字生成到 RAG 与 Agent,拆解大模型落地路径与变现案例。
文章基于一位 B 站 UP 主的零基础 AIGC 课程,系统梳理了大模型能力的完整落地路径。文字生成被视为最基础也最实用的能力,语音转文字加摘要可分钟级完成信息分发;提示词工程在官方指南发布后趋于标准化,掌握结构化表达即可覆盖多数场景;图片、语音、视频等多模态生成已有头像转卡通、赛事解说、批量短视频等变现案例。RAG 知识库通过检索增强让模型基于指定文档作答,有效抑制幻觉,适用于法律条文匹配与客服产品问答。AI Agent 与系统集成则面向股票分析等多步骤复杂任务,以及通过聊天记录分析购买意愿提升成交率。文章最后给出零基础学习路径:先跑通低门槛链路建立体感,再理解 RAG 检索逻辑,最后尝试 Agent 编排。
AIGC 的能力边界正在快速扩展,但很多人对大模型的理解仍停留在“聊天工具”层面。一位 B 站 UP 主在零基础课程中系统梳理了从文字生成、提示词工程到 RAG 知识库、AI Agent 的完整路径,并给出了若干可直接落地的副业与效率提升案例。本文基于该课程内容,结合技术视角做一次深度拆解。
一、文字生成:被低估的职场基本功
课程开篇强调一个判断:文字输出是大模型最基础也最实用的能力。UP 主举了一个真实场景——老板在会议上发言,语音转文字后生成摘要,发言结束一分钟内摘要就已发到公司群。这种“语音转文本再摘要”的链路,几乎不需要额外开发,却能把职场信息流转效率提升一个量级。
同一能力还可延伸到内容创作。课程提到有学员学完后到小说网站创作短篇,以二十到三十元的单价尝试变现。UP 主的观点是,文字生成既可以做效率工具,也可以做小成本创业项目,关键在于把模型能力嵌入具体工作流,而不是停留在“让它写一段话”。
二、提示词工程:从追捧到“够用就好”
关于提示词工程(Prompt Engineering),UP 主给出了一个务实的观察:ChatGPT 官方发布提示词指南后,社区对“提示词工程”的讨论热度明显下降,因为官方已经给出六大类写法。但官方文档篇幅较长,因此课程将其压缩为两页 PPT 的核心要点,供学习者直接套用。
这里隐含的行业趋势是:提示词正从一门“玄学”变成产品内置能力。模型厂商通过文档和默认行为降低了使用门槛,普通用户不必深究复杂框架,掌握结构化表达(角色、任务、约束、示例)即可覆盖大部分场景。真正拉开差距的,是后面要讲的 RAG 与 Agent。
三、多模态生成:图片、语音与视频的落地案例
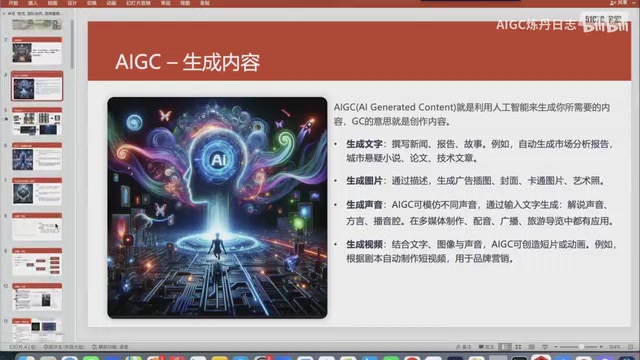
课程展示了 AIGC 在图像与视频侧的具体玩法。图片方面包括广告插图、卡通头像、艺术照片,UP 主现场展示的配图即由 ChatGPT 的图像能力生成。语音方面,通过视频转文字、再调用大模型生成解说音频,已被用于足球比赛解说类内容。视频方面,用大模型写文案、配合剪映类工具加图片合成,可批量产出“网络爽文动画版”短视频。
更具参考价值的是 IP 衍生玩法:GIF 生成借助代码解释器,把九宫格图片切割排序后逐帧播放,过去需要手动贴图的繁琐流程,现在一段提示词即可完成。UP 主还提到有学员在淘宝售卖真人头像转卡通头像服务,定价九块九,从早期一天十来单的量级起步——这类轻资产模式验证了“模型能力加简单包装”的商业可行性。
四、RAG 知识库:让大模型少“胡说八道”
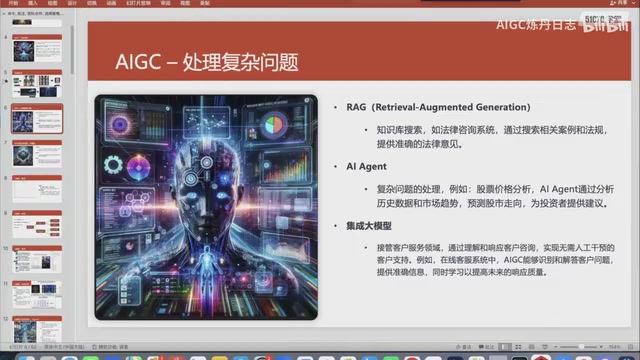
课程把大模型应用分为 2C 与 2B 两个流派。2C 侧重内容生成与个人变现,2B 则面向企业规划与复杂问题处理,RAG(检索增强生成)是其中的代表技术。UP 主用“企业法律条文库”举例:打官司时把案情输入知识库,系统自动匹配相关条文,而非让模型凭记忆编造。
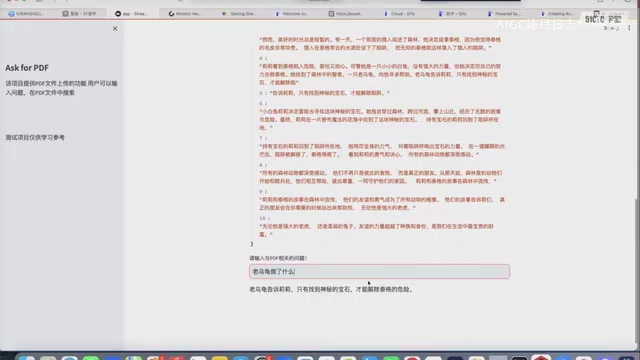
为了演示 RAG 如何抑制幻觉,课程用了一个 PDF 问答案例:上传一个关于泰格与莉莉的童话故事 PDF,系统将其切分为约 11 个块。直接问百度千帆模型“莉莉和泰格是什么关系”,模型并不知情;而经由知识库检索后,模型能准确回答“朋友关系”。追问“老乌龟做了什么”,知识库同样给出了“找到神秘宝石才能解救泰格”的原文答案。
这一机制在客服场景中价值更直接。UP 主演示了自定义 GPT 搭建的客服助手:上传“好梦来”被套的 TXT 产品文档后,询问产品介绍时,模型优先从文档库取信息,而不是把网上泛泛的被套知识倒给用户。对企业而言,这意味着可以控制模型“该说什么”,把推荐产品和业务信息通过知识库精准传达。
什么是“幻觉”(Hallucination)
幻觉指大模型生成看似合理但与事实不符、或与给定上下文不一致的内容。它源于模型本质上是基于概率预测下一个词,而非查询事实数据库,因此当训练数据缺失或问题超出知识范围时,模型会“编造”答案。RAG 通过先从外部文档库检索相关片段、再让模型基于这些片段作答,把“凭记忆回答”变成“开卷考试”,从而显著降低幻觉率。衡量幻觉的常见方式包括人工核验、与参考答案比对,以及让模型标注答案出处。
向量检索与文本切块(Chunking)
RAG 的核心步骤之一是检索。文档通常先被切分为若干文本块(chunk),再通过嵌入模型(Embedding Model)转为向量存入向量数据库;用户提问时同样转为向量,通过相似度计算召回最相关的块。切块大小直接影响效果:块太大则噪声多、检索不精准,块太小则上下文丢失。课程中 PDF 被切为约 11 个块,正是这一流程的体现。向量检索之外,也有基于关键词的 BM25 等稀疏检索方式,实际系统常将两者结合。
五、AI Agent 与系统集成:复杂问题的解法
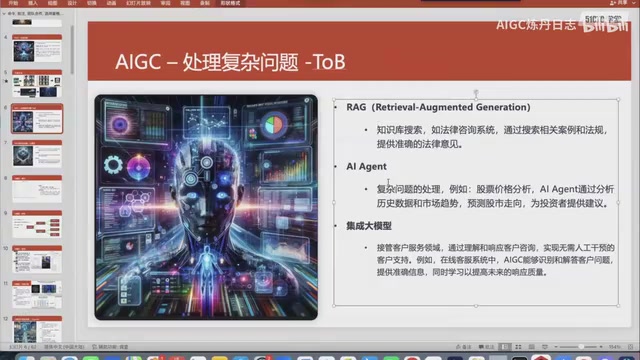
对于股票分析这类复杂任务,单一提示词无能为力。课程拆解了完整链路:先定位股价数据网站,下载数据需要写代码,代码可能出错需要监督重跑,数据下来后要比对历史数据,比对同样依赖代码,最后还要生成图表供投资建议。这一串步骤涉及取数、纠错、比对、可视化多个环节,正是 AI Agent 的用武之地。课程提到会介绍微软的 AutoGen 架构来编排这类多步骤任务。
另一条路径是集成。大量企业系统(APP、OA、内部管理系统)是多年前开发的,接入大模型后可焕发新能力。UP 主分享了一个客服系统案例:通过客户聊天记录分析购买意愿,把高意向客户抽离出来,从而提升成交率。相比过去只能做“包不包邮”“几天退货”的象征性问答,这种基于对话数据的意向识别才是大模型集成的真正增量。
AutoGen 与多智能体编排
AutoGen 是微软开源的多智能体(Multi-Agent)框架,核心思路是把复杂任务拆给多个具备不同角色与工具的智能体协作完成。开发者可以定义“写代码的智能体”“审查代码的智能体”“执行代码的智能体”等角色,由框架管理它们之间的对话与消息传递,并通过代码执行器实际运行生成的代码、把报错反馈给智能体修正。这与课程中“取数—纠错—比对—可视化”的链路高度吻合。与单 Agent 相比,多智能体编排更擅长需要分工、互检和迭代的任务,但也带来 token 消耗高、调试复杂、收敛不稳定等工程挑战,实际落地时通常需要设置最大轮次与终止条件。
Function Calling 与工具调用
大模型本身只能生成文本,无法直接查数据库、调接口或执行代码。Function Calling(函数调用)机制让模型在需要时输出结构化的调用请求,由外部程序执行后再把结果回传给模型,形成“思考—行动—观察”的循环。这既是 Agent 的技术底座,也是“系统集成”得以实现的关键:把企业 OA、客服、CRM 的接口封装成模型可调用的工具,模型就能在对话中触发真实业务动作。理解这一机制有助于区分“模型能说”与“系统能做”,也是评估 Agent 方案是否可行的基本前提。
六、课程知识地图与学习建议
综合来看,这套课程覆盖了一条清晰的主线:文字与多模态生成打基础,提示词工程降门槛,RAG 知识库解决准确性与企业数据接入,AI Agent 处理多步骤复杂任务,系统集成则把能力嵌入现有业务流。UP 主对 AIGC 的整体理解可以概括为——用人类能理解的方式生成与理解文字、图片、声音、视频,并在知识库与流程自动化层面提升生产效率。
对零基础学习者,建议的路径是先跑通“语音转文字加摘要”这类低门槛链路建立体感,再用 PDF 问答理解 RAG 的检索逻辑,最后尝试用 Agent 编排一个多步骤小任务。工具会持续迭代,但“把模型能力映射到具体场景”的方法论,才是这套内容真正的价值所在。
相关推荐
LZ4:极速压缩算法的开源标杆
探索 LZ4 极速压缩算法:了解其设计哲学、性能优势以及在 Linux 内核、数据库等领域的广泛应用。12k+ Star 的开源项目如何成为速度标杆。
Agent-Browser:AI智能体的浏览器自动化CLI
Vercel Labs 开源 agent-browser,一个用 Rust 构建、专为 AI 智能体设计的浏览器自动化 CLI 工具,GitHub 星标超 4.5 万,提供命令行优先的浏览器操控能力。
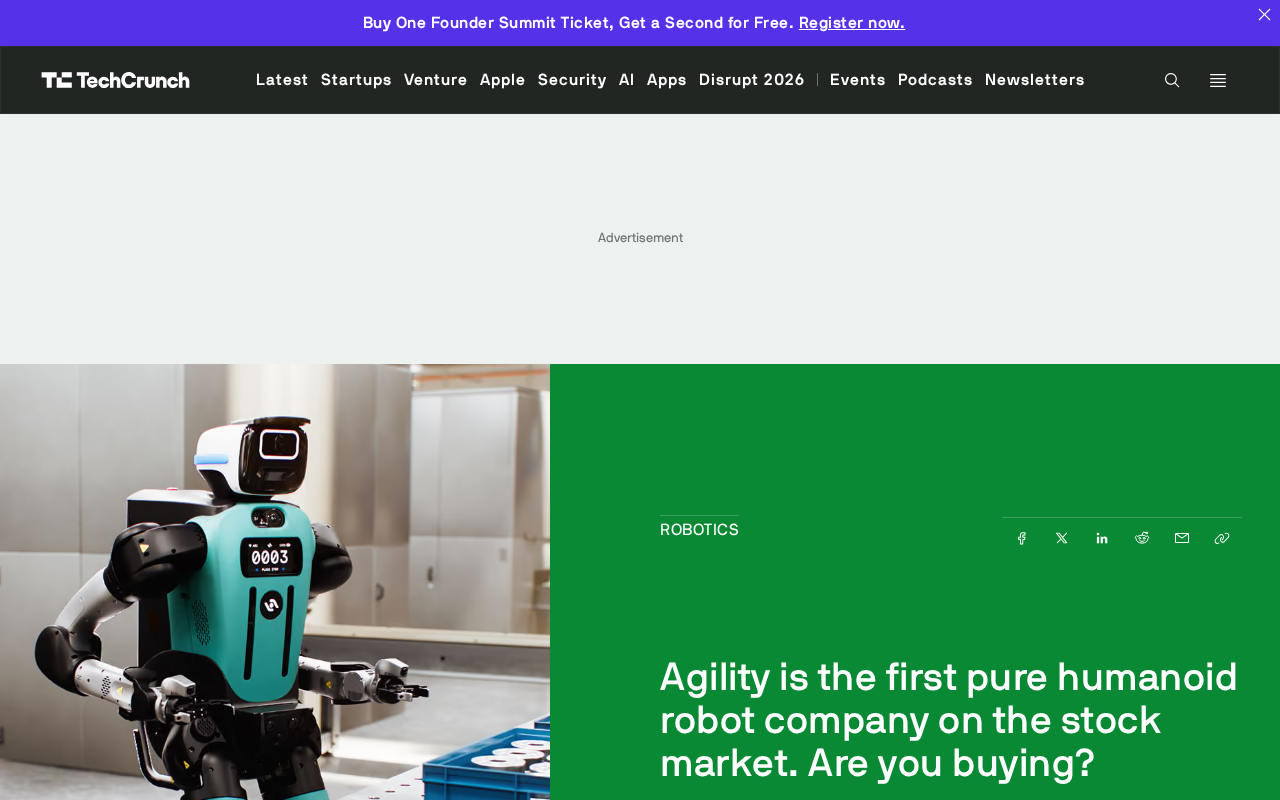
全球首家人形机器人公司Agility登陆纳斯达克,买不买?
Agility以全球首家人形机器人上市公司身份登陆纳斯达克,本文分析这一标志性事件对行业与投资者的意义,拆解纯人形机器人赛道的商业化考题与投资判断框架。