AI模型迭代太快:从o3到Astra,预期通胀下的社区焦虑
一场关于基准测试的社区热议
近日,Reddit上一则以"What are these benchmarks 💀"(这些基准测试到底是什么鬼)为标题的帖子引发热烈讨论。虽然标题带着几分调侃,但背后折射出AI社区一个真实而深刻的现象:模型迭代的速度已经快到让人们的预期完全失控。
基准测试与模型评估体系
基准测试(Benchmark)是AI领域评估模型性能的标准化测试集,如MMLU(大规模多任务语言理解)、HumanEval(代码生成能力)、MATH(数学推理)等。这些测试通过统一的数据集和评分标准,让不同模型的能力可以被量化比较。每种基准测试的侧重点各不相同:MMLU覆盖57个学科的多选题,考察模型的知识广度;HumanEval要求模型根据函数描述生成可执行代码,测试编程能力;MATH则评估从初中代数到竞赛级数学的推理能力。
然而,基准测试也存在严重的局限性:模型可能针对测试集过度优化(overfitting)、测试场景与实际应用存在差距、以及新能力难以被现有测试覆盖等问题。更关键的是,近年来出现了"基准饱和"(Benchmark Saturation)现象——顶尖模型在MMLU等经典测试上的得分已经逼近甚至超过90%,测试的区分度急剧下降。这迫使研究社区不断推出更高难度的测试集,如GPQA(研究生级别的科学问答)、ARC-AGI(抽象推理挑战)和FrontierMath(由陶哲轩等数学家参与设计的前沿数学题库)。这种"出题-解题-饱和-再出题"的循环本身就说明,用固定的数字来衡量快速进化的AI能力,天然存在结构性困境。这也是为什么社区对单纯依赖基准分数产生质疑的原因——真实世界的表现往往比冷冰冰的数字更复杂。
帖子的核心争论围绕即将发布的新模型Astra与现有模型Fable(讨论中提到的Fable 5.1)之间的对比展开。有用户断言"Astra将彻底碾压Fable",但也有理性的声音提醒:我们对每一次发布的期待,往往已经远超技术上可行的进步幅度。
预期通胀:为什么我们总觉得新模型不够好
这场讨论中最值得玩味的观点来自一位资深用户。他坦言:
"我们的期待太高了,我强烈预感新模型发布时会有大量不满情绪——尽管它实际上会比Fable 5.1更好。这就是我们的通病:每次发布,我们都期待超出实际可能的进步。"
这种"预期通胀"现象在AI领域尤为明显。当一个模型刚发布时惊艳众人,但仅仅几个月后,同样的能力就会被视为理所当然,甚至被嘲笑为"愚蠢"。这位用户用亲身经历描绘了这种心理落差:
"当o3发布时,我惊得合不拢嘴。那是16个月前的事了。而现在,o3已经笨得像块石头。"
这句话精准捕捉了AI模型迭代的残酷加速度——今天的顶尖,就是明天的平庸。
技术进步的心理适应滞后
心理学中的"享乐适应"(Hedonic Adaptation)理论指出,人类会快速适应新的刺激水平,将其视为新常态。这一理论最早由Brickman和Campbell在1971年提出,他们发现彩票中奖者的长期幸福感与普通人并无显著差异。在AI领域,这种效应被技术加速度极端放大:曾经需要专家团队数月完成的任务,现在AI几秒就能搞定,但用户很快就习惯了这种能力,转而关注模型的缺陷。这种"能力贬值"速度远快于其他技术领域——智能手机用了十年才让人从惊叹到习以为常,而AI模型只需几个月。
这种预期通胀还对AI公司的商业策略产生了实质影响。公司面临一个两难:发布节奏太慢会被竞争对手超越,太快则每次进步幅度不足以满足已被拉高的预期,导致"wow factor fatigue"(惊艳疲劳)。这种社区情绪的波动会直接传导至投资市场——一次被社区认为"令人失望"的发布,可能引发分析师下调预期,进而影响公司估值。因此,一些公司开始策略性地"管理预期":提前释放保守信号,在发布时制造超预期惊喜。认知这种心理机制和产业博弈,有助于我们更客观地评估技术价值,避免陷入永不满足的期待螺旋。
推理模型诞生:回望那条改变一切的时间线
讨论中,这位用户还梳理了一条颇具历史意义的时间线,凸显AI能力跃迁的断崖式特征。
从无推理到有推理的分水岭
- 2024年9月11日:我们还生活在一个没有推理模型的世界
- 次日(9月12日):o1-preview宣布发布,标志着推理模型时代的开启
- 2025年4月:o3正式发布
- 2026年6月:Fable发布
他强调:"这些都是天翻地覆的变化。"从没有任何具备"思考"能力的模型,到推理模型成为标配,整个转变仅仅发生在一夜之间。这种非线性的、跳跃式的进步,正是让社区不断刷新预期的根本原因。
推理模型(Reasoning Model)的技术突破
推理模型代表了AI发展的范式转变。传统语言模型采用"即时生成"策略,看到prompt后直接输出答案——本质上是通过一次前向传播(forward pass)完成从输入到输出的映射;而推理模型(如OpenAI的o1系列)引入了"思维链"(Chain-of-Thought)机制,在给出最终答案前会进行多步内部推理。
"思维链"的概念可以追溯到Google Brain团队Wei等人在2022年发表的经典论文《Chain-of-Thought Prompting Elicits Reasoning in Large Language Models》,该论文发现,仅仅通过在提示中加入逐步推理的示例,就能显著提升大模型在算术和常识推理任务上的表现。OpenAI的o1系列将这一思路推向了新高度:不再依赖外部提示引导,而是通过强化学习(Reinforcement Learning)训练模型自主学会"何时需要深思熟虑",并在推理过程中动态分配计算资源——这就是"推理时计算"(Test-Time Compute)或"推理时缩放"(Inference-Time Scaling)范式的核心思想。与传统"训练时缩放"(通过增大模型参数和训练数据来提升能力)不同,推理时缩放允许模型在面对困难问题时"多想一会儿",通过消耗更多推理阶段的计算资源来提升回答质量。
这种能力在复杂数学题、编程任务和多步逻辑问题上展现出质的飞跃。o1-preview的发布被视为分水岭,因为它首次让AI展现出类似人类"停下来思考"的行为模式,而非单纯依赖模式匹配。此后,推理模型迅速成为行业标配,Google的Gemini 2.0 Flash Thinking、Anthropic的Claude推理模式以及DeepSeek-R1等都采用了类似架构,标志着整个行业从"快速直觉"向"深度思考"的集体转向。
十二个月的跨度足以颠覆认知
你可能没注意到,尽管单次发布可能让人失望,但拉长到12个月的时间尺度来看,进步是"令人震惊的"。这一观点提醒我们:评价AI进步不应以单次发布为单位,而应以年度甚至更长的周期来审视。短期的失望与长期的震撼,构成了AI发展的一体两面。
模型能力的非线性进步特征
AI模型发展呈现出明显的非线性特征,即能力提升不是匀速的,而是呈现出长期平缓+突然跃迁的"阶跃函数"模式。这与深度学习的"涌现现象"(Emergence)有关——当模型规模、数据量或训练方法跨越某个临界点时,会突然展现出训练时未明确优化的新能力。例如GPT-3到GPT-4的代码能力飞跃、推理模型的突然出现等。
值得注意的是,"涌现"本身也是学术界激烈争论的话题。2023年,斯坦福大学的研究者Schaeffer等人在Nature上发表论文,提出涌现能力可能并非模型内在属性的突变,而是评估指标选择造成的统计假象——当使用非线性的评估指标(如精确匹配)时,模型表现看起来会突然跃升;但如果换用连续性指标(如token级别的对数概率),能力提升实际上是平滑渐进的。这意味着我们感知到的"突然变聪明"可能部分源于测量方式的偏差,而非能力本身的不连续跳跃。
无论涌现是"真实跃迁"还是"测量幻觉",这种非线性特征使得预测下一代模型能力变得极其困难,也是"预期通胀"产生的技术根源:人们往往线性外推过去的进步速度,却无法预知下一个能力跃迁(或看起来像跃迁)何时到来。
Astra何时发布?社区的侦探游戏
围绕Astra的发布时间,社区展开了一场有趣的推理:
- 有人称"Astra据说明天就来"
- 有人认为"理论上是两天后"
- 更有意思的是,博彩市场上出现了针对"15日"发布的大额押注,交易量异常之高,被怀疑存在内部消息
预测市场在AI领域的兴起是一个引人注目的现象。Polymarket、Metaculus等平台允许用户用真金白银(或积分)对未来事件下注,通过市场价格机制汇聚分散的信息和判断。在AI领域,从"GPT-5何时发布"到"AGI何时实现"都有对应的预测合约。理论上,当有人掌握内幕信息时,他们会通过大额押注获利,而这种异常交易行为本身就成为信号——这正是社区注意到"15日"合约交易量激增后怀疑存在内部消息的逻辑。预测市场并非总是准确,但它提供了一种比社交媒体传言更结构化的信息聚合方式。
从模型"降智"推测发布节奏
一个颇具技术洞察的推测是:近期模型出现了明显的性能下降现象,而根据以往经验,新模型发布前几周往往会有此类算力和能力的调整。因此,用户推断"15日"这个日期具有可信度。
这种通过观察现有模型性能波动来预测新模型发布时间的方法,虽然带有社区玄学色彩,但也反映出用户对模型行为的敏锐感知——发布前的资源重新分配,确实可能导致现有服务出现临时性能下降。
AI服务的算力调度与性能波动
大型AI模型的运营需要庞大的GPU集群支持。以GPT-4级别的模型为例,单次推理可能需要调用数千亿参数,消耗大量的GPU显存和算力。当公司准备发布新模型时,需要将算力从现有服务迁移到新模型的训练、测试和部署上,这会导致旧模型的推理速度变慢或响应质量下降。
此外,云服务商通常采用动态资源分配策略,根据负载情况调整模型实例数量。用户观察到的"降智"现象可能源于多种技术原因:模型服务降级(将请求路由到能力较弱的备用模型)、使用了更小的蒸馏版本(通过知识蒸馏技术将大模型的能力压缩到小模型中,以降低成本)、量化精度降低(将模型权重从FP16降到INT8甚至INT4,减少显存占用但牺牲精度)、或者采样参数(如temperature、top-p)被调整以节约计算资源。还有一种可能是KV Cache(键值缓存)管理策略的变化——在高负载时,服务可能缩短上下文缓存时间,导致长对话的连贯性下降。
资深用户通过这些细微变化来推测公司动向,形成了一种独特的"服务考古学"文化——通过分析API延迟、回答质量波动、错误率变化等外部可观测信号,逆向推断公司内部的资源调度和产品规划。这也反映出AI服务的运营复杂性远超传统软件,因为模型不是确定性程序,其表现天然受到计算资源、批处理策略和动态路由等因素的影响。
加速时代的心理适应:当惊艳变成日常
这场看似轻松的社区讨论,实际上触及了AI时代一个深层命题:当技术进步的速度超越人类心理适应的速度时,我们该如何自处?
一方面,我们享受着前所未有的能力跃迁;另一方面,满足感却在不断贬值。正如那位用户所说:"我们将在有生之年见证疯狂的东西。"这既是兴奋,也隐含着某种不安——当16个月前的天才变成今天的"笨蛋",我们该如何锚定自己对技术的判断?
未来学家Alvin Toffler早在1970年的《未来的冲击》(Future Shock)中就预言了这种困境:当变化速度超过人类适应能力时,人们会产生方向感丧失、决策困难和焦虑感。半个世纪后的AI时代,这种"未来冲击"正在以前所未有的烈度上演。不同的是,当年Toffler描述的是工业社会的变迁节奏,而今天AI模型的迭代速度已经将变化压缩到了以月计的尺度。
对于AI从业者和关注者而言,这场讨论提供了三个实用的思考框架:
- 以长周期衡量进步:避免被单次发布的短期落差误导,至少以12个月为单位评估模型能力变化
- 警惕预期通胀:理性设定对新模型的期待,认识到渐进式改进同样有价值
- 关注结构性突破:比起基准测试分数的提升,推理能力的诞生这类范式变革才是真正的里程碑
结语
无论Astra最终是在"明天"还是"15日"发布,无论它是否真能碾压Fable,这场讨论本身已经揭示了AI发展的一个核心真相:我们正处在一个进步速度远超预期、也远超心理适应能力的时代。
保持敬畏,也保持理性——或许是我们面对这场AI模型迭代狂潮时,最值得坚守的态度。
核心要点
核心要点
相关推荐
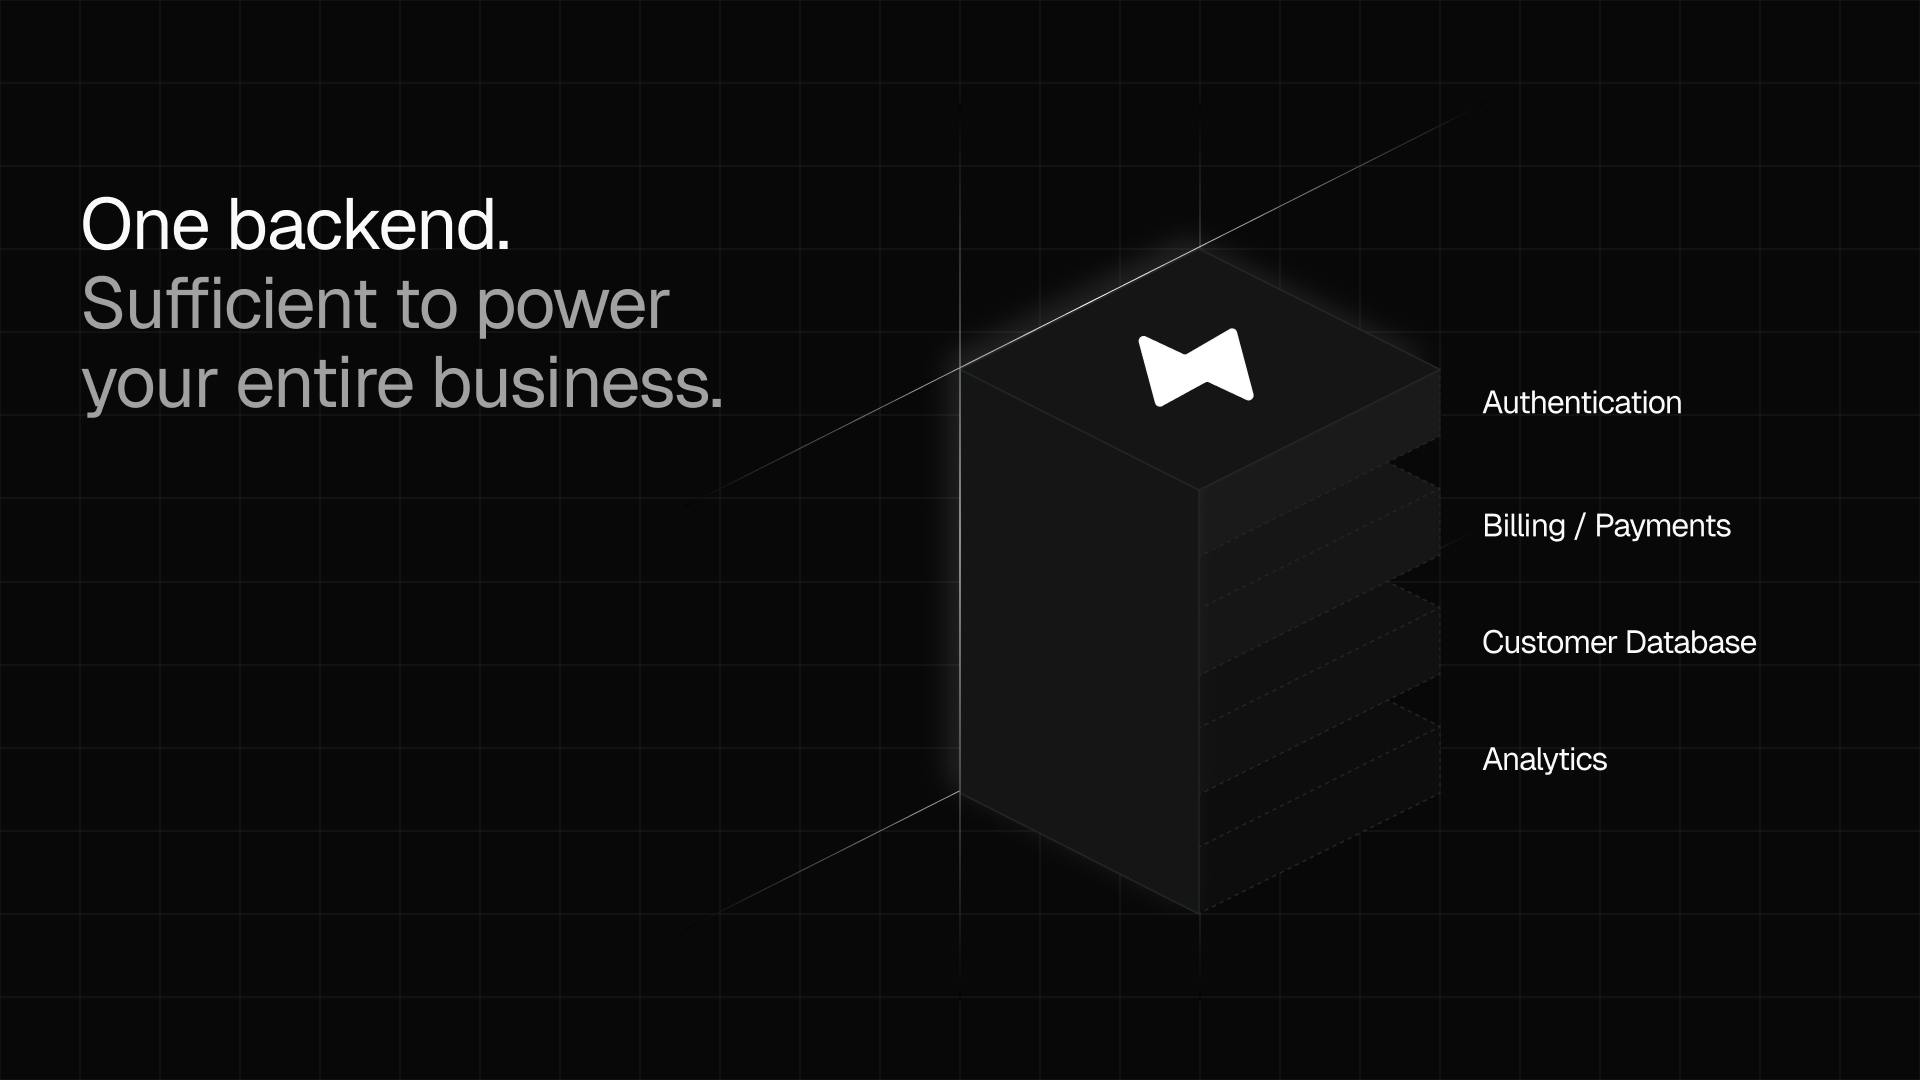
tiun.:为AI开发者打造的一站式认证与支付系统
登顶 Product Hunt 的 tiun. 为 AI 开发者提供认证、支付、账单、客户数据与分析的一体化系统,一条命令即可安装,帮助开发者当天上线付费产品。本文解析其定位、卖点与竞争格局。
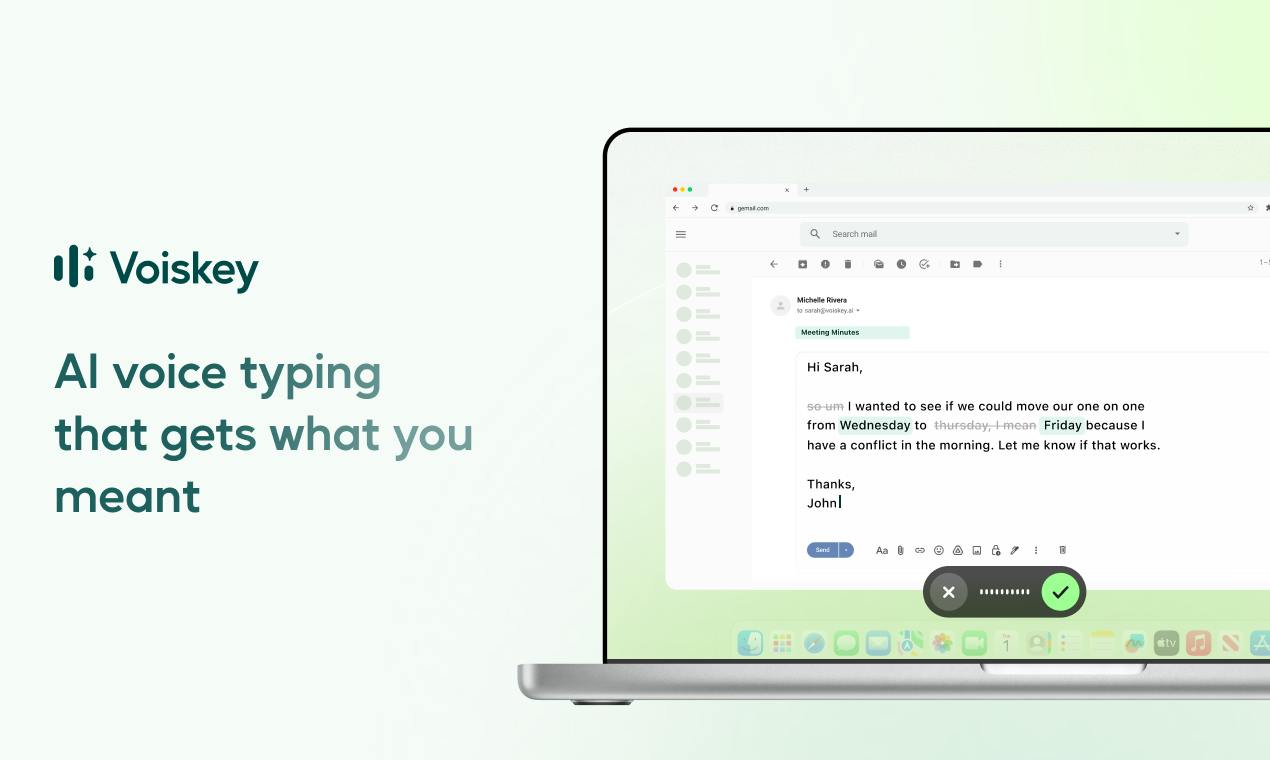
Voiskey:能读懂语境的AI语音输入工具
Voiskey是一款登上Product Hunt排名第3的AI语音输入工具,能根据场景和读者自动调整语气,比打字快5倍,支持iOS、macOS、Android、Windows四大平台及100多种语言。
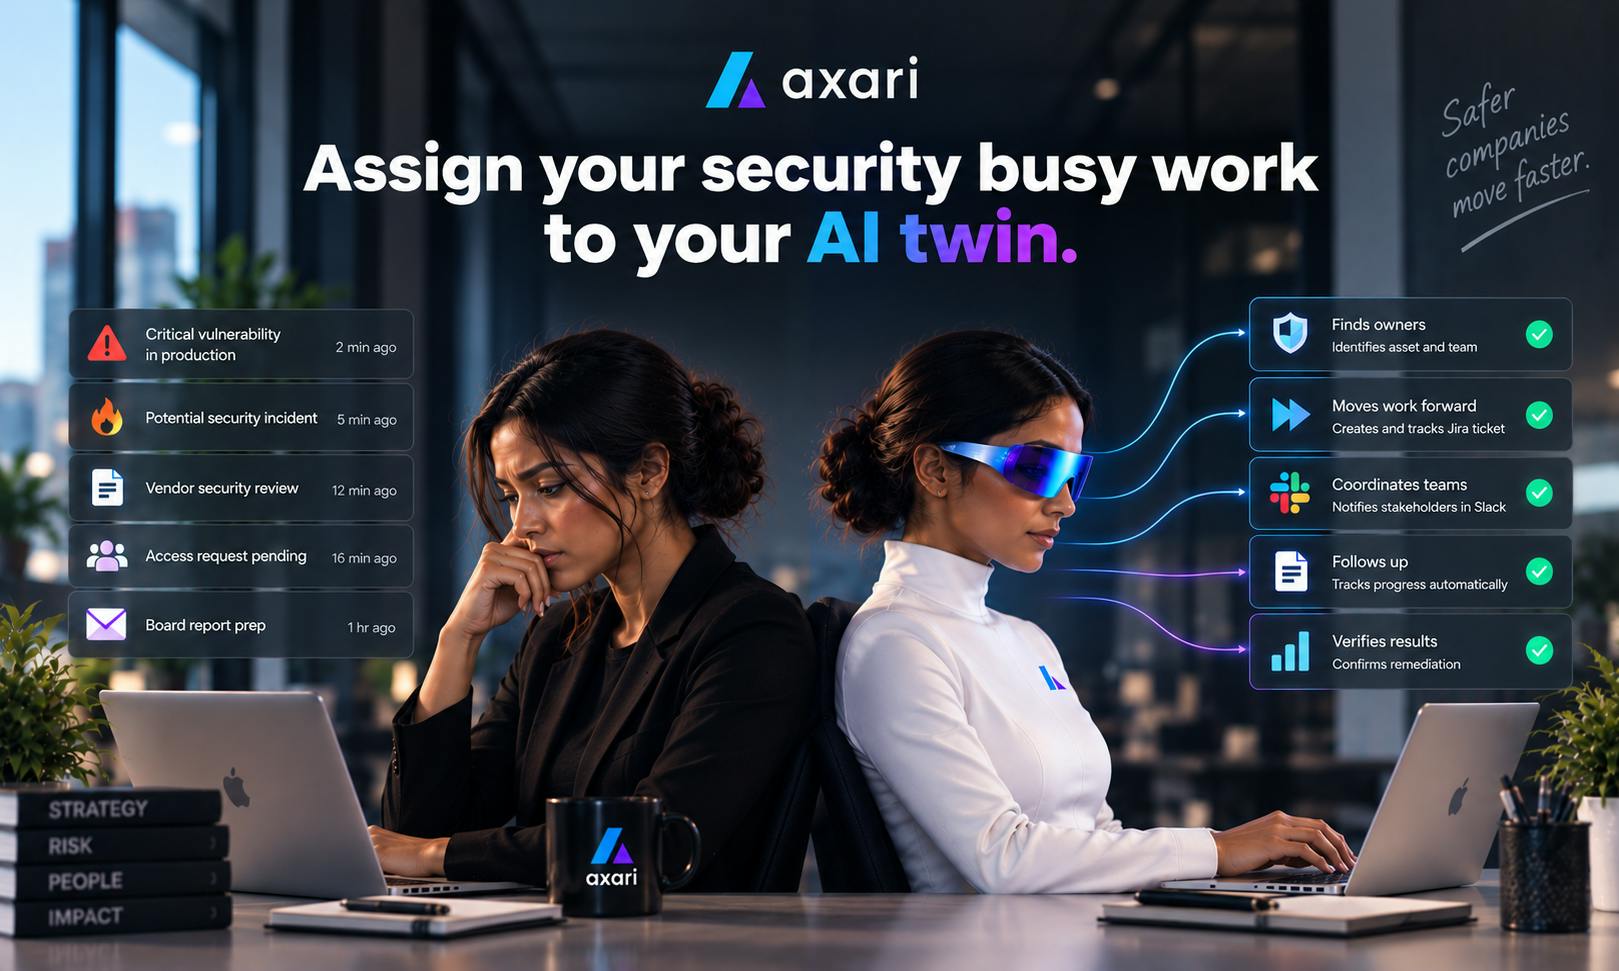
Axari:让AI分身接管你的安全运营琐事
Product Hunt新品Axari主打「AI分身」概念,帮安全团队自动处理重复性运营琐事,可在Slack、MS Teams中指派目标并自主推进任务。本文解析其产品逻辑、行业定位与需要冷静看待的问题。