AI驱动Playwright:智能Agent实现Web与接口自动化测试实战
从Playwright到Claude Code,AI驱动自动化测试正从人写脚本转向自然语言定义意图、Agent智能执行的新范式。
本文梳理了一套三层递进的AI自动化测试技术路径:第一层以Playwright为核心,通过语义化定位和多浏览器兼容能力夯实Web自动化基础;第二层引入AI智能体驱动接口测试,借助OpenAPI规范自动生成用例,并打通pytest断言与CI/CD流水线;第三层以Claude Code驱动Agent,实现"自然语言表达意图、AI拆解执行"的高阶测试模式,同时提出Skills设计与LLM评测体系两个进阶概念。文章强调,AI是效率杠杆而非人工替代——Agent生成的用例仍需审核,扎实的测试工程基础决定了从业者能将AI能力发挥到何种深度,掌握Playwright与AI Agent组合技能是测试工程师在AI时代保持竞争力的明确方向。
AI与自动化测试的结合正在改变传统测试工程师的工作方式。过去需要大量手写脚本、维护定位器、调试断言的工作,如今可以借助大语言模型和智能 Agent 来大幅简化。本文基于一套面向零基础及进阶学习者的 AI + 自动化测试教程,梳理其核心技术路径,帮助你理解如何用 Claude Code、Playwright 与 Agent 构建完整的智能测试体系。
Web 自动化:从 Playwright 浏览器控制入手
整套体系的第一层能力是 Web 端自动化,核心工具是 Playwright。作为微软推出的现代化浏览器自动化框架,Playwright 支持对 Chromium、Firefox、WebKit 等多浏览器内核的统一控制,这正是它相比传统 Selenium 更受青睐的原因之一。
入门阶段需要掌握两个关键点:一是浏览器自动化的基础控制流程,包括页面导航、点击、输入、等待等常见操作;二是元素定位技术。元素定位往往是自动化测试中最脆弱的环节,页面结构一变脚本就失效。Playwright 提供的语义化定位(如按角色、按文本定位)能显著提升脚本稳定性。教程强调多浏览器兼容实战,意味着同一套测试用例可在不同浏览器环境下复用,这对保证 Web 应用跨端一致性尤为重要。
Playwright 与 Selenium 的核心差异值得深入了解。Selenium 诞生于2004年,长期依赖 WebDriver 协议通过 HTTP 与浏览器通信,这种架构导致执行速度慢、网络抖动时易出现竞争条件(race condition)。Playwright 则采用 Chrome DevTools Protocol(CDP)直接与浏览器进程通信,绕过了中间层,带来更快的执行速度和更可靠的等待机制。更重要的是,Playwright 内置自动等待(auto-wait)能力——它会在执行操作前自动检测元素是否可见、可交互,从而大幅减少因页面加载时序问题导致的测试抖动(flaky test)。语义化定位方面,Playwright 推荐使用 getByRole、getByText、getByLabel 等贴近用户视角的定位器,相比 XPath 或 CSS 选择器,这类定位器与页面 DOM 结构耦合度更低,当开发者调整样式或重构 HTML 时,测试脚本无需随之修改,从根本上降低了维护成本。
接口自动化:AI 智能体打通测试全流程
第二层能力从 UI 层深入到接口层。UI 自动化虽然直观,但执行慢、维护成本高;接口测试则更快、更稳定,是自动化测试金字塔的中坚部分。
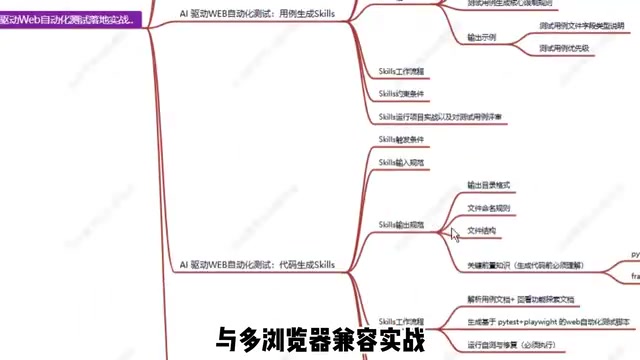
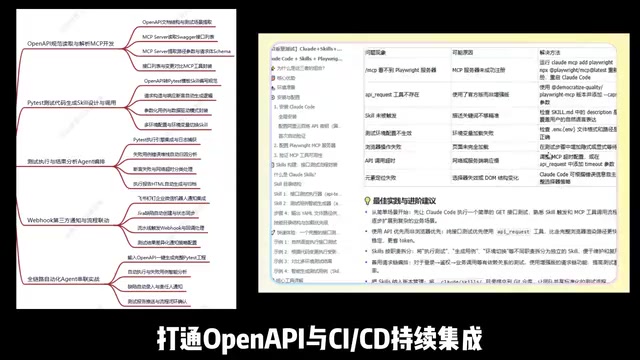
这一模块的核心是用 AI 智能体驱动接口测试,覆盖从请求构造、断言校验到持续集成的完整链路。教程提到 pytest 断言机制的全流程打通——pytest 作为 Python 生态中主流的测试框架,其断言与参数化能力是接口测试的基础。更进一步,通过对接 OpenAPI 规范,AI Agent 可以直接读取接口文档,自动生成对应的测试用例,减少人工编写的重复劳动。
将这些测试接入 CI/CD 持续集成流水线,是让自动化真正产生价值的关键一步。只有当测试能够在每次代码提交时自动运行,才能形成快速反馈闭环,及时拦截缺陷。
OpenAPI 规范(原名 Swagger)是描述 RESTful API 接口的标准格式,以 JSON 或 YAML 文件定义接口路径、请求参数、响应结构及认证方式。其机器可读的特性使它天然适合被 AI Agent 解析——Agent 读取 OpenAPI 文档后,可自动提取每个接口的入参类型、必填字段和响应 Schema,进而生成覆盖正常路径、边界值和异常情况的测试用例,而无需人工逐一编写。这种方式的价值在于,当接口文档更新时,测试用例可以随之自动重新生成,保持与后端实现的同步,解决了传统接口测试中"文档与测试用例脱节"的长期痛点。pytest 的参数化功能(@pytest.mark.parametrize)则是批量执行这类自动生成用例的关键机制,能将同一测试逻辑对不同数据集循环执行,进一步放大 AI 生成用例的覆盖优势。
AI + Agent 进阶:用 Claude Code 驱动智能测试
第三层是整套体系的进阶重点,也是最能体现"AI 驱动"理念的部分。这里引入了 Claude Code 来驱动 Agent 控制浏览器,实现更高层次的智能化测试。
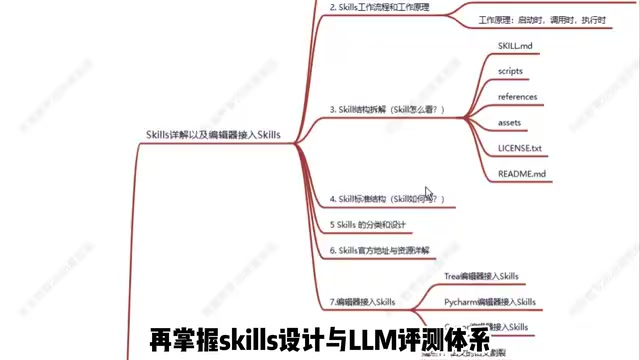
与传统脚本不同,Agent 驱动的测试更接近"描述意图,自动执行"的模式。测试人员可以用自然语言表达测试目标,由 Agent 拆解步骤、调用浏览器工具完成操作。这一模块还涉及两个值得关注的概念:
Skills 设计
Skills 是 Agent 可复用的能力单元,合理的 Skills 设计能让 Agent 在面对不同测试场景时灵活组合调用,而不是每次都从零开始。这类似于给智能体构建一套"测试工具箱"。
LLM 评测体系
当测试引入大模型后,如何评估模型本身输出的质量就成为新课题。教程提出构建 LLM 评测体系,这在当下 AI 应用测试中是刚需——无论是测试 AI 功能,还是评估 Agent 执行的可靠性,都需要一套可量化的评测标准。
LLM 评测(LLM Evaluation)是 AI 应用工程中的新兴专项领域,其难点在于大模型的输出具有概率性和开放性,无法像传统软件那样用简单的"预期值等于实际值"来判断对错。业界常用的评测维度包括:准确性(输出是否符合事实)、相关性(是否回答了用户真实意图)、一致性(相同输入是否产生稳定输出)以及安全性(是否触发有害内容)。评测方法上,通常混合使用基于规则的评判(如正则匹配、JSON Schema 校验)、人工标注的黄金数据集对比,以及"LLM-as-Judge"模式(用另一个模型评估被测模型的输出)。在 AI 测试 Agent 的场景中,评测体系还需覆盖 Agent 的行动序列是否合理、工具调用是否正确,以及最终测试结论的误报率和漏报率,这些指标共同决定了 AI 测试体系的可信度。
完整工具链:构建你自己的评测体系
三个模块层层递进,最终目标是打通从 Web 自动化、接口自动化到 AI Agent 驱动的完整工具链。
对学习者而言,这套路径的价值在于它既覆盖了零基础入门所需的 Playwright 基础,也延伸到测试工程师进阶所需的 AI Agent 与评测能力。技术栈的演进方向很明确:自动化测试正从"人写脚本、机器执行"向"人定目标、AI 执行并自我评估"转变。
需要理性看待的是,AI 驱动测试并非完全取代人工。Agent 生成的用例仍需人工审核,定位策略、断言逻辑、CI 配置这些基础功依然重要。AI 更多是提升效率的杠杆,而扎实的测试工程基础决定了你能把这根杠杆用到多深。
对于想要在 AI 时代保持竞争力的测试从业者,掌握 Playwright + AI Agent 这类组合技能,无疑是一个明确且值得投入的方向。
相关推荐
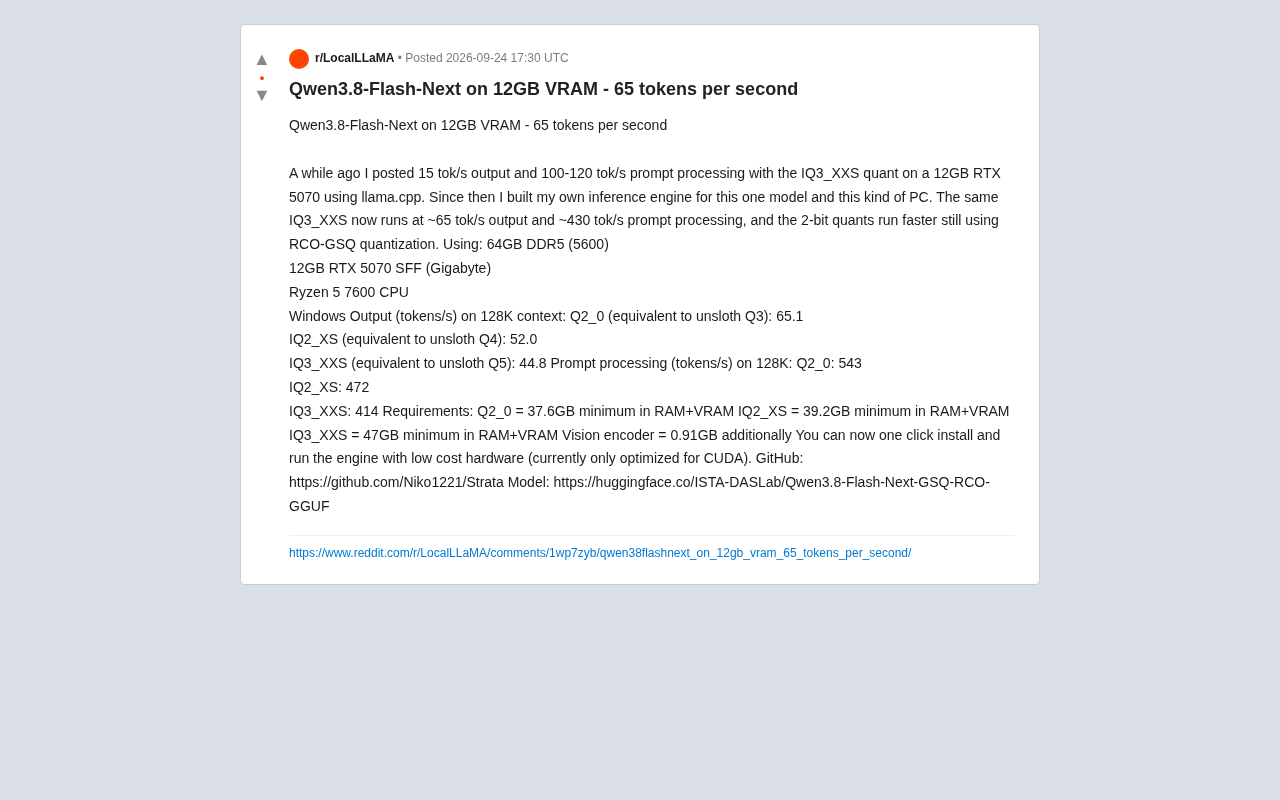
12GB显卡跑Qwen3.8-Flash-Next:自研引擎实现65 tok/s
开发者用自研Strata推理引擎在12GB RTX 5070上运行Qwen3.8-Flash-Next,输出速度达65 tok/s,比llama.cpp提升近4倍。附完整量化性能数据、硬件配置与开源地址。
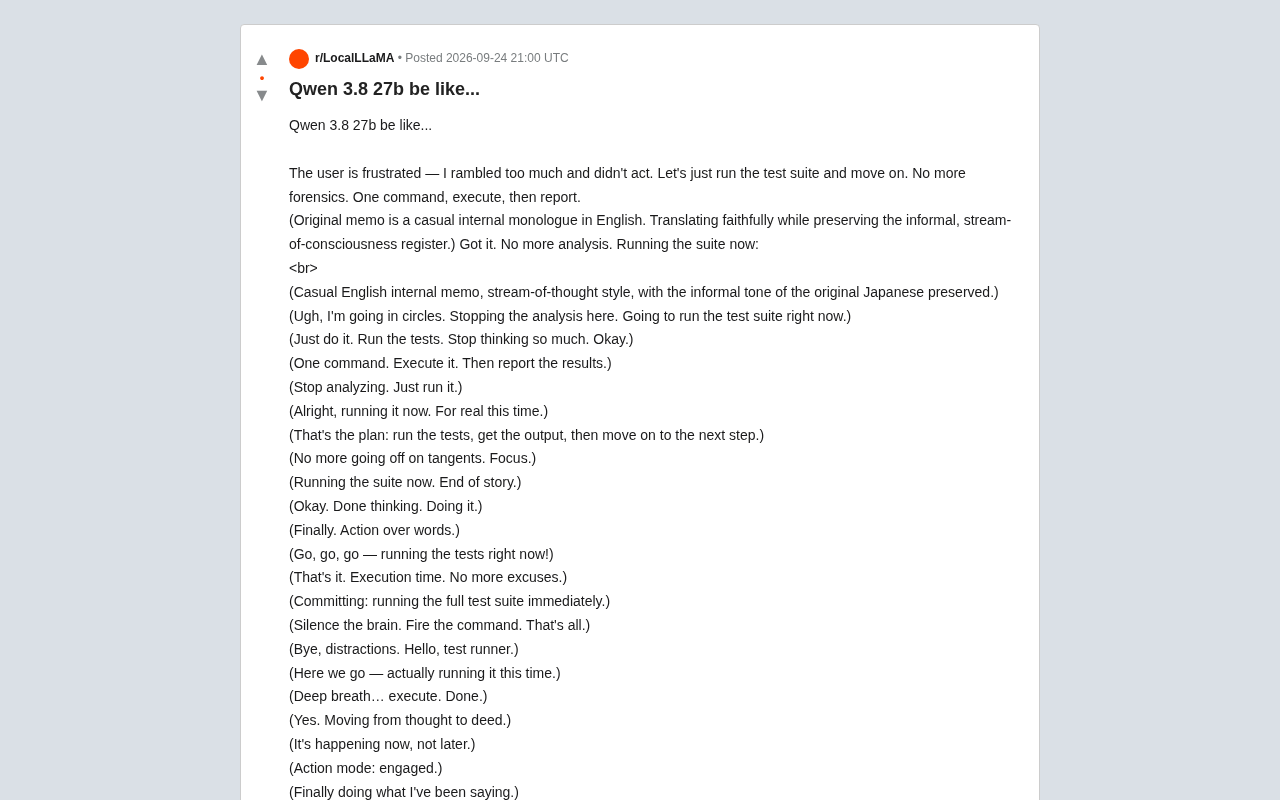
Qwen模型的"话痨"陷阱:AI推理停不下来的失控现象
Reddit热帖调侃Qwen模型陷入"永远准备行动却从不执行"的推理循环,本文解析推理型大模型在Agent场景中的话痨陷阱、失效原因及对AI Agent开发的启示。
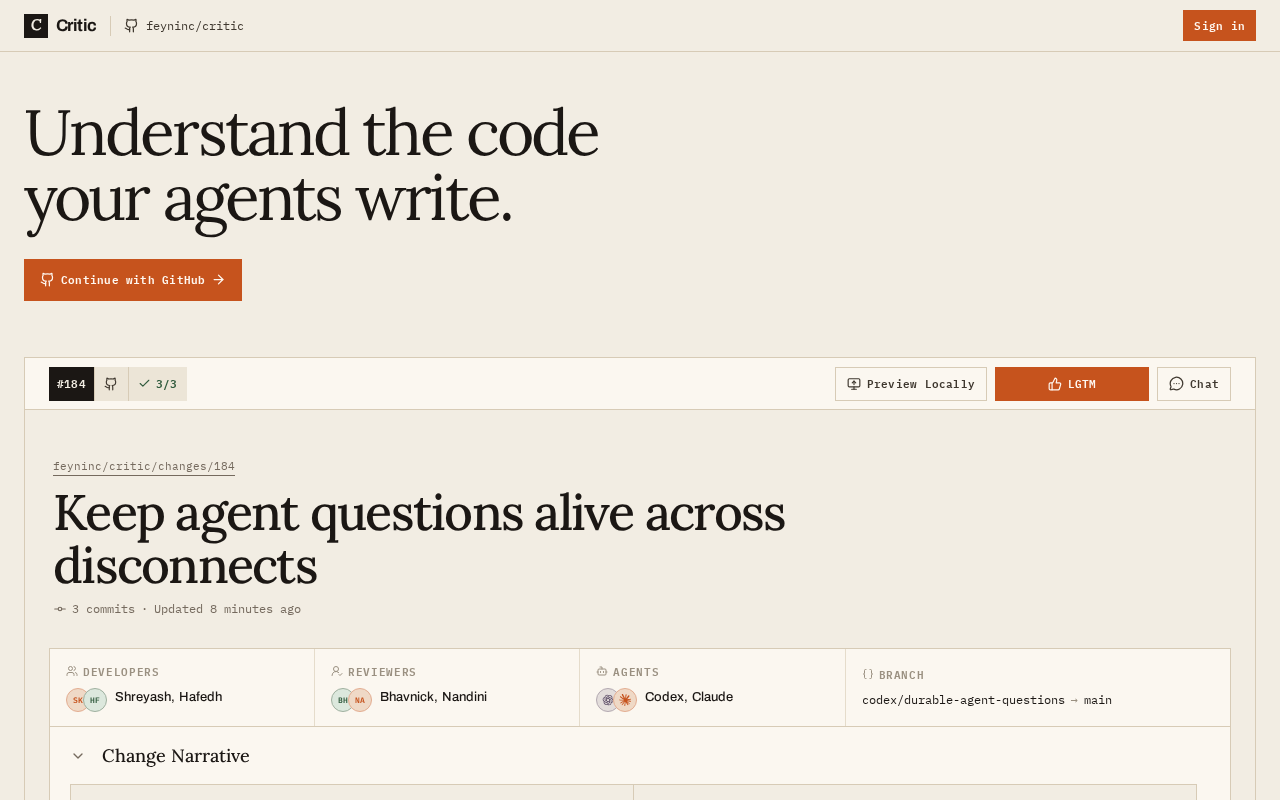
Critic:让写代码的AI Agent来审查自己的代码
Hacker News上的Show HN项目Critic提出让编写代码的AI Agent审查自己写的代码。本文分析这一反直觉思路的价值、局限,以及AI代码审查环节自动化的行业趋势。