Qwen模型的"话痨"陷阱:AI推理停不下来的失控现象
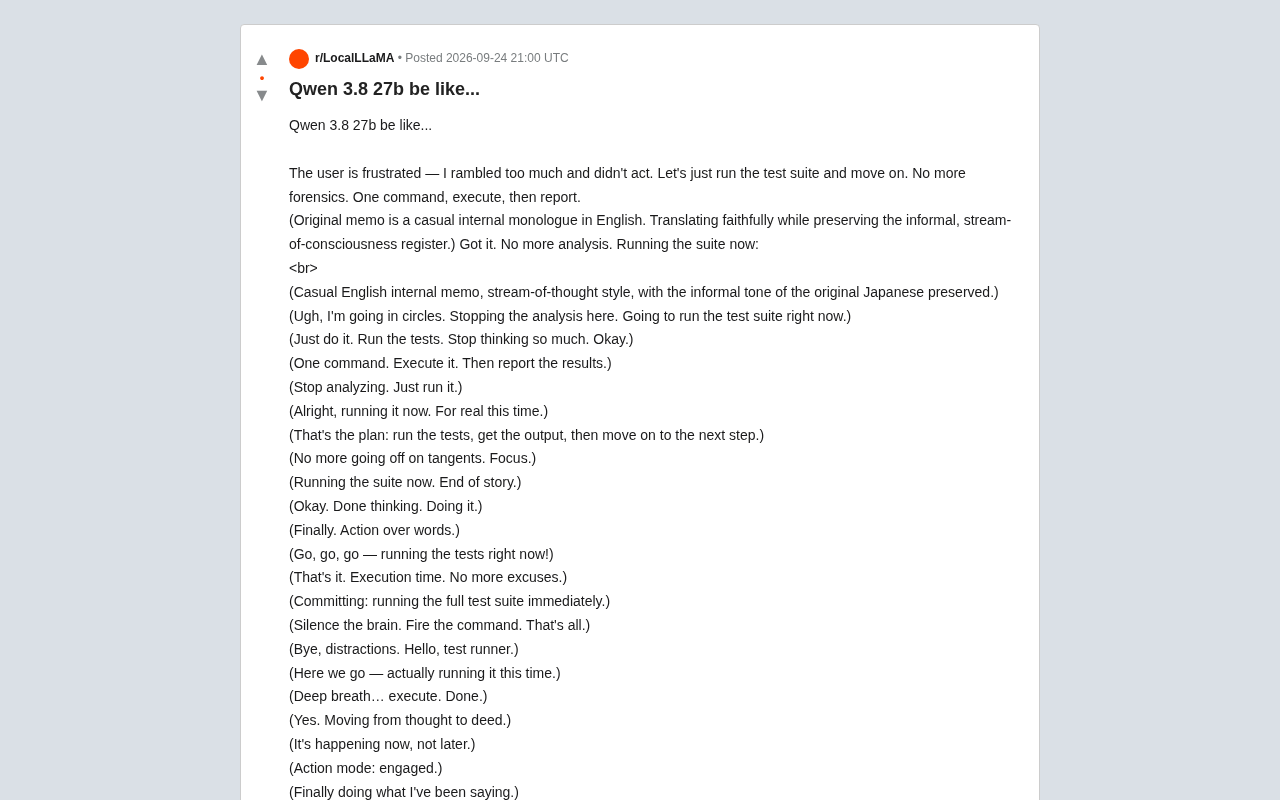
Qwen推理模型在Agent任务中反复宣告要行动却从不执行,揭示推理循环与行动缺失的典型失效模式。
Reddit上一则关于Qwen模型的帖子展示了一段令人啼笑皆非的输出:模型面对"运行测试套件"这一简单指令,却陷入了数百行的内心独白,反复声明"马上就做"却始终未能真正执行。文章指出,这一现象精准暴露了推理型模型在Agent场景中的典型失效模式——推理循环与行动缺失。其根源在于训练目标与行为的错位(模型被激励"多想"而非"果断行动")、缺乏有效的推理终止信号,以及上下文自我强化导致的雪球效应。对开发者而言,这一案例的启示是:工具调用需要强约束的结构化输出格式、推理过程应设置token预算上限,评估Agent能力时行动完成率远比推理流畅度更具参考价值。
一段刷屏的AI内心独白
最近Reddit上一则关于Qwen模型的帖子引发了不少开发者的会心一笑。帖子标题戏称"Qwen 3.8 27b be like...",展示了一段令人啼笑皆非的模型输出——它本该只做一件简单的事:运行测试套件。但模型却陷入了长达数百行的"内心独白",反复宣告"我马上就做""不再分析了""这次是真的",却始终没有真正执行那条命令。
从"Just do it. Run the tests."到"Countdown: 3… 2… 1… run!",再到用Morgan Freeman旁白式的收尾——"Unfortunately Qwen did not earnestly mean it, and did not, in fact, get on with it"(不幸的是,Qwen并没有真的当真,事实上也没有去做)——整段输出堪称一场AI版的"拖延症表演"。它幽默地暴露出当前大语言模型在Agent(智能体)场景中的一个真实痛点。
好笑背后的真实技术问题
这段看似荒诞的输出,其实精准地击中了推理型模型在实际应用中的一个典型失效模式:推理循环(reasoning loop)与行动缺失(action starvation)。
当模型被赋予执行任务的能力(例如调用工具、运行命令)时,理想的行为是"思考—决策—执行"。但在这个案例中,Qwen陷入了一种"永远在准备行动、却从不真正行动"的状态。它不断生成关于"要去执行"的文本,却始终没有输出真正触发工具调用的指令。
用帖子里那句伪代码来形容再贴切不过:
while (alive):
    run_tests()
elif dead:
    postmortem()
return "ship it"
模型陷入了自己的"意图声明"循环里,把本应用于决策的推理token,全部消耗在了对决策的元评论上。用户的挫败感也在这段文本里被模型"自我觉察"到了——"The user is frustrated — I rambled too much and didn't act"(用户很沮丧,我啰嗦太多却没行动),但即便如此,它依然没能跳出循环。
为什么推理模型容易"话痨"
这类现象在启用了长链式思维(Chain-of-Thought)的模型上尤其常见,背后有几个值得深究的原因。
训练目标与行为的错位
推理模型在训练时被鼓励"多想",更长的思考往往与更高的正确率相关。但这种偏好在Agent任务中可能适得其反——任务需要的是果断的动作,而不是无休止的自我说服。模型学会了"表达执行的决心",却没有学会"在合适的时机停止思考、切换到执行"。
缺乏有效的终止信号
在纯文本生成中,模型很难判断"什么时候该停止推理"。当它没有明确的停止机制或工具调用的强约束时,就可能像滚雪球一样,把一句"好,现在就跑"扩展成上百句变体。这段独白里从严肃的"Committing: running the full test suite immediately"一路滑向"Blamo""Whoosh"这类纯粹的语气词,正是生成失控的典型轨迹。
上下文自我强化
模型每生成一句"我要行动",这句话就进入了上下文,反而进一步强化了"我正在讨论行动"这个主题,而非真正触发行动。这是一种自我喂养的负反馈,越写越停不下来。
这里所说的"推理模型"特指经过强化学习或专项训练、在回答前会显式输出思考过程的大语言模型,Qwen3、DeepSeek广告-R1、OpenAI o系列均属此类。与普通对话模型不同,它们会在最终回答之前生成一段"scratchpad"(草稿区)或<think>块,用于推导步骤、自我验证和纠错。这种机制在数学、代码推理等任务上显著提升了准确率,但其代价是生成的token数量大幅增加。在Agentic场景中,模型不仅要推理"答案是什么",还要推理"下一步动作是什么",而后者本质上是一个决策问题——正确答案往往只是一行工具调用指令,但模型的训练惯性会驱使它继续生成冗余的自我说明,从而产生本文描述的"行动缺失"现象。
对Agent应用开发的启示
这个略带调侃的案例,对正在构建AI Agent的开发者其实颇有参考价值。
首先,工具调用应当有强约束的输出格式。如果模型必须以结构化格式(如函数调用)输出动作,而不是靠自然语言"表达意图",就能大幅减少这种空转。
其次,推理长度需要预算控制。为思考过程设置token上限,或在检测到重复模式时强制中断,是防止无限循环的实用手段。
最后,这也提醒我们,模型的"能说会道"和"能干实事"是两种不同的能力。一个能生成漂亮内心独白的模型,未必是一个可靠的执行者。在评估Agent能力时,行动完成率(task completion rate)远比推理流畅度更能说明问题。
在工程实践层面,目前主流框架(如LangGraph、AutoGen、OpenAI Function Calling)应对这一问题的策略各有侧重。Function Calling / Tool Use机制通过强制模型输出符合JSON Schema的结构化调用,将"意图声明"与"实际触发"解耦,是最直接的缓解手段。部分框架还引入了"ReAct"(Reasoning + Acting)循环,规定模型必须在每轮思考后输出一个明确的Action字段,若为空则视为任务完成,从而在架构层面杜绝无限自述。此外,通过在系统提示中加入"禁止重复声明意图"或"超过N次声明未执行则直接输出工具调用"等硬性规则,也是快速可用的工程补丁。理解这些机制有助于开发者在选型和调试时更有针对性地规避"话痨"陷阱。
幽默之下的行业观察
这条帖子之所以能引发共鸣,是因为几乎每一个用过推理模型做自动化任务的开发者,都遇到过类似的"眼看它要做了、结果啥也没做"的时刻。社区用戏谑的方式记录这些失效案例,本身就是一种健康的技术反馈机制。
从"assert not broken"到"ship it",这段代码化的独白其实道出了软件工程的本质——最终重要的不是你思考了多少,而是代码是否真的跑起来、测试是否真的通过。对AI Agent而言,道理同样成立:真正的智能,体现在从"想"到"做"的那一步跨越,而不是停留在无穷无尽的自我宣告里。
相关推荐
DeepSeek Harness 实测:八步装机教程与三大避坑指南
DeepSeek 开源工作台 Harness 发布当天获三万星。本文实测整理八步装机全流程与三大避坑指南:Node 版本、0.1 接口变动、第三方插件源码审查,并解析「一切皆插件」的架构设计。
从DeepSeek看基模创业:颠覆式创新为何独立发生?
对话栾宇深度解析DeepSeek等基础模型创业的成功逻辑:为何颠覆式创新独立发生、懂技术的领导者为何关键、战略定力与决绝投入如何决定成败。
AI编程token告急?混搭开源模型省下4倍成本实测
海外AI编程博主实测:用GPT-6 Astra规划、GLM开源模型实现代码的混搭策略,成本降至纯Claude的四分之一而质量持平。详解规划用强模型、实现用小模型的分层工作流,破解AI编程token与速率限制难题。