AI视频入门第一课:云端还是本地部署?成本速度质量全解析

云端与本地部署AI视频成本相差百倍,如何根据需求在两条路线间做出最优选择。
本文对比了AI视频生成的云端平台与本地部署两条路线,核心矛盾是成本、速度、质量构成的不可能三角。云端按秒计费,顶级模型一键即达但价格高昂;本地部署以硬件投入换取趋近于零的边际成本,并能通过量化和加速技术大幅提升速度,代价是一定的画质损失。文章还整理了2026年主流模型天梯,闭源Seedance 2.5质量最高,开源领域MiniMax H3一枝独秀。针对不同用户给出分层建议:新手从云端起步验证兴趣,追求极致质量者优先云端,团队则应让云本地合理分工以控制规模成本。本地部署还具备隐私保护、规避审核误拦截、消除排队等隐藏优势,两条路线并不互斥而是互补。
同一条10秒的AI视频,用云端平台生成花了近100元,在自家电脑上跑却只要8毛钱电费——成本差了100多倍。这是B站UP主Nelly在最新视频中抛出的灵魂拷问:对于刚入门AI视频的新人,到底该买云端会员,还是动手做本地部署?
这篇内容不教你怎么调参数、按哪个按钮,而是帮你理清两条路线背后的逻辑,以及如何根据自身情况做出最适合的选择。
云端与本地:两条路的本质区别
很多人以为「做AI视频」就是打开可灵、Seedance(即文中C-Dance)或海螺点一下,但背后的运行机制其实决定了你的成本结构。
模型公司训练出视频模型后,通常会把它部署在自家算力服务器上,以API形式对外出售。于是同一个模型会同时出现在十几二十个平台——既有模型大厂的官方平台,也有Lovart、TabNow这类聚合多家第三方模型的创作平台。用户无需任何特定设备,算力都来自厂商的集群,代价就是付费。
当前全球算力短缺,而AI视频又极度耗费算力。以Seedance 2.5为例,若把30秒1080P的时长与精度全部拉满,点一下鼠标可能就要花掉近170元。因此几乎所有在线平台都采用会员制或积分订阅来回收成本。
与之相对的是开源模型。开源意味着模型权重文件开放下载,任何人都能部署到自己电脑上免费使用,同时还能激活技术社区做二次开发——后文提到的量化和加速技术正是开源生态的产物。但要注意,开源不等于绝对免费:如果开源模型被某平台部署在它自己的算力上供你使用,你同样要付费。所谓「不花钱」,前提是完全用自己的本地算力。
「模型权重」是理解开源与闭源差异的关键概念。权重文件本质上是神经网络训练完成后保存下来的数十亿个参数数值,体积通常在数十GB到数百GB之间。闭源模型的权重由公司严格保密,只能通过其API调用;开源模型则将权重文件托管在Hugging Face等平台供任何人下载。下载权重后,用户需要配合推理框架(如ComfyUI、Diffusers等)才能在本地运行,这一过程就是「本地部署」。权重文件一旦下载到本地,后续每次生成只消耗本机电力,理论上使用次数不受限制,这正是本地部署边际成本极低的根本原因。
2026 模型天梯图:开源与闭源的差距有多大
Nelly基于Arena AI等公开平台评分和自己的综合使用体验,整理了一张2026年主流AI视频生成模型天梯图。
整体来看,闭源相对开源仍稍有领先。开源领域里,MiniMax公司的H3(文中Mini Max S3即为H3)可谓一枝独秀;闭源这边Seedance依旧很强,但下面几家头部大厂模型正在激烈混战。
从T0级别模型的实力看,Seedance 2.5画面质量最高,H3、Gemini系列、以及其他头部模型「咬得很紧」,而Seedance 2.0虽稍逊但依然是不少创作者的主流选择。这个排序作者也坦言并不绝对准确,在特定类目上可能有出入。
不可能三角:成本、速度、质量
决定选云端还是本地,核心是三个因素——成本、速度、质量。而这三者在现阶段构成了一个「不可能三角」。
成本:云端按秒计费,本地趋近于零
云端平台的积分换算成人民币,一般不会偏离模型源头API定价太多:Seedance 2.5平均每秒约2元,Seedance 2.0约1元,H3、Gemini系列约6到8毛不等。开通订阅会员通常比等价购买积分更划算,前提是每月额度都用得完。竞争激烈时,不少平台还会打价格战,可以薅羊毛。
本地部署的起步成本则取决于设备。如果你的电脑已有合格独显,启动成本接近于零;如果没有,就需要一笔不小的购置资金。以最能打的H3为例,高端的5090、4090到低端的3060、2060其实都能跑,区别在于速度和质量。
速度:设备与优化技术是关键变量
生成速度首先取决于分辨率和时长。在非高峰时段的第三方聚合平台上,生成一条5秒720P视频:H3和Gemini最快约2分半,Seedance 2.5约3分钟,万相(One)约5分钟。
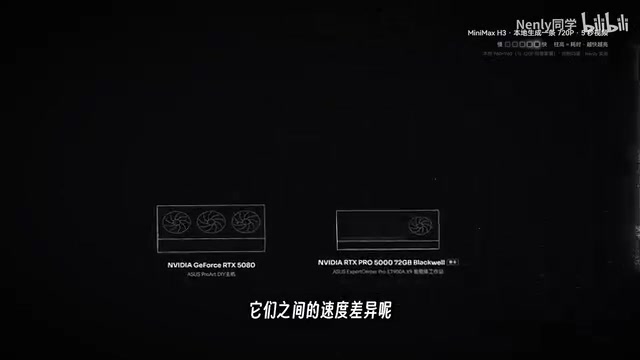
本地速度则主要看设备。作者用华硕提供的两台设备做了对比:搭载两张RTX Pro 5000、拥有144GB显存的ET900AX9工作站,与一台RTX 5080主机。跑H3原版生成720P视频,工作站单卡约6分钟,5080约10分钟出头。差异来自计算核心数量和显存大小——核心越多算得越快,显存越大越能把模型装进高带宽显存而非更慢的内存。
开源模型的优势在于社区优化。通过INT8量化降低精度,5080主机可缩短到约7分钟,工作站约4分半,已接近云端主流水平。再叠加社区主流的四步加速方案,生成时间可进一步压到原来的四分之一:5080约1分半,工作站约1分钟,比云端最快档还快一倍多。代价是质量会有一定下降。
INT8量化和采样步数缩减是目前开源社区最主流的两种加速手段,原理值得简单了解。量化(Quantization)是指将模型权重从高精度浮点数(如FP16,每个参数占16位)压缩为更低精度的整数格式(INT8占8位),文件体积和显存占用可减少约一半,计算速度随之提升,但数值精度有所损失,反映在画面上是细节略有退化。采样步数缩减则针对扩散模型的生成原理:视频生成本质上是从随机噪声经过多步「去噪」逐渐成形的过程,标准流程可能需要50步,四步加速方案通过蒸馏技术训练出一个能在4步内完成的模型版本,速度提升极为显著,但多步迭代带来的细节打磨空间也大幅压缩,因此画质损失相对量化更为明显。
质量:一分钱一分货 vs 用时间换精度
云端的质量逻辑简单直接——一分钱一分货。影响质量的主要是模型选择和分辨率,720P比480P细腻,1080P又更胜一筹,价格也逐级递增。
本地的逻辑则变成「只要愿意等更长时间就能拥有更高质量」。H3生成一条1080P视频,工作站约20分钟,5080约35分钟。量化版本与原版的差距其实不大,动态不强的画面肉眼几乎看不出差别;而缩短采样步数的加速方案会带来中等程度的损失。
怎么选?新手、个人与团队的不同答案
三者无法兼得,你只能在中间找一个能接受的平衡点。作者给出了分层建议。
新手:如果手上没合适设备、也没确定会不会长期做,建议先从云端起步,设一小笔预算完整做出一个作品,先搞清楚自己喜不喜欢做AI视频这件事。
追求极致质量的个人:优先考虑云端,因为能产出最高质量的模型一定在云端,但要提前接受较高成本,且要算上反复抽卡的开销。
不追求极限的个人:认真把本地部署放进流程。作者认为H3在不少场景已有Seedance七八成功力,如果你已有或正打算升级高性能电脑,本地能力基本是「白赚」的。
团队与公司:算法完全不同。团队里多人同时抽卡,效率和成本会被人头成倍放大,影视级项目一天烧五位数、一月烧七位数都真实存在。作者建议把一部分API预算分出来购置本地设备,让云端和本地分工:空镜、环境、动态不大的过场镜头用本地跑(H3与顶级模型在成片里基本看不出差别,但价格是几十块与零的差异);前期方案草稿、想法验证也用本地降分辨率快速迭代;真正需要极限质量的少量镜头再上云。
团队场景中常被提及的「抽卡」是AI视频创作的行业口语,指同一提示词多次生成、从中挑选满意结果的工作流。由于当前模型的随机性较强,同样的文字描述每次生成的画面构图、动态幅度、光影细节都可能差异显著,专业团队通常会为同一个镜头生成5到20个甚至更多版本再做筛选。这意味着实际消耗的积分往往是最终使用量的数倍,云端成本估算时必须将这一系数纳入考量。本地部署在抽卡场景下优势尤为突出:边际成本趋近于零,创作者可以大量生成而不必因费用顾虑压缩抽卡次数,有助于提升最终成片质量的上限。
本地的隐藏价值:隐私、审核与排队
除了钱和时间,本地还有三样对团队至关重要的东西:
- 隐私:保密项目的文字和影像数据可以完全留在本地,不上传云端。
- 审核:已获授权的形象或接近特定IP的题材,常被云端误拦截,本地环境则宽松得多。
- 排队:云端旺季可能排队一两天,本地则能保证产出节奏稳定。
作者还提到,本地设备的价值会随开源模型进步同步增长——今天它的上限是H3,未来一定会有更强的开源模型为同一台设备带来更强能力。
结语:两条路并不互斥
Nelly最想传达的观点是:云端和本地并非二选一。他自己创作时两条路都会用,哪个能把想要的镜头做好就用哪个。对现阶段的你而言,最重要的是先找到一个适合自己的起点,做得多了,哪些事值得在云端做、哪些适合交给本地,答案自然会清晰起来。
相关推荐

笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑
普通笔记本没显卡也能跑本地大模型:B站UP主用Ollama加开源千问3 8B纯CPU运行,为原创桌宠小金娘装上本地大脑,配合DeepSeekHarness完成插件开发与三轮调试,模型0元、断网可用、隐私不出本机。

Mistral Large 4开源权重发布:1万亿参数,激活49亿
Mistral Large 4开源权重发布:约1万亿参数、激活约49亿,支持图文与百万级上下文。解析厂商自测的编码与网络安全数据、修改版宽松许可、数据中心级硬件门槛,以及权重公开后不可回收的安全风险。

AgentScope 2.0实战:Java企业级AI Agent开发指南
AgentScope 2.0是阿里巴巴推出的Java企业级分布式智能体框架。本文解析它为何适合服务端AI应用,对比客户端AI应用在权限、状态管理、并发上的差异,并梳理从环境配置到项目联调的实战学习路线。