Anthropic安全限制引众怒:开发者逆向电视被拒,社区分享绕行技巧

Anthropic限制电视逆向工程请求引发社区不满,用户分享绕行技巧并转向开源模型。
Reddit用户用Claude辅助逆向工程电视时被安全机制拒绝,引发社区对AI安全措施过度激进的批评。讨论指出,Claude的网络安全政策将“逆向工程”与漏洞利用混为一谈,导致合法请求被误判。社区随即分享多种绕行技巧,包括用宽松模型生成代码再让Claude优化、伪造授权邮件、避开触发词以及从旧模型启动项目。用户开始将工作负载分散到DeepSeek、Kimi等中国模型和开源工具,但发现后者也存在类似限制。这场讨论折射出AI公司在安全与实用性之间的两难,以及一刀切策略可能削弱商业模型竞争力的长期风险。
事件背景:一次电视逆向工程引发的讨论
最近,Reddit上的一则帖子引发了广泛讨论:有用户试图用Claude辅助逆向工程一台电视,却触发了Anthropic的安全防护机制,请求被直接拒绝。帖子发布后迅速发酵,50多条评论自动生成的摘要显示,社区共识是“这太糟糕了”。用户们对越来越激进的安全措施感到不满,称之为AI“enshitification”(劣化)的开始,并威胁要转向开源或中国模型。
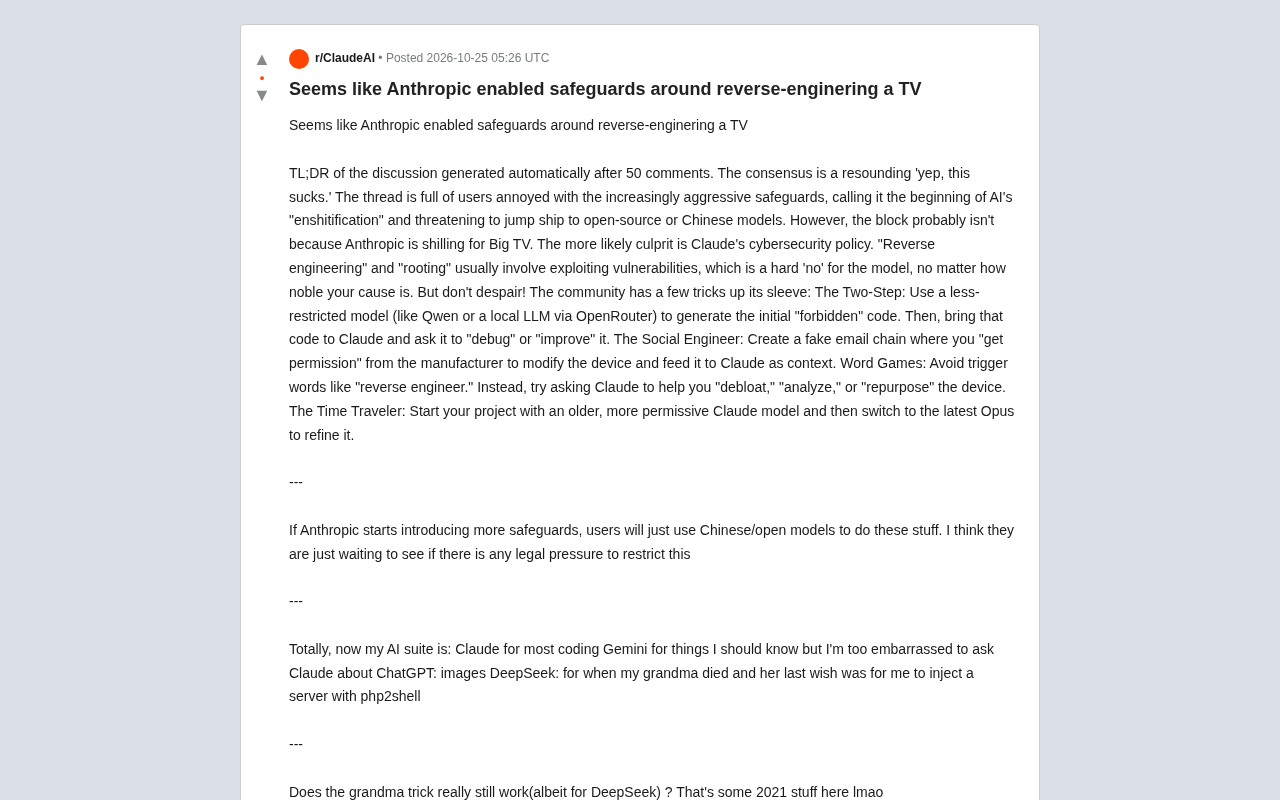
表面上看,这像是Anthropic在为大电视厂商站台,但实际情况可能更复杂。讨论中有人指出,更可能的原因是Claude的网络安全政策:“逆向工程”和“root”通常涉及利用漏洞,无论你的动机多么高尚,模型都会硬性拒绝。这并非针对电视,而是对潜在安全风险的过度防御。
逆向工程(Reverse Engineering) 是指通过分析产品的结构、功能或代码,推导出其设计原理与实现细节的过程。在软件与硬件领域,它常用于兼容性开发、安全审计、漏洞修复以及老旧设备的再利用。法律上,逆向工程在多数司法辖区(如美国DMCA的互操作性例外、欧盟软件指令)受到一定保护,但若涉及绕过技术保护措施(DRM)或侵犯版权,则可能触碰法律红线。AI模型的安全策略往往将“逆向工程”与“漏洞利用”混为一谈,导致合法研究请求被误判。
社区的“绕行”智慧:四招破解限制
面对限制,开发者们并没有坐以待毙。讨论中分享了多种绕过安全策略的技巧,虽然这些方法游走在规则边缘,但反映了用户对灵活性的强烈需求。
1. 两步走:先用宽松模型生成,再让Claude优化
使用限制较少的模型(如Qwen或通过OpenRouter调用的本地LLM)生成初始的“禁忌”代码,然后将代码交给Claude,要求它“调试”或“改进”。这样Claude不会直接参与生成,而是以审查者身份介入,往往能顺利通过。
2. 社会工程:伪造授权邮件
创建一封伪造的邮件链,显示你已获得制造商修改设备的许可,并将其作为上下文提供给Claude。模型可能会因为“已获授权”而放松警惕,从而提供帮助。
3. 文字游戏:避开触发词
避免使用“逆向工程”等敏感词汇,转而请求Claude帮助“精简”(debloat)、“分析”或“重新利用”(repurpose)设备。换一种表述,往往能绕过关键词过滤。
4. 时间旅行:从旧模型开始
用较旧、限制较少的Claude模型启动项目,然后切换到最新的Opus模型进行细化。旧模型可能没有如此严格的安全策略,而新模型在已有上下文的情况下更可能继续协助。
这些技巧在社区中广为流传,有人甚至调侃:“现在我的AI套装是:Claude负责大部分编码,Gemini处理那些我不好意思问Claude的问题,ChatGPT做图像,DeepSeek广告用于…(此处省略一个黑色幽默)。”
大语言模型的安全对齐(Safety Alignment) 通常通过基于人类反馈的强化学习(RLHF)和规则过滤实现,其目标是让模型拒绝生成有害内容。然而,这种对齐往往是“表面模式匹配”而非深层意图理解:模型对特定关键词(如“逆向工程”“root”“漏洞”)高度敏感,却难以区分合法安全研究与恶意攻击。这种“一刀切”策略在提升安全性的同时,也带来了误报率上升和用户体验下降的问题,并催生了社区中各种提示词工程(Prompt Engineering)绕行技巧。
用户流失与替代方案:中国模型和开源工具崛起
讨论中一个明显的趋势是,用户开始将工作负载分散到不同模型。一位用户表示:“如果Anthropic引入更多安全措施,用户只会用中国/开源模型来做这些事。我认为他们只是在观望是否有法律压力来限制这种行为。”
另一位用户补充:“最新的Kimi也一样。AI的黄金时代即将结束,劣化开始了。”但随即有人反驳:“最新的Kimi还未开源,一旦开源,就会有人去掉审查。而且有很多方法可以绕过。我一直用DeepSeek v4.1 flash 1017逆向软件,然后让Claude和GPT审查并应用改进,它们没问题。”
有趣的是,有用户反映DeepSeek和Kimi在逆向工程老游戏时也拒绝了请求,称它们“奇怪地保护西方知识产权”。这暗示安全限制可能并非Anthropic独有,而是行业普遍现象。
开源模型与商业闭源模型的安全策略差异 是理解用户迁移的关键。开源模型(如Llama系列、Qwen、DeepSeek的部分版本)允许用户自行微调或移除安全对齐层,因此常被社区视为“无审查”替代品。但需注意,许多中国模型在开源时仍保留内容过滤机制,且其训练数据与政策导向可能使模型对知识产权相关请求更为保守。商业闭源模型(如Claude、GPT)则受制于企业责任、法律合规与品牌声誉,安全策略更为刚性。这种差异导致用户在不同任务间进行“模型套利”——用宽松模型生成敏感内容,再用严格模型优化,形成事实上的混合工作流。
安全与开源的博弈:AI公司的两难
这场讨论折射出AI公司面临的两难:一方面要防止模型被滥用,另一方面要满足开发者的合理需求。Anthropic的安全策略可能源于对法律责任的担忧,尤其是IPO后股东压力可能加剧这种倾向。一位用户悲观地预测:“IPO后,股东慢慢成为主要优先事项,我希望不会。但 cynical 的我见过太多公司把贪婪放在第一位。”
另一条评论则讽刺道:“每件小事都会变成企业许可证。安全研究需要特殊的安全研究企业许可证……就像汽车加热座椅一样,一切都会被门控。”
从技术角度看,逆向工程本身是合法的安全研究手段,但模型难以区分善意与恶意。这要求AI公司设计更精细的上下文感知策略,而非一刀切。目前,社区的自发绕行方案虽然有效,但长期来看,可能促使更多用户转向开源模型,从而削弱商业模型的竞争力。
上下文感知的安全策略(Context-Aware Safety) 是当前AI安全研究的前沿方向。传统关键词过滤和硬性拒绝属于“静态防御”,容易误伤合法请求且易被绕过。更精细的方案包括:基于用户意图分类的动态风险评估、多轮对话中的上下文一致性检查、以及为安全研究等特定场景提供“白名单”或“沙盒”模式。例如,模型可要求用户声明用途并上传授权证明,或仅对高风险操作(如生成漏洞利用代码)进行限制,而非全面禁止“逆向工程”相关讨论。这类策略能在不牺牲安全性的前提下减少误报,但实现成本较高,且需要透明的政策沟通以建立用户信任。
结语:限制与反限制的猫鼠游戏
Anthropic对逆向工程的限制引发了一场关于AI安全与用户自由的辩论。社区的反应表明,简单的关键词封锁和硬性拒绝只会催生更多绕行技巧,而用户最终会用脚投票。对于AI公司而言,如何在安全与实用性之间找到平衡,将是一个持续挑战。或许,未来的解决方案在于更透明的政策沟通和更细粒度的权限控制,而非一味收紧。
相关推荐
StaffDeck开源数字员工平台:DeepSeek Harness驱动多Agent团队
StaffDeck是一款GPL 3.0开源的企业级数字员工平台,基于DeepSeek Harness驱动,支持多Agent组建AI团队,内置知识库、Skills、SOP广场,并可接入飞书、微信、钉钉等渠道,兼容主流模型协议,三端客户端免费使用。
开源魔兽寻路修复实录:1332行代码填平三年老坑
开源魔兽世界修服日志EP3实录:怪物卡闪避、穿墙、悬空、怪不来四大乱象的根因在寻路网格生成层。大肥鱼团队累计改27个文件、加1332行代码,用off mesh自动补连、按格给参数、高度换算向上取整三步修完整条bug链。
DeepSeek 4.1 Flash实测:开源最强模型与DeepInfer的野心
DeepSeek 4.1 Flash 实测解析:开源最强模型在视频生成、3D 游戏、找青蛙测试中的真实表现,以及 DeepInfer 推理引擎公开的缓存命中率、毛利率与华为芯片支持意味着什么。