本地部署别搞错:Ollama、llama.cpp与OpenAI区别详解

一文厘清 Ollama、llama.cpp 与 OpenAI 的层次分工,助你按需选择本地或云端 AI 部署路线。
云端 AI 的频繁故障促使越来越多开发者关注本地部署,但入门时往往被 Ollama、llama.cpp、OpenAI 三个高频词汇搞混。文章将三者定位清晰区分:Ollama 是使用层,封装了模型下载与运行的复杂细节,一条命令即可启动并提供 OpenAI 兼容接口;llama.cpp 是更底层的推理引擎,负责 GGUF 格式转换、量化以及精细的推理参数控制,Ollama 底层也依赖类似能力;OpenAI 则走纯云端 API 路线,省去一切本地硬件与维护成本,但稳定性与数据主权由服务商掌控。三者是分工而非竞争关系,选择哪条路线取决于用户对掌控力的需求与愿意付出的维护成本。
云端AI的稳定性问题正在把越来越多的开发者推向本地部署。近期OpenAI服务多次出现大范围错误与中断,让人不得不重新思考:当工作流越来越依赖云端,我们是否也该给自己留一套真正掌控在手里的方案?
真正开始动手时,你会立刻撞上三个高频出现的名字——Ollama、llama.cpp 和 OpenAI。它们经常被放在一起讨论,却分属完全不同的层次。这篇文章把三者的定位一次讲清楚。
为什么本地部署重新变得重要
云端AI的便利肯定的是,但它把稳定性和安全性交到了别人手里。一旦服务商出现故障,你的整个工作流可能瞬间停摆;一旦AI接入真实业务数据,数据流向云端也带来了不可忽视的安全顾虑。
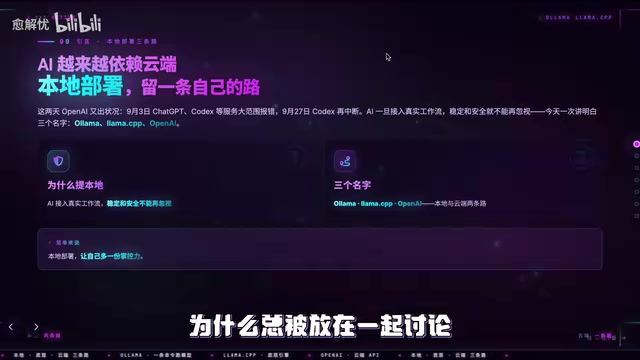
现在讨论本地部署,并不是要立刻替代云端,而是让自己多一种选择、多一份掌控力。随着模型越来越小、消费级硬件越来越强,本地AI进入更多设备只是时间问题。理解 Ollama、llama.cpp 与 OpenAI 三者的分工,是入门本地部署的第一步。
Ollama:本地部署的主流选择
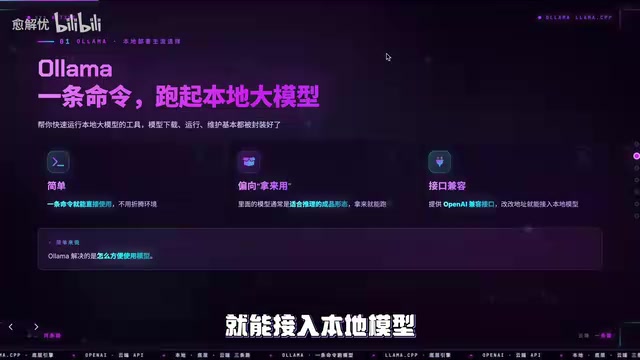
Ollama 可以理解成一个帮你快速运行本地大模型的工具,它的核心价值在于把复杂流程封装到极简的体验里。
开箱即用。 模型的下载、运行、管理基本都被封装好了,一条命令就能直接使用,不需要你操心底层细节。
偏向拿来就用。 在 Ollama 里使用的模型,通常已经是适合推理的成品形态。它更适合直接运行模型,而不是从原始权重开始做训练、转换和量化。一句话概括,Ollama 解决的是「怎么方便地使用模型」。
接口兼容。 它提供 OpenAI 兼容接口,很多现成的程序只要修改一下接口地址,就能无缝接入本地模型。这一点极大降低了从云端迁移到本地的成本。
llama.cpp:更底层的模型运行层
如果说 Ollama 是使用层,那么 llama.cpp 就更接近模型底层的运行层。
负责让模型真正适配本地推理。 你下载的原始模型权重可能还是 Safetensors 等格式,通常需要先转换、量化成 GGUF 格式,才能交给 llama.cpp 加载运行。可以这样理解这条链路:原始权重是「原材料」,GGUF 是本地推理常用的「成品格式」,而 llama.cpp 就是负责把它跑起来的底层引擎。
控制权更高。 模型的转换、量化、加载以及推理参数,都可以由你自己掌控。这种精细度是 Ollama 这类上层工具刻意隐藏起来的。
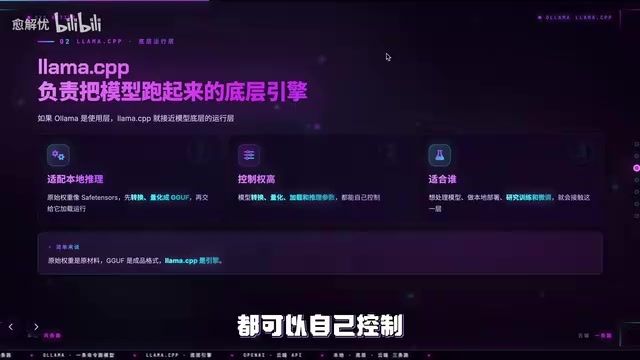
所以结论很清晰:如果你只是想运行模型,Ollama 更方便;但如果你想进一步处理模型、做深度本地部署,甚至研究训练和微调,就会接触到 llama.cpp 这一层。事实上,Ollama 底层也依赖类似 llama.cpp 的推理能力,两者是分工而非竞争关系。
GGUF 格式是 llama.cpp 项目专门设计的一种模型文件格式,全称 GPT-Generated Unified Format,于 2023 年取代了此前的 GGML 格式。它的设计目标是把模型权重、量化参数、分词器词表等所有推理所需的信息打包进单一文件,方便分发与加载。量化(Quantization)则是把模型权重从高精度浮点数(如 FP32、FP16)压缩为低位整数(如 Q4、Q8)的过程,可以大幅降低显存占用与内存带宽需求,代价是轻微的精度损失。以一个 70 亿参数的模型为例,FP16 格式大约需要 14GB 显存,而 4-bit 量化后可压缩到约 4GB,使普通消费级显卡甚至纯 CPU 推理成为可能。Ollama 在后台自动完成了这些步骤,而 llama.cpp 则把每个环节完整暴露给用户,适合需要针对特定硬件精细调优的场景。
OpenAI:截然不同的一条路线
和前两者不同,OpenAI 走的是彻底的云端路线。
模型不跑在你的电脑上。 它运行在云端,你的程序通过 API 发出请求,云端完成推理后再把结果返回给你。
不需要考虑本地硬件。 模型多大、显存够不够、怎么部署,这些问题基本都交给云端处理,你无需操心。
开发和维护更简单。 SDK、工具和服务都由云端提供,你不用维护模型和服务器。因此 OpenAI 更适合不想自己维护模型和硬件、更关注开发效率的人。
代价则是稳定性与数据主权都掌握在服务商手里——这也正是文章开头提到的那些故障事件所暴露的风险。
OpenAI 兼容接口(OpenAI-compatible API)是当前本地部署生态中一个重要的概念。OpenAI 在推出 GPT 系列模型的 API 时定义了一套标准的 HTTP 接口规范,包括 /v1/chat/completions、/v1/embeddings 等端点与请求格式。由于 OpenAI 的市场地位,这套规范事实上成为了行业标准。Ollama、LocalAI、vLLM 等众多本地推理框架都选择实现同一套接口规范,这意味着基于 OpenAI SDK 开发的应用,只需把 base_url 从 OpenAI 的云端地址改成本地服务地址,无需修改任何业务代码即可切换到本地模型。这种兼容性设计极大降低了迁移成本,也是本地部署方案能够快速融入现有开发工作流的关键原因。
三者定位一览
把三者放在一起对比,脉络就非常清晰了:
- Ollama:负责方便地运行本地模型,追求开箱即用。
- llama.cpp:更接近底层推理引擎,提供转换、量化与参数的完整控制权。
- OpenAI:负责调用云端模型,省去一切本地维护成本。
选择哪一条路线,本质上取决于你想要多少掌控力,以及愿意付出多少维护成本。想快速体验本地模型,从 Ollama 入手;想深入折腾,就下沉到 llama.cpp;只关心业务开发效率、不介意依赖云端,OpenAI 依然是省心之选。
未来AI很可能不再只有云端这一条路。现在花时间理解本地部署的技术栈,不是为了立刻抛弃云端,而是让未来的自己在稳定性、安全与成本之间,拥有更多可以自主拿捏的余地。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。