本地DQN实时直播学习超级马里奥:从像素到通关的深度强化学习实践
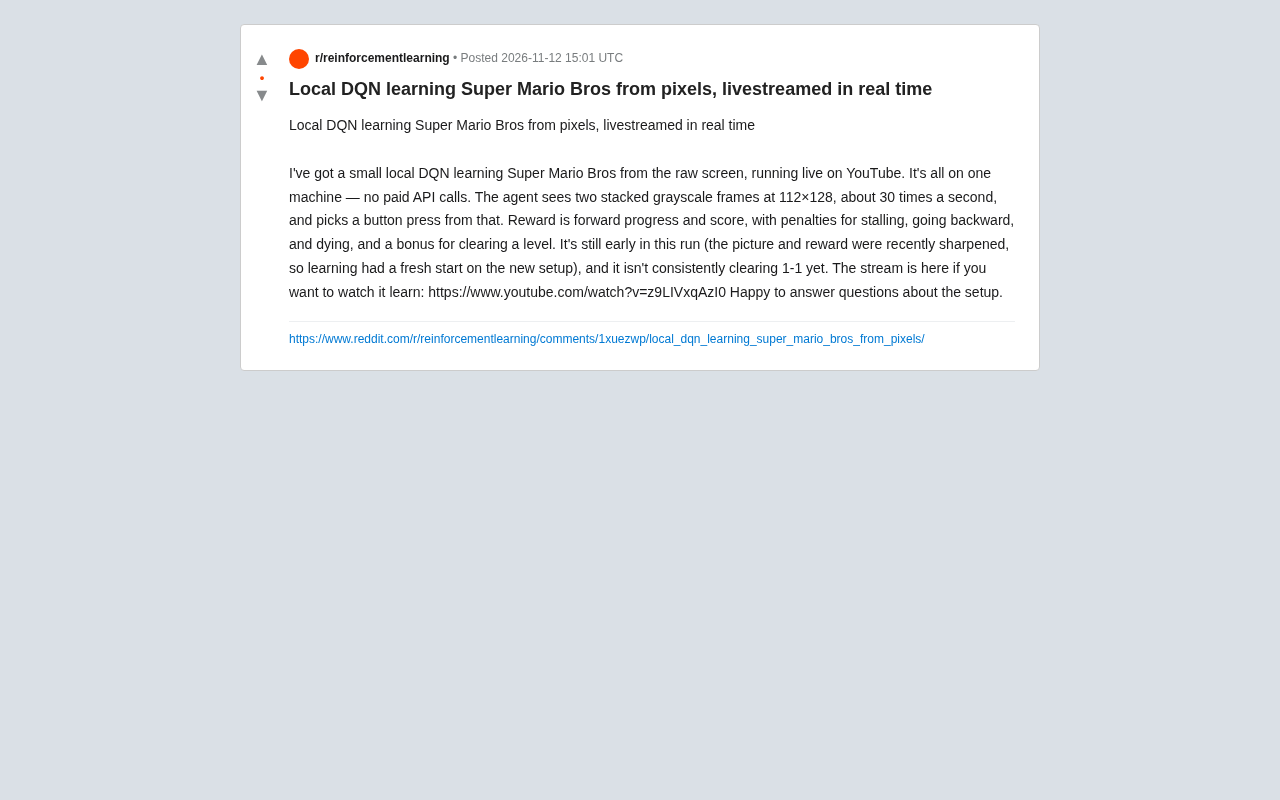
开发者本地运行DQN,从像素学习玩超级马里奥并实时直播,展示强化学习实践与挑战。
一位开发者在Reddit上分享了一个本地运行的DQN项目,智能体从原始游戏画面学习玩《超级马里奥兄弟》,全程单机训练并实时直播。项目采用两帧堆叠的112×128灰度图像作为输入,直接输出按键动作,奖励函数组合了前进进度、得分、停滞/后退/死亡惩罚和通关奖励,近期经过锐化调整。目前训练仍处早期,智能体尚未稳定通关1-1。该项目体现了从像素学习的高维输入、稀疏奖励和长时序决策等难点,也展示了实时直播对观察学习过程的价值,为强化学习爱好者提供了可参考的实践框架。
一位开发者在Reddit上分享了一个本地运行的DQN(深度Q网络)项目,它正在从原始游戏画面中学习玩《超级马里奥兄弟》,并全程在YouTube上实时直播。整个过程完全在一台机器上完成,没有调用任何付费API。这个项目展示了深度强化学习在经典游戏环境中的一次纯粹、透明的实践,也引发了关于训练效率、奖励设计以及“从像素学习”难点的讨论。
系统架构:单机运行,从像素到动作
据作者描述,整个学习系统运行在一台本地机器上。智能体接收的输入是两帧堆叠的灰度图像,分辨率为112×128,帧率大约为每秒30次。它需要从这些像素中直接选择按键动作——这正是“从像素学习”(learning from pixels)的典型设定:没有手工提取的游戏状态特征,智能体必须自己从原始画面中理解马里奥的位置、敌人、地形等信息。
这种设定对计算资源和算法效率的要求较高。作者强调“没有付费API调用”,意味着所有训练和推理都在本地硬件上完成,这既降低了成本,也使得整个学习过程更加可控和可复现。两帧堆叠的设计是为了让智能体感知运动信息,比如马里奥的移动方向、敌人的逼近速度等,这是处理部分可观测环境时的常见做法。
帧堆叠(Frame Stacking) 是深度强化学习处理部分可观测环境的一种常用技术。在《超级马里奥兄弟》这类游戏中,单帧画面无法提供运动信息(如马里奥的移动方向、敌人的逼近速度),因为静态图像只包含位置信息。通过将连续多帧(如两帧或四帧)灰度图像堆叠作为输入,智能体可以隐式地感知时间差分,从而推断出速度、加速度等动态特征。这种做法最早在DQN的Atari实验中就被采用(当时堆叠4帧),并被证明对学习效果至关重要。帧堆叠的代价是输入维度增加,计算量变大,因此需要在信息量和效率之间权衡。
奖励设计:塑造行为的关键
奖励函数是强化学习的核心。在这个项目中,作者设计了一套组合奖励:前进进度和得分作为正向信号,停滞、后退和死亡则会带来惩罚,而通关一个关卡则会获得额外奖励。这种设计试图引导智能体学会“向右前进并避免死亡”的基本策略,同时鼓励它完成关卡。
奖励塑造在《超级马里奥兄弟》这类游戏中尤为重要。单纯依赖游戏得分往往过于稀疏,智能体很难在早期探索到有效行为。通过引入前进进度作为密集奖励,可以加速学习过程。但奖励设计也容易引入意外行为,比如智能体可能学会在某个区域反复刷分而不前进,或者为了规避死亡惩罚而过度保守。作者没有透露具体的奖励权重,但表示“画面和奖励最近被锐化(sharpened)”,这意味着他调整了奖励函数,让信号更明确,学习也因此重新开始。
奖励塑造(Reward Shaping) 是强化学习中通过设计中间奖励信号来引导智能体学习的一种技术。在稀疏奖励环境下(如游戏得分只在特定事件发生时给出),智能体很难通过随机探索获得有效反馈。奖励塑造通过引入密集的辅助奖励(如前进距离、存活时间等)来加速学习,但同时也可能引入偏差,导致智能体优化辅助奖励而非最终目标。理论上,奖励塑造需要保证不改变最优策略(即势函数-based shaping),但在实践中往往难以严格满足。作者采用组合奖励并调整权重,正是试图在引导学习和避免意外行为之间找到平衡。
训练现状:尚未稳定通关1-1
作者坦诚地表示,这次运行还处于早期阶段,智能体“尚未稳定通关1-1”。这并不令人意外——从像素直接学习马里奥对DQN来说是一个有挑战性的任务。DQN在处理高维视觉输入时,需要大量的交互样本和精心的超参数调优。此外,作者最近对画面和奖励进行了调整,导致学习“重新开始”,这也解释了为什么当前表现还不理想。
实时直播的形式让观众可以直观地看到智能体从随机动作到逐渐学会前进的过程。这种透明性对于强化学习研究和教育都很有价值,因为人们往往只看到最终的成功结果,而忽略了中间大量的失败和调整。作者在帖子中邀请观众提问,表明他愿意分享技术细节,这有助于社区共同探讨问题。
技术难点与潜在改进方向
从像素学习马里奥的难点主要包括:稀疏奖励、长时序决策、以及视觉输入的复杂性。DQN本身存在过估计(overestimation)问题,通常需要通过Double DQN、Dueling DQN等变体来缓解。此外,经验回放(experience replay)和目标网络(target network)的稳定性对训练至关重要。作者没有提及是否使用了这些改进技术,但考虑到这是一个本地项目,很可能采用了标准的DQN实现。
另一个值得关注的点是训练效率。在单机上从像素训练DQN,可能需要数小时甚至数天才能看到明显进展。实时直播让观众可以观察到学习曲线,但也可能暴露训练不稳定的问题。作者提到“画面和奖励最近被锐化”,这暗示他可能在调整预处理步骤(如灰度化、降采样、帧堆叠)和奖励缩放,这些都会影响学习速度和最终性能。
DQN的过估计问题 源于Q学习中的最大化操作:在计算目标Q值时使用max操作,会导致Q值被高估,进而影响策略的稳定性。Double DQN通过将动作选择与动作评估解耦来缓解这一问题——使用当前网络选择动作,使用目标网络评估该动作的价值。Dueling DQN则通过将Q值分解为状态价值V和优势函数A,提升学习效率。此外,优先经验回放(Prioritized Experience Replay)通过更频繁地采样高TD误差的样本,提高样本利用率。这些改进技术在实践中常被组合使用(如Rainbow),但会增加实现复杂度。作者若未采用这些技术,标准DQN在复杂视觉任务上可能收敛较慢。
多源视角:社区反馈与类似项目
虽然这个项目主要来自Reddit的单一帖子,但类似“从像素学习马里奥”的尝试在强化学习社区中并不少见。据一些YouTube频道和B站UP主的分析,许多爱好者使用DQN、PPO等算法在本地复现马里奥智能体,并遇到相似的挑战:训练初期智能体倾向于原地不动或反复跳跃,需要精心设计奖励和探索策略。这些独立来源的经验与作者的描述相互印证,表明从像素学习马里奥是一个需要耐心和迭代的过程。
也有观点认为,使用更先进的算法(如Rainbow DQN或分布式强化学习)可以显著提升样本效率,但实现复杂度也更高。作者选择标准DQN,可能出于简洁性和可解释性的考虑。无论如何,实时直播的形式为观察学习过程提供了独特的窗口。
Rainbow DQN 是DeepMind在2017年提出的一种集成多种DQN改进的算法,它结合了Double DQN、Dueling DQN、优先经验回放、多步回报、分布式Q学习(C51)和噪声网络等技术。在Atari基准测试中,Rainbow显著超越了原始DQN的样本效率和最终性能。然而,其实现复杂度较高,需要调参的组件更多,对于本地单机项目而言可能不够轻量。分布式强化学习(如C51)则通过建模回报分布而非期望值,提供更丰富的学习信号,但计算开销更大。作者选择标准DQN,可能是在简洁性、可解释性和训练效率之间做出的权衡。
总结与展望
这个本地DQN项目是一次扎实的强化学习实践,它把训练过程完全暴露在观众面前,体现了开源和分享的精神。虽然智能体尚未稳定通关1-1,但作者对奖励和画面的调整表明他正在积极迭代。对于想要入门深度强化学习的开发者来说,这个项目提供了一个可参考的框架:从像素输入、帧堆叠、奖励设计到实时监控,每一步都有值得学习的地方。未来,如果作者引入Double DQN、优先经验回放等技术,或者增加训练时间,智能体的表现有望进一步提升。
你可以通过作者提供的YouTube链接观看实时学习过程,并直接在帖子中提问。
相关推荐
Claude Fable 5.2实测:1000智能体30小时证明费马大定理
Claude Fable 5.2与Mesos 5.2发布:1000个AI智能体30小时形式化证明费马大定理,价格降20%、速度提升30%,在电路设计、物理、化学、运筹与网络安全任务中展现长链条工程能力,同时被主动限制AI自我改进。
当AI遇上政治讽刺:Hegseth言论引爆的舆论风暴
一段YouTube政治讽刺节目引发热议,聚焦美国防长赫格塞斯过往关于女性参战的争议言论,以及其面临的性侵指控与母亲批评信。本文梳理事件核心争议与舆论反应。
谷歌Android XR智能眼镜上手:隐私设计比Meta更主动
谷歌Android XR智能眼镜上手体验:隐私灯在数据保存前亮起、人脸在云端前被模糊化、数据不用于AI训练或广告定向。Gemini在眼镜端表现优于Meta AI,智能眼镜竞争进入隐私设计新阶段。