闭源AI模型霸榜性价比前沿:开源追赶为何吃力?
闭源模型占据价格-性能前沿,开源需在成本与能力上双重追赶。
文章围绕 Hacker News 上一则「闭源 AI 模型主导性价比前沿」的讨论展开,指出当前市场并非「开源便宜、闭源贵」的简单二分,而是在多个能力档位上闭源厂商提供的单位成本智能更高,背后是推理基础设施的规模效应与工程优化积累。开源模型的价值在于私有化部署、可微调、数据可控,但在纯 API 调用和通用能力场景下追赶难度较大。文章建议把性价比拆解为任务成功率、单位成本、延迟、运维与合规成本等维度,依据业务对通用能力的依赖程度做选择,并强调性价比前沿持续移动,架构上应保留模型切换能力而非押注单一供应商。
Hacker News 上一条题为「Closed AI models dominate the price-performance frontier」的讨论引发了从业者的关注。帖子本身没有给出长篇分析,但标题点出的现象足够尖锐:在「每一美元能买到多少智能」这条衡量线上,闭源模型目前站在最前面。
这不是一个关于「谁更强」的简单问题,而是关于成本效率的结构性观察。当企业开始把大模型从演示阶段推进到生产环境,价格与性能的比值往往比单纯的榜单排名更能决定技术选型。
性价比前沿意味着什么
「价格-性能前沿」是经济学里的一个直观概念:在给定预算下能达到的最高性能水平。落在前沿上的产品,意味着你很难用更少的钱买到同等能力,也很难用同样的钱买到更强能力。
闭源模型占据这条前沿,说明当前的市场格局并非「开源便宜、闭源贵」的简单二分。更准确的说法是:在多个能力档位上,闭源厂商提供的单位成本智能更高。这背后既有推理基础设施的规模效应,也有模型蒸馏、量化与服务栈协同优化的工程积累。
对开发者而言,这个信号很实际——选型时若只看开源许可带来的「零授权费」,可能忽略了实际调用成本与效果折算后的真实开销。
规模效应与推理成本结构
大模型推理的单位成本并非只由参数量决定,而是由算力利用率、批处理效率、显存带宽占用、KV 缓存管理和服务调度共同决定。闭源厂商通常在同一套基础设施上同时承载大量租户请求,通过连续批处理(continuous batching)、投机解码、分页注意力等手段把 GPU 利用率推高,从而摊薄单次请求成本。这种规模效应形成正反馈:更多调用量带来更低的边际成本,更低价格又吸引更多调用量。开源模型即使权重免费,部署方若达不到同等负载密度,单位 token 的实际成本往往更高,这正是「零授权费」容易造成的认知偏差。
开源模型的位置在哪里
开源权重模型的价值从来不只在价格。可私有化部署、可微调、数据不出域、供应链可控,这些是闭源 API 无法替代的属性。在合规敏感或需要深度定制的场景里,开源依然是默认选项。
但在纯 API 调用、追求通用能力的场景下,开源模型要在性价比上追平闭源,需要同时压低推理成本并抬高能力上限,这两件事都不轻松。前沿闭源厂商把训练与推理的反馈闭环攥在自己手里,迭代节奏天然更快。
讨论中的分歧也集中在这里:一方认为开源社区的追赶速度被低估,微调与蒸馏能让小模型在特定任务上逼近前沿;另一方则认为通用能力上的性价比差距是结构性的,短期难以抹平。
蒸馏与量化的能力折损
微调与蒸馏确实能让较小模型在特定任务上逼近大模型,但这类收益通常具有任务局部性:在分布内数据上表现接近,遇到分布外输入时退化更快。量化同理,INT8 或 4-bit 量化能显著降低显存占用与推理延迟,却会在长上下文、多步推理和数值敏感任务上引入可测量的精度损失。因此「小模型加蒸馏追平前沿」的论断需要限定任务边界,通用能力上的性价比比较仍应以统一评测集和真实流量分布为准,而非单点基准分数。
对技术选型的实际启示
理性做法是把「性价比」拆成可测量的维度:任务成功率、单位请求成本、延迟、运维复杂度、数据合规成本。闭源 API 在前几项上往往占优,开源则在最后两项上更可控。
真正的决策点在于业务对「通用能力」的依赖程度。如果产品核心价值建立在广泛的语言理解与推理上,跟随前沿闭源模型是更稳妥的路径;如果核心价值来自专有数据与流程,开源底座加微调反而能构建更深的护城河。
值得留意的是,性价比前沿本身在移动。今天的领先不保证明天的领先,模型能力与推理成本的曲线都在快速变化,选型架构上保留切换能力,比押注单一供应商更重要。
供应商锁定与切换成本
保留切换能力在工程上意味着抽象出统一的模型调用层,把提示模板、工具调用协议、输出解析和评测管线与具体供应商解耦。实践中可通过网关层统一不同 API 的请求格式,用同一套离线评测集持续对比候选模型在自身业务分布上的表现,并预设降级与回退路径。需要权衡的是抽象层带来的额外延迟与维护成本,以及各家专有功能(如结构化输出、缓存、批处理折扣)的可用性差异。切换能力本身也是一种议价资产,避免在续约与调价时处于被动。
结语
闭源模型占据性价比前沿,是当前市场的一个客观事实,但它描述的是效率分布,而非技术终局。开源与闭源的竞争会长期在「成本、能力、可控性」三角中展开,开发者的任务不是站队,而是把这三个变量放进自己的业务方程里算清楚。
相关推荐

Hermes Agent零基础教程:自进化AI智能体实战
Hermes Agent零基础教程:详解这个GitHub两月获41.7K星的开源自进化AI智能体,从Harness Engineering核心理念、学习循环、三层记忆系统到WSL安装与实战配置,小白也能轻松上手。
AI Agent落地实战:用WorkBuddy打造智能办公助理
本文通过实战案例演示如何用腾讯WorkBuddy完成文件批量转换与归档,对比聊天大模型与AI Agent的能力差异,分析WorkBuddy的积分体系、适用场景与产品定位,为办公自动化选型提供参考。
从单卡瓶颈到千亿参数:大模型分布式并行6大关键问题
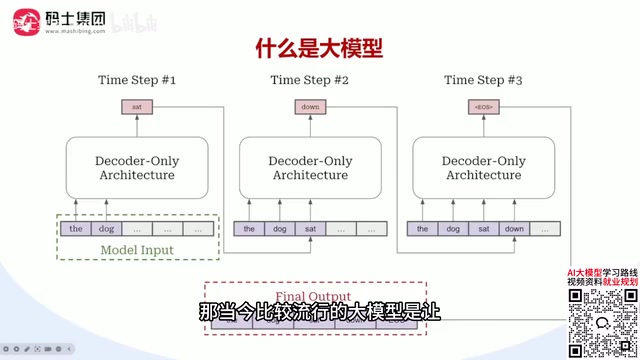
基于B站教程梳理大模型分布式并行核心知识:从decoder-only架构的逐token生成与X乘W计算本质出发,解析单卡瓶颈下数据并行、张量并行、流水线并行等6个关键问题,适合私有化部署与模型训练场景的学习者建立系统认知。