Cartograph:为AI智能体重构工具发现的联邦式代理方案
Cartograph用联邦代理与两阶段检索将AI工具发现的token消耗压缩近百倍,同时提升检索准确率。
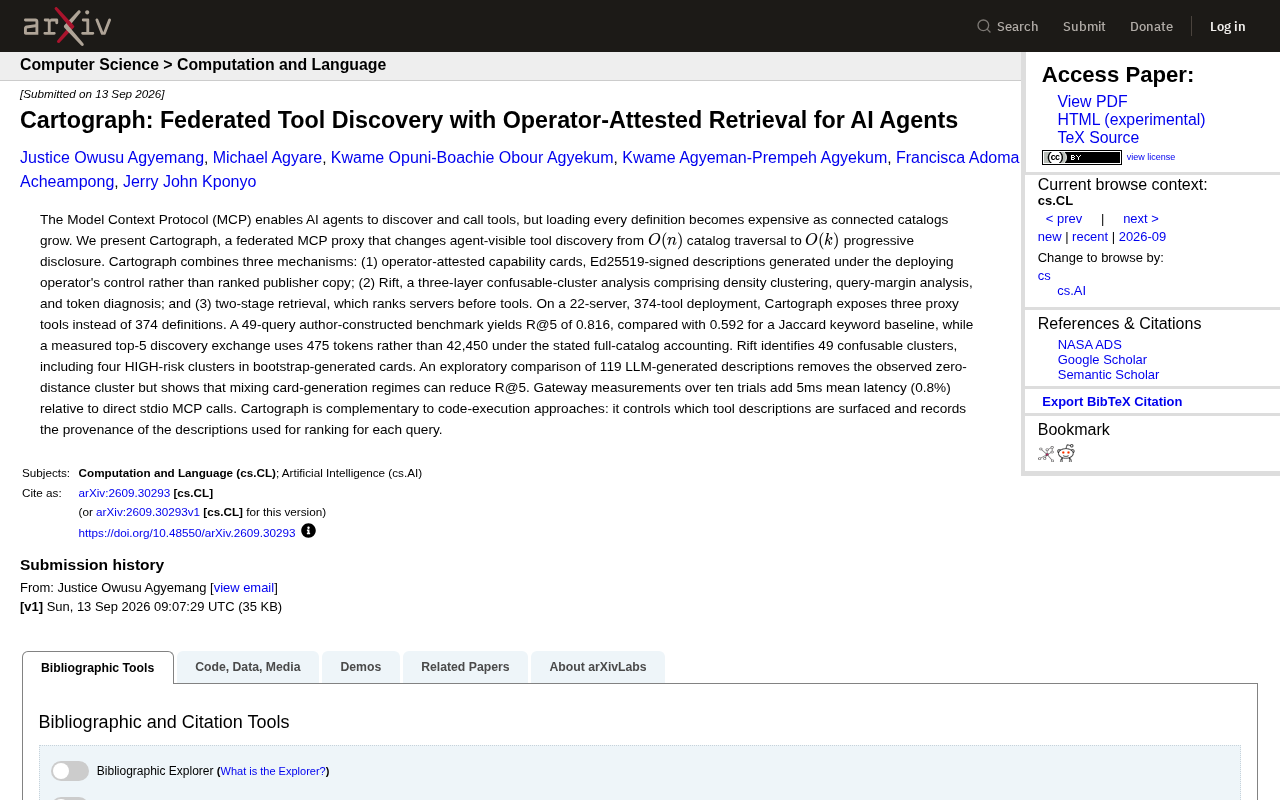
面对AI智能体工具目录规模化带来的token膨胀问题,arXiv新论文提出Cartograph——一个基于MCP协议的联邦式工具发现框架。其核心创新在于将O(n)全目录遍历改为O(k)渐进式披露,在374个工具的部署环境中仅向智能体暴露3个代理工具,使单次发现交互的token消耗从约42,450骤降至475。技术上依托三大机制:Ed25519签名的运营方背书能力卡片(解决描述可信度问题)、Rift三层混淆聚类分析(识别易混淆工具对)、以及先服务器后工具的两阶段检索。评估结果显示R@5达0.816,显著优于Jaccard基线的0.592,且网关延迟开销仅增加约5ms(0.8%)。该方案定位为与代码执行类方案互补,专注工具发现与来源溯源层。
当AI智能体连接的工具目录越来越庞大时,一个隐蔽的成本问题浮出水面:为了让智能体"知道"有哪些工具可用,系统往往需要把所有工具定义一次性塞进上下文。这在小规模场景下无关紧要,但当目录从几十个工具膨胀到数百甚至上千个时,token 开销和检索准确率都会急剧恶化。arXiv 最新公开的论文提出了 Cartograph——一个针对 Model Context Protocol(MCP)的联邦式代理方案,试图从根本上改变这一发现机制。
从 O(n) 遍历到 O(k) 渐进式披露
MCP 的核心价值在于让 AI 智能体能够发现并调用外部工具。但论文指出,随着连接的工具目录增长,"加载每一个工具定义"的做法变得越来越昂贵。传统方式本质上是 $O(n)$ 的全目录遍历——智能体每次都要面对完整的工具清单。
Cartograph 的核心思路是把这一过程降为 $O(k)$ 的渐进式披露(progressive disclosure)。在一个包含 22 台服务器、374 个工具的部署环境中,Cartograph 对智能体只暴露 3 个代理工具,而非 374 个完整定义。这意味着智能体不必在启动时就承担庞大的上下文负担,而是按需逐步获取所需工具信息。
这一改变在 token 消耗上的差异极为直观:论文测量的一次 top-5 发现交互仅使用 475 个 token,而在全目录核算方式下同样的操作需要约 42,450 个 token。近百倍的差距,正是大规模工具生态下的关键瓶颈所在。
Model Context Protocol(MCP)是由 Anthropic 于 2024 年末提出的开放协议标准,旨在统一 AI 智能体与外部工具、数据源之间的接口规范。其核心思想类似于编程语言的"包管理器"——工具发布者按照统一格式描述工具能力,智能体则通过协议动态发现和调用这些工具,而无需为每个工具单独编写适配代码。MCP 的推广使得"工具生态"得以快速扩张,但也因此带来了本文讨论的规模化困境:当生态中工具数量爆炸式增长时,协议本身并未规定如何高效筛选工具子集,默认行为仍是将全部工具定义注入上下文。
三大机制:签名凭证、混淆分析与两阶段检索
Cartograph 的实现建立在三个相互配合的机制之上,每一个都针对工具发现中的具体痛点。
运营方背书的能力卡片
第一个机制是"运营方背书的能力卡片"(operator-attested capability cards)。这些卡片采用 Ed25519 签名,由部署运营方在自己的控制下生成,而不是直接采用工具发布者可能"排名优化"过的官方描述。这一设计的意图很清晰:把工具描述的可信度和 provenance(来源溯源)掌握在部署方手中,避免被发布者的营销式文案误导检索排序。
Ed25519 是一种基于椭圆曲线 Diffie-Hellman(Edwards 曲线变体)的数字签名算法,以高性能、短密钥、强安全性著称,被广泛用于 SSH、TLS 及区块链等场景。在 Cartograph 中,运营方使用自己持有的 Ed25519 私钥对能力卡片内容进行签名,任何验证方只需持有对应公钥即可确认卡片未被篡改、且确实出自该运营方。这一机制解决的是"谁来定义工具描述"的信任问题:工具发布者有动机夸大或优化描述以提升被调用概率(类似 SEO),而运营方背书则将描述权与最终使用责任绑定在一起,形成更可靠的 provenance 链条。
Rift:三层混淆聚类分析
第二个机制名为 Rift,是一套三层的"可混淆聚类"分析,包括密度聚类、查询边际分析(query-margin analysis)和 token 诊断。它的作用是识别那些容易被智能体混淆的工具描述。在实验中,Rift 识别出了 49 个可混淆聚类,其中包括 4 个存在于自动生成卡片中的"高风险"聚类。这类分析对于保证检索准确性至关重要——当多个工具描述在语义空间中过于接近时,智能体极易调用错误的工具。
密度聚类(如 DBSCAN 算法)是一类不预设簇数量、而是根据样本在向量空间中的分布密度来自动识别"高密度区域"的无监督学习方法。在工具描述场景下,每个工具的文本描述被嵌入为高维向量,密度聚类能够找出语义上彼此高度相似的工具集合——这些集合正是智能体容易"认错"的混淆源。查询边际分析则进一步检验:当一条查询同时激活同一聚类内的多个工具时,排名分数之间的差距(边际)越小,混淆风险越高。Token 诊断则从词汇层面补充,识别描述中导致语义重叠的关键词模式。三层机制联合,能够系统性地定位检索准确率的薄弱环节。
两阶段检索
第三个机制是两阶段检索:先对服务器进行排序,再对具体工具排序。这种"先粗后细"的层次化检索思路,与渐进式披露的整体设计一脉相承,能够在减少候选集的同时保持召回质量。
实验数据:召回率与延迟的双重验证
论文用一组作者构建的 49 条查询基准进行评估。结果显示,Cartograph 的 R@5 达到 0.816,而基于 Jaccard 关键词匹配的基线仅为 0.592。这一提升说明,语义化的两阶段检索显著优于传统的关键词匹配方式。
在延迟方面,作者在十次试验中测量了网关引入的开销,相较于直接的 stdio MCP 调用,平均仅增加 5ms(约 0.8%) 的延迟。换言之,Cartograph 在大幅削减 token 成本、提升检索准确率的同时,几乎没有引入可感知的性能负担。
值得关注的是论文中一项探索性对比:作者用 119 条 LLM 生成的描述做实验,发现这样能消除观察到的"零距离聚类"(即完全重合、极易混淆的描述),但同时也揭示了一个警示——混合不同的卡片生成机制反而可能降低 R@5。这提醒实践者,描述生成的一致性本身也是影响检索质量的变量。
R@5(Recall at 5)是信息检索领域的标准评估指标,衡量的是:在系统返回的前 5 个结果中,有多大比例包含了真正相关的工具(即实际应被调用的工具)。R@5 = 0.816 意味着在测试的 49 条查询中,约 81.6% 的情况下正确工具出现在了前 5 个候选里。Jaccard 关键词匹配是一种经典的集合相似度方法,计算两段文本共有词汇占并集词汇的比例,实现简单但对同义词、近义词、语序变化等语义关系完全不敏感,因此在自然语言描述多样的工具目录中表现偏弱,这也解释了其 0.592 的显著差距。
定位:与代码执行方案互补
论文特别强调,Cartograph 与"代码执行"类方案是互补关系,而非替代。它的职责是控制哪些工具描述被暴露给智能体,并为每次查询记录用于排序的描述来源。也就是说,Cartograph 关注的是"发现"与"可信溯源"这一层,而具体的工具调用执行仍可交由其他机制处理。
从工程视角看,这一定位相当务实。随着 MCP 生态和多工具智能体的普及,工具发现的可扩展性、可信度与成本控制正在成为绕不开的现实问题。Cartograph 提出的联邦式代理架构,为这一问题给出了一个兼顾效率、准确率与安全溯源的技术路径。
小结
Cartograph 的价值不仅在于把 token 开销从数万降到数百,更在于它把"工具描述从何而来、能否被信任"这一治理层面的问题纳入了检索设计。签名凭证、混淆聚类分析和两阶段检索三者结合,构成了一个可扩展、可审计的工具发现框架。对于正在构建大规模智能体系统的团队而言,这类研究提供了值得借鉴的架构思路——尽管其基准仍属作者自建、规模有限,实际落地效果仍需更广泛的验证。
相关推荐
如何有效呈现你的想法:三种揭示式演讲方法
揭示式演讲是传递想法最直接的方式。本文解析奇妙漫步、动态演示和梦想图景三种演讲类型,结合David Gayo、Michael Pritchard、Sylvia Earle等经典案例,教你如何有效呈现想法。
Modern Web Guidance:让AI写原生声明式对话弹窗
Google Modern Web Guidance 让 AI 编程助手在生成代码时优先使用浏览器原生声明式 dialog 能力,替代重复的 JavaScript 事件监听,实测可显著减少样板代码。
ChatGPT 贴纸功能掀起 iMessage 与 WhatsApp 创意风暴
ChatGPT 图像生成功能正在 iMessage 和 WhatsApp 中催生个性化贴纸创作热潮,通用 emoji 使用量降至十年最低。本文分析这一趋势背后的技术逻辑、传播机制与对内容创作者的意义。