差分隐私在线专家预测:小损失下实现近最优遗憾界

首个差分隐私在线专家算法在小损失下达到 Õ(√L*) 遗憾界,并证明自适应输入下 Ω̃(√T) 不可避免。
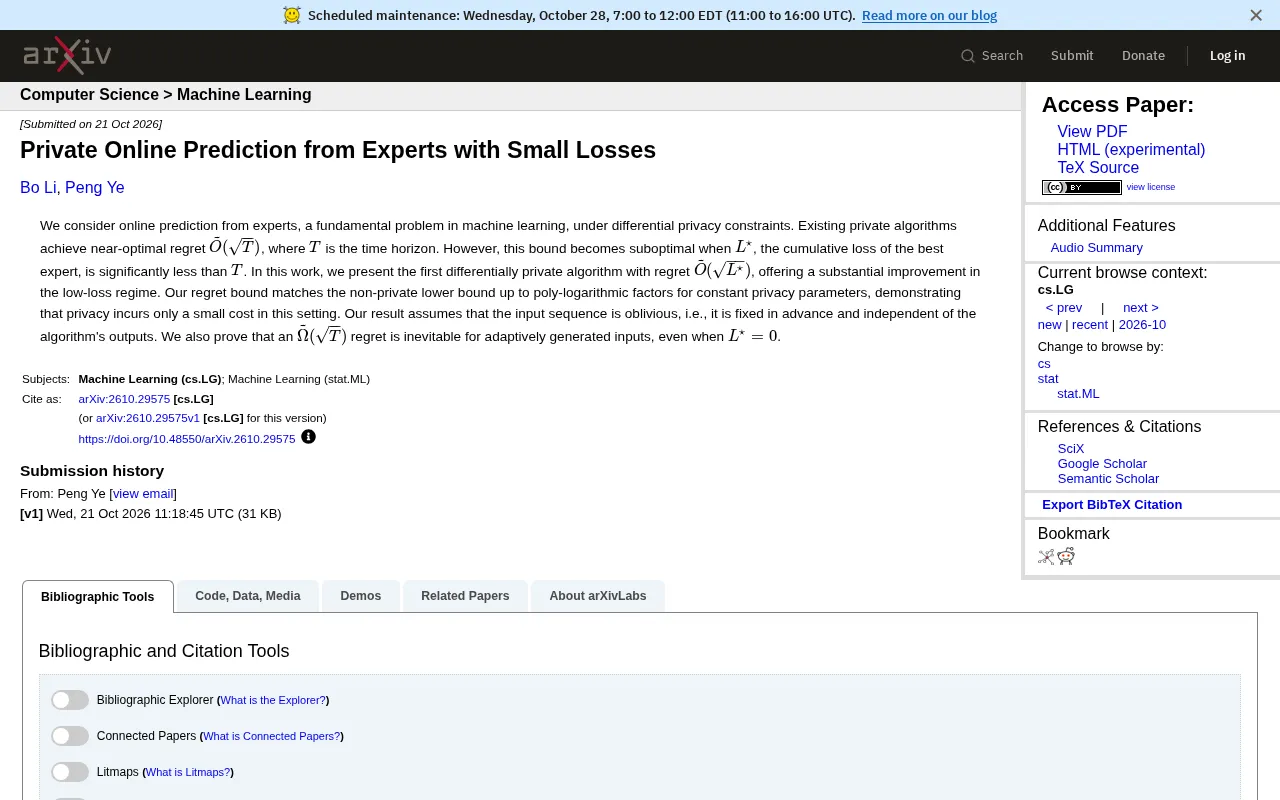
本文研究差分隐私约束下的在线专家预测问题。现有隐私算法的遗憾界为 Õ(√T),当最佳专家累积损失 L* 远小于 T 时次优。论文提出首个差分隐私算法,在 oblivious 输入下达到 Õ(√L*) 的遗憾界,与非隐私下界仅差多对数因子。算法基于差分隐私 FTRL 框架,通过自适应调整学习率和噪声尺度,利用小损失时损失序列的集中性降低噪声影响。理论界为 O(√(L* log N) + √(T log N)/ε)。论文进一步证明,对于自适应输入,即使 L*=0,任何差分隐私算法也无法避免 Ω̃(√T) 的遗憾,表明自适应环境下隐私代价不可避免。该工作填补了隐私在线学习在低损失区域的空白。
在线专家预测(Online Prediction from Experts)是机器学习中的基础问题,在广告推荐、投资组合选择等场景有广泛应用。当引入差分隐私约束时,现有算法能达到接近最优的 Õ(√T) 遗憾界(T 为时间步长)。然而,当最佳专家的累积损失 L* 远小于 T 时,这一界变得次优。最近一篇论文提出了首个差分隐私算法,在小损失情况下实现 Õ(√L*) 的遗憾界,显著改进了低损失区域的性能,并证明在常数隐私参数下,与非隐私下界仅差多对数因子。
问题背景:在线专家预测与差分隐私
在线专家预测问题中,学习器每轮从 N 个专家中选择一个,并承受所选专家的损失。目标是使累积损失与最佳专家累积损失 L* 的差值(即遗憾)最小。经典算法如 Hedge 在 oblivious 输入(输入序列预先固定)下达到 O(√(T log N)) 的遗憾,且该界在一般情况下是紧的。
差分隐私要求算法输出对任意单个输入的变化不敏感,以保护用户数据。现有隐私算法通过添加噪声实现隐私,但往往导致遗憾界退化。此前最优的隐私算法遗憾界为 Õ(√T),当 L* ≪ T 时,该界远高于非隐私下界 Õ(√L*)。
核心贡献:小损失下的近最优隐私算法
论文提出了首个差分隐私算法,在 oblivious 输入下达到 Õ(√L*) 的遗憾界。这一界与非隐私下界在常数隐私参数下仅差多对数因子,表明隐私的代价在小损失区域非常小。算法基于差分隐私的 Follow-the-Regularized-Leader 框架,通过自适应调整学习率和噪声尺度,利用 L* 较小时损失序列的集中性来降低噪声影响。
理论分析表明,算法的遗憾上界为 O(√(L* log N) + √(T log N)/ε),其中 ε 为隐私参数。当 L* 较小时,第一项主导,接近非隐私最优。该结果适用于 oblivious 输入,即输入序列与算法输出独立。
自适应输入的不可避免性
论文进一步证明,对于自适应生成的输入(即输入可能依赖于算法之前的输出),即使 L* = 0,任何差分隐私算法也无法避免 Ω̃(√T) 的遗憾。这表明自适应环境下隐私的代价不可避免,与 oblivious 情形形成鲜明对比。该下界通过构造一个对抗性环境证明,其中损失序列根据算法输出动态调整,迫使算法探索。
这一结果澄清了隐私在线学习的局限性:在自适应场景中,小损失优势无法实现,隐私必然导致遗憾增加。
意义与展望
该工作填补了隐私在线学习在低损失区域的空白,为实际应用中损失较小的场景(如推荐系统中用户兴趣集中)提供了更高效的隐私保护方案。未来方向包括放松 oblivious 假设、研究更一般的隐私模型(如本地差分隐私),以及将技术扩展到其他在线学习问题(如 bandit 反馈)。
相关推荐
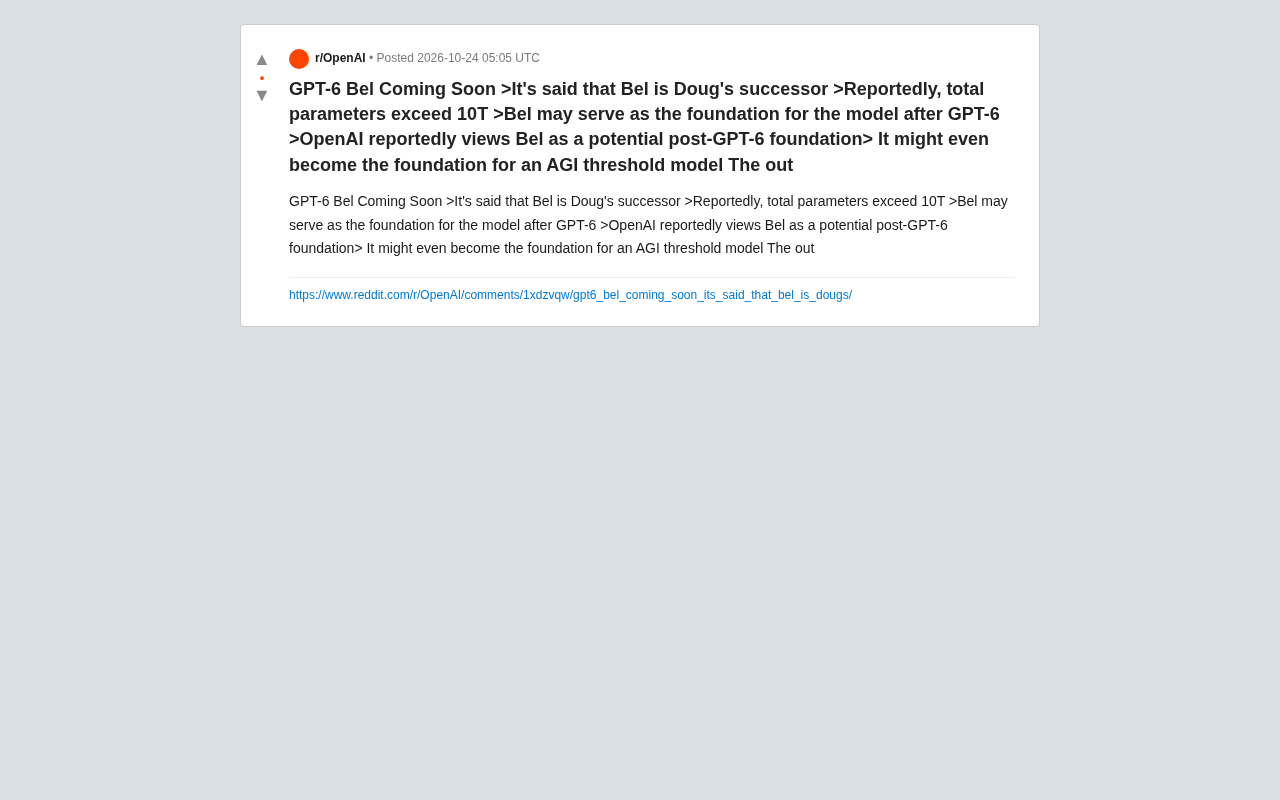
OpenAI新模型Bel曝光:10万亿参数,或成AGI基座
Reddit爆料称OpenAI新模型Bel即将问世,总参数超10万亿,或作为GPT-6之后的基础模型甚至AGI门槛基座。本文拆解爆料关键信息并评估可信度。
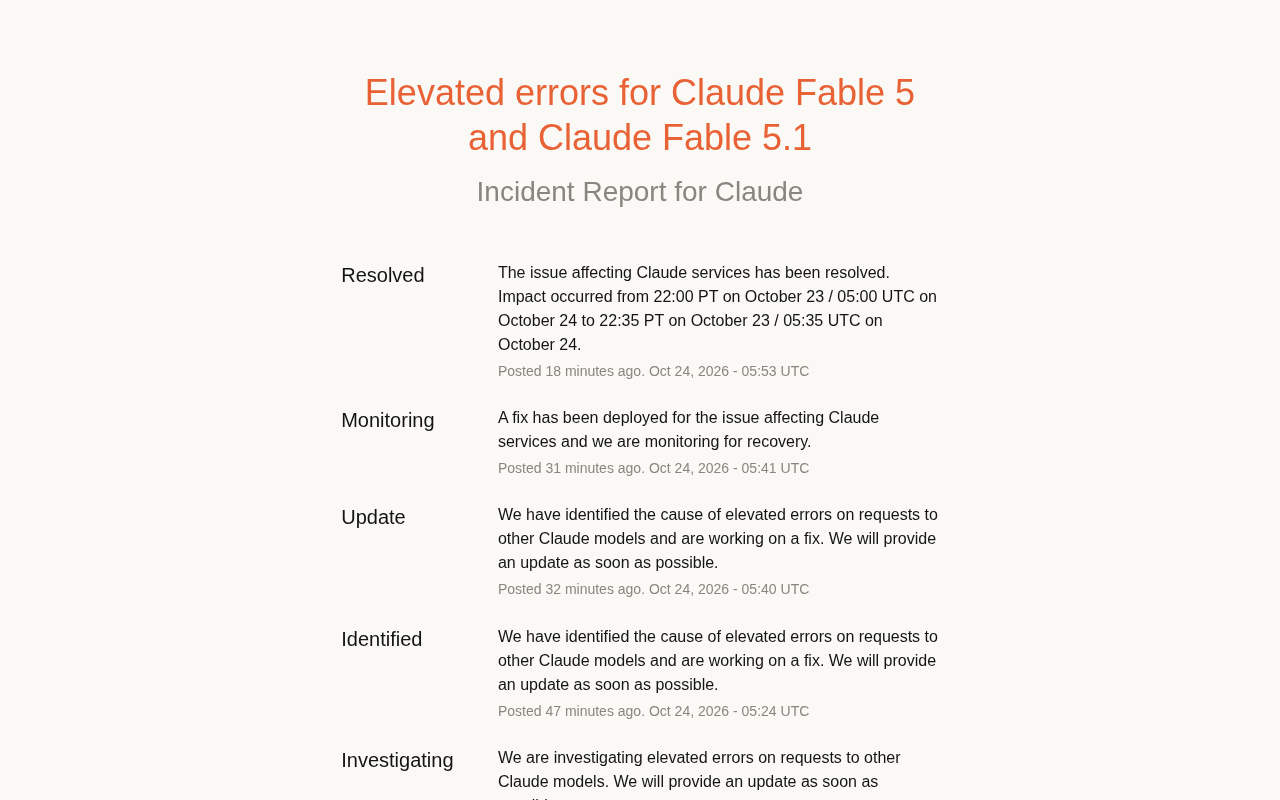
Claude Fable 5/5.1报错事件:30分钟故障复盘
Claude Fable 5与Fable 5.1出现错误率升高的服务故障,官方状态页显示影响约35分钟,从Investigating到Resolved仅用37分钟。本文还原故障时间线,分析对其他Claude模型的波及范围,并给出开发者重试、多模型路由与监控告警的应对建议。
Kimi K3.1开源模型实测:3万亿参数挑战闭源巨头
Kimi K3.1 开源权重模型深度实测:3万亿参数MoE架构、100万token上下文,3D渲染惊艳但空间推理与事实准确性存短板。基准逼近Opus 5.5,每任务成本仅2.11美元,开源前沿的真实水位全解析。