ChatGPT与Codex额度池合并:12月起聊天编程共用额度

ChatGPT与Codex额度12月起合并,国产模型网传动向密集但均无官方确认。
报道梳理了近期AI圈多条并行消息:OpenAI旗下ChatGPT与Codex额度池将于12月合并,聊天与编程共用配额,按用量单位消耗且高级模型消耗更快;编程工具创始人对“模型变笨”争议跑基准回应,承认两个低流量配置有问题并将停掉;同一厂商收紧设备登录付费账号上限;英伟达为国产轻量模型推出压缩版权重,同卡可多塞一个模型;编程工具公司开源跨系统本地语音输入。国产下一代模型方面,智谱后训练、阿里内测入口与版本号泄露、加强版模型名出现在评测脚本等均为网传,官方无公告。此外还有文生图蒸馏与图像压缩两条开源消息,以及编程工具两档定价的取舍分析。
据B站AI晚报栏目报道,OpenAI旗下ChatGPT与Codex两条产品线的额度即将合并,官方帮助页显示该调整自12月起生效。这意味着用户在同一账户下的聊天与编程用量将共享同一个额度池,额度按用量单位消耗,模型越高级消耗越快。
话说回来,围绕编程工具模型是否被削弱的争议、设备登录上限的收紧、英伟达对国产轻量模型权重的压缩,以及国产下一代模型的网传动向,构成了近期AI圈的多条并行叙事。
一、额度池合并:聊天与编程共用一份配额
合并的具体范围
据B站UP主在AI晚报中的梳理,此次合并的是“聊天那条线”和“编程那条线”,即ChatGPT与Codex的额度池打通。官方帮助页明确标注12月起生效。
额度按用量单位计算,模型越高级,单位消耗越快。日常纯聊天是否扣额度?报道称纯聊天那条不记录额度,但合并后的具体扣减规则仍需以官方页面为准。额度用完后,用户可选择等待重置、升级套餐或购买点数。
为什么现在就该看一眼
UP主给出的行动建议很直接:去设置里查看合并后的用量情况,心里先有个数,避免等到12月才发现额度不够用。对于同时使用聊天和编程功能的用户,原本两条线各自独立的缓冲空间将不复存在。
什么是“额度池”与“用量单位”?
在AI订阅服务中,额度池(quota pool)指账户可消耗的总计算资源配额,通常以“用量单位”计量。不同模型因推理成本差异,每单位用量对应的实际token数或请求次数不同:高级模型(如GPT-4级别)单次调用消耗的单位更多,轻量模型则较少。合并额度池意味着聊天与编程两条产品线不再各自拥有独立配额,而是共享一个总池。对用户而言,这既可能提高资源利用率(闲置额度可跨场景使用),也可能导致某一场景重度使用时挤压另一场景的可用量。理解“按用量单位消耗、模型越高级消耗越快”是预判合并后体验变化的关键。
二、编程工具模型“变笨”争议:官方跑基准回应
针对有用户反馈编程工具里的模型变笨,工具方创始人公开回应称,自己把能找到的基准都跑了一遍,整体结果落在同一个区间内。
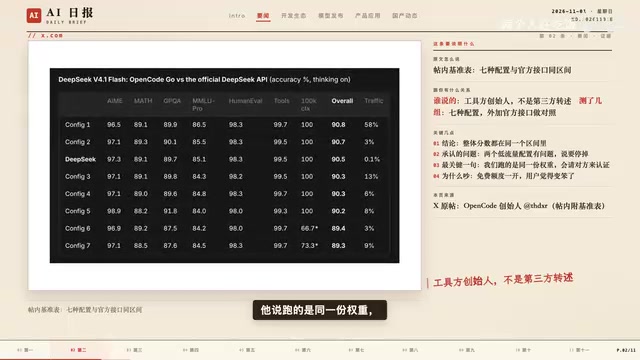
他同时承认,有两个低流量配置确实存在问题,并计划停掉这些配置。回应的依据是“跑的是同一份权重”,并表示会请对方来认证。这一表态把争议从主观感受拉回到可复现的基准测试层面,但低流量配置的问题也说明部分用户的实际体验偏差并非空穴来风。
“跑基准”与“同一份权重”意味着什么?
基准测试(benchmark)是评估模型能力的标准化任务集,如代码生成、数学推理等。创始人称“把能找到的基准都跑了一遍,整体结果落在同一个区间内”,意在说明模型输出与历史版本在统计上无显著差异,从而反驳“变笨”的主观感受。而“跑的是同一份权重”强调服务端并未偷偷替换模型文件——权重(weights)是模型训练后得到的参数,同一份权重理论上应产生一致行为。不过,推理服务的配置(如温度、最大token数、负载均衡策略)也可能影响实际体验,这正是“低流量配置存在问题”所指向的灰色地带。
三、设备登录上限收紧:多账号用户需重算名额
同一家厂商还调整了设备登录规则:一台设备能登录的付费账号数量现在有了上限。超过上限时,界面会提示设备数量达到上限,该账号将无法使用,即使已付费也可能被登出。
退出另一个账号能否腾出位置?官方表示不保证。官方给出的替代路径是购买点数或重置用量。对习惯多设备、多账号切换的用户来说,需要提前算清楚名额分配。
四、英伟达为国产轻量模型推出压缩版权重
英伟达为国产轻量模型发布了压缩版权重,从475压缩到大约400。效果方面,两个基准对比只下降零点几,属于可接受的微弱损失。
对用户的直接价值是:同样的卡能多塞一个模型,省钱。权重仓采用英伟达官方许可,放得很宽。至于为什么由芯片厂商来做这件事——只有他们最清楚自己的卡怎么跑最划算。
模型压缩与“压缩版权重”是什么?
模型压缩旨在减少参数量或数值精度,以降低显存占用和推理成本。常见方法包括量化(如FP16转INT8)、剪枝和知识蒸馏。文中“从475压缩到大约400”很可能指参数量(单位可能是亿或GB显存占用)的缩减。压缩版权重通常伴随轻微精度损失,报道中“两个基准对比只下降零点几”即量化误差的体现。芯片厂商推动此类工作,是因为其最了解自家GPU的算力特性与显存带宽,可针对硬件做最优压缩策略,从而让同一张卡容纳更多模型实例,直接降低用户的单位推理成本。
五、编程工具开源跨系统语音输入
那家做编程工具的公司开源了一款语音输入工具,最大卖点是本地运行、音频不上传。它不限于自家软件,而是跨整个系统可用,对着电脑说话就能出字。
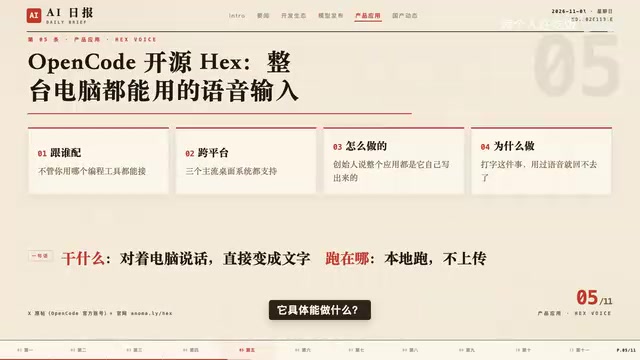
创始人透露,连动画和音效都是他自己写的。本地运行的好处是延迟低、音频不出电脑,对天天写代码的人而言能显著减少打字量。
六、国产下一代模型:网传消息密集但均无官方确认
智谱:后训练阶段
网传智谱下一代模型进入后训练阶段,即大训练之后针对具体任务再调一轮。细节方面,内部三个尺寸的模型正在往一起合并。但该消息只有网传和一张截图,官方未发一字。后训练到发版之间还隔着评测和调优。
阿里:内测入口与版本号泄露
据B站UP主和社区挖掘,有人从代码里挖出了下一代模型的名称字样,包括“家常版”和内测邀请标识,配置里有四档推理强度、默认给最高那档。官方未公布具体日期,只说此前预告过下周,具体日期没说。
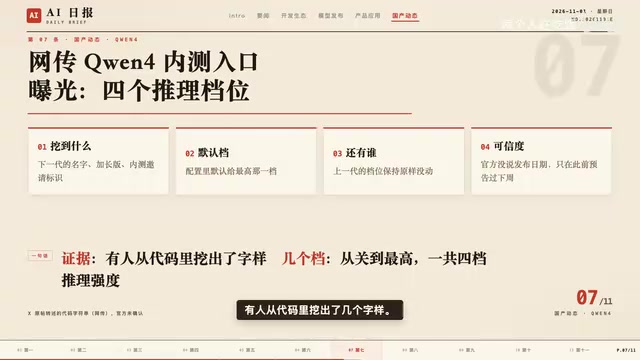
另有用户发现下一代版本号出现在自己的用量页里:界面仍显示旧名字,后台统计换了新号,其中一张截图里新号占了将近两成用量。这不是正式发布,官方没公告,只能算疑似灰度泄露。字段泄露不必然意味着即将上线,以往也有漏了字段最后没上的先例。
加强版模型名出现在评测脚本
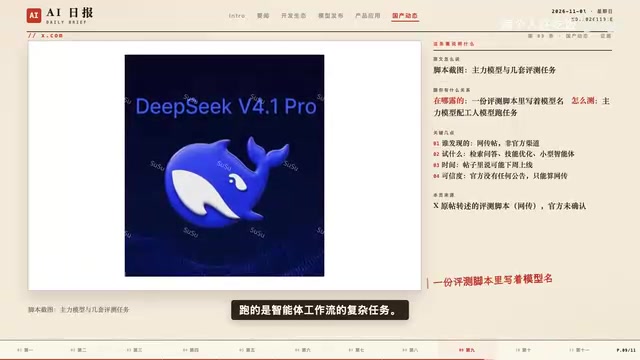
一份评测脚本里写着一款加强版模型的名称。测试方式是主力模型加工人模型跑几套任务,跑的是智能体工作流的复杂任务,而非单纯聊天。帖子里说可能下周上线,官方无公告。加强版与大版本的区别在于同一条线再训一轮,算力少一些。
“后训练”“灰度泄露”与“加强版”辨析
后训练(post-training)指基座模型完成大规模预训练后,针对指令遵循、安全对齐或特定任务进行的再训练阶段,通常包括监督微调(SFT)和强化学习(RLHF)。网传“进入后训练阶段”意味着模型已具备基础能力,但距发布仍需评测与调优。灰度泄露(gray release leak)指产品在小范围用户中测试时,前端字段或后台统计被外部发现,但字段存在不必然代表即将上线。加强版模型(enhanced version)通常指在同一条模型线上再训练一轮,算力投入少于大版本迭代,侧重特定能力提升而非全面升级。理解这些术语有助于区分“网传信号”与“官方发布”之间的差距。
七、两条开源消息:文生图蒸馏与图像压缩
国内团队开源了文生图的蒸馏方法,出图只要一到两步,比常规快得多。海外一位开发者放出了图像压缩模型,做到两倍下采样,作者称效果能跟主流打平。
快和小的价值很实际:出图快能放进手机,压缩小能多存一倍的图。
八、编程工具定价:两档套餐与按量付费的取舍
该编程工具提供两档定价:便宜那档月费一美元、含十美元用量,贵的那档月费十美元、最多含一百美元用量。便宜档有几款模型直接免费。页面未写明价格是否永久,只能说目前如此。
对重度用户而言,额度用完后需再购买,未必比按量付费划算。
小结
多条消息中,唯一需要立刻动手的是:去设置里查看合并后的额度用量。额度池合并、设备上限收紧、模型争议回应,都指向同一个趋势——厂商正在更精细地管理用量与账号边界。国产模型的网传消息虽然密集,但在官方公告落地前,都只能当作灰度信号看待。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。