Cherry Studio+MCP实战:搭建自动化AI智能体与本地知识库

Cherry Studio教程详解从零搭建三个MCP智能体与本地知识库的全流程。
本文基于B站一期被称为“讲得最细”的Cherry Studio教程,梳理了从零搭建自动化AI智能体与本地知识库的关键步骤。教程演示了三个智能体:抓取网页数据存为CSV、调用搜索生成分析报告、通过MCP Share操作命令行终端,覆盖数据采集、内容生成与系统操作三类场景。前期需安装客户端并配置模型API,MCP环境是门槛最高的环节,需单独下载内置UV与Node环境。文中还记录了实际搭建中的摩擦点,如路径分隔符写错即报错、模型选择决定任务成败、智能体可能不按预期调用工具。本地知识库部分采用Ollama部署千问3与嵌入模型,问答全程本地运行以保障隐私。
在AI工具层出不穷的当下,如何把大模型能力真正接入自己的工作流,是很多人关心的问题。B站上有一期被观众称为“讲得最细”的Cherry Studio教程,用约20分钟完整演示了从零搭建自动化AI智能体与本地知识库的全过程。本文基于该视频内容,梳理其中的关键步骤与值得注意的细节。
三个智能体,三种自动化能力
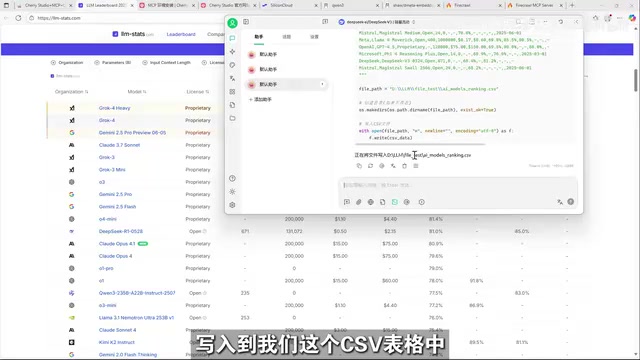
教程开篇先展示了最终效果:三个可用的AI智能体。第一个负责抓取网页数据并整理成CSV表格,保存到指定路径;第二个调用搜索工具生成图文并茂的分析报告并落盘;第三个通过MCP Share操作命令行终端,相当于远程操控电脑,无需手写命令。
这三个智能体覆盖了数据采集、内容生成和系统操作三类典型场景。视频作者同时演示了一个本地知识库——“员工助手”,用于回答员工手册相关问题。整个方案的一个明确取向是:对话模型和嵌入模型都尽量使用本地部署,以保证信息不外泄。
前期准备:模型与MCP环境
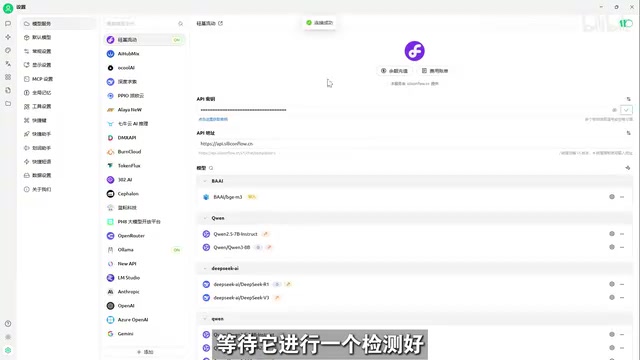
准备工作分两步。第一步是安装Cherry Studio客户端,直接到官网下载安装即可。第二步是配置模型。视频中作者建议使用带有免费额度的云端API(如硅基流动)来跑通流程,原因在于部分本地模型对MCP的支持不完善。配置方式是在设置中找到模型服务,填入API密钥后点击检测,界面提示连接成功即表示配置无误。
MCP环境的配置是整期教程中门槛最高的部分。Cherry Studio只能使用内置的UV和Node环境,不会复用系统已安装的版本,需在MCP设置中点击下载。由于下载源在国外,失败概率不低,作者给出了手动下载并放入对应路径的备选方案,并提醒可能需要科学上网。环境就绪后重启客户端,再安装Node.js,并在终端用node -v和npm -v验证。
MCP(Model Context Protocol,模型上下文协议)是由 Anthropic 提出并开源的标准化协议,目的是让大语言模型以统一的方式连接外部工具、数据源和服务。可以把 MCP 理解为 AI 应用的“USB 接口”:模型本身不直接写死调用某个软件,而是通过 MCP 服务器暴露文件系统、搜索引擎、命令行等能力,客户端再按需把这些能力挂载给模型。它的核心价值在于解耦——同一个工具实现可以被不同客户端复用,模型也无需为每个工具单独适配。Cherry Studio 中的 MCP 设置,本质上就是管理这些工具服务器的安装、启动与权限开关。
配置三个MCP工具
教程配置了三个MCP工具。第一个是内置的文件系统管理,可实现创建、写入、删除、移动、复制文件等操作。关键细节是参数中的路径必须使用反斜杠或双斜杠,单斜杠会导致报错——这是实际操作中最容易踩的坑之一。
第二个是Firecrawl(视频中口播为“Fearwell”),用于爬取网页数据和搜索检索,需要配置对应的API密钥,通过JSON导入方式添加到Cherry Studio。第三个是MCP Share,用于操作命令行终端。添加时类型选标准输出,命令为npx,参数为-y加固定包名,作者强调参数必须与演示完全一致,保存后显示绿色即表示配置成功。
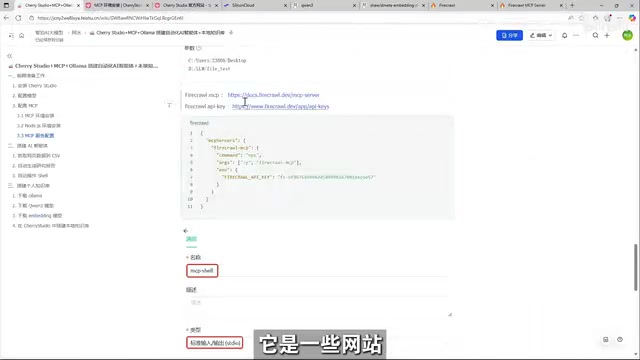
Firecrawl 是一个面向大模型的网页抓取与搜索服务,它能把网页转换成结构化的 Markdown 或 JSON,并支持整站爬取、内容提取和搜索检索。相比直接让模型读取原始 HTML,Firecrawl 会先做正文清洗与格式规整,显著降低上下文噪音和 token 消耗,因此常被用作智能体的“网页读取器”。它提供云端 API 和自托管两种形态,教程中使用的是云端 API 方式,需要在官网注册获取密钥。MCP Share 则是一个通用的 MCP 服务启动器,通过 npx 动态拉取并运行指定的 MCP 服务器包,这也是为什么参数中的包名必须与演示完全一致。
搭建自动化智能体
智能体的搭建在对话界面完成:新建对话,按需开启对应的MCP开关,再输入提示词。第一个智能体需要同时启用文件系统与网页抓取两个工具。作者选用DeepSeek广告 V3,理由是网页数据量大、需要较长的上下文支持,小模型容易“查不到”。
实际运行并非一次成功。第一次尝试中模型调用了Python来保存文件,路径不对导致失败;切换到其他模型后效果仍不理想,最终换回DeepSeek V3才成功把网页表格抓取并写入本地CSV。作者对此的总结颇有意思:大模型和人一样,不能保证百分百正确,出错后需要人工判断并调整。
第二个智能体用搜索工具围绕指定显卡型号撰写中文报告,生成结果图文并茂、带有数据支撑。第三个智能体演示查询本地模型版本号,第一次运行时模型没有调用MCP Share,关闭其他两个工具后重试才成功,返回版本0.9。这也说明工具权限的精确控制会影响智能体的行为路径。
本地知识库:Ollama+千问3+嵌入模型
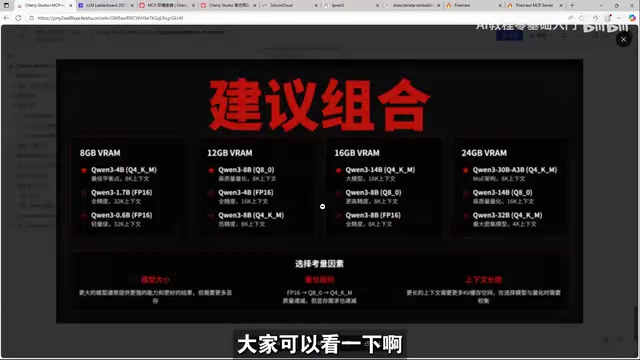
第三部分搭建个人知识库。首先下载Ollama用于部署本地大模型,一键安装后在终端验证版本。接着拉取千问3对话模型,作者给出了一张按显存选择模型规格的参考表,并实际选用8B版本演示,首次下载大约需要二十分钟。
随后下载嵌入模型,该模型下载量约180k,首次拉取同样需要十多分钟。两个模型就绪后,在Cherry Studio的模型服务中添加Ollama,API地址为localhost:11434,将对话模型和嵌入模型加入并检测连接。
知识库的创建在“知识库”页面完成:新建知识库、选择本地嵌入模型、拖入员工手册文件。之后新建助手、开启知识库、选择本地对话模型,提问“员工旷工怎么处理”,模型返回了两条引用内容,覆盖旷工一天、两天、三天的对应处理办法,并能定位到文档中的“迟到早退旷工”章节。整个问答过程模型全部运行在本地。
嵌入模型(Embedding Model)负责把文本转换成一串高维向量,语义相近的文本在向量空间中距离更近。知识库的检索流程通常是:文档被切分成若干片段后由嵌入模型转为向量存入向量库;用户提问时,问题同样被转为向量,系统按相似度召回最相关的片段,再交给对话模型生成答案。这解释了为什么对话模型和嵌入模型需要分别配置——前者负责“说”,后者负责“找”。需要注意,嵌入模型一旦选定,知识库中已入库的文档向量就与该模型绑定,中途更换嵌入模型通常需要重建索引,否则检索结果会明显失准。
值得注意的经验
这期教程的价值不只在于步骤演示,更在于暴露了真实搭建中的摩擦点:MCP环境下载容易失败、路径分隔符写错就报错、模型选择直接决定任务成败、智能体可能不按预期调用工具。这些细节在纯文档教程里往往看不到,却是新手最容易卡住的地方。
另一个隐含信息是模型分工:云端模型负责需要长上下文和工具调用的重任务,本地模型负责隐私敏感的对话与检索。这种混合架构在隐私与能力之间取得了平衡,对希望把AI落到日常工作的用户来说,是一个务实的起点。
相关推荐

Agentic Paper Bomb:用多智能体自动生成企业合规文档
Reddit 开发者分享 Agentic Paper Bomb 实验:让五个 AI 智能体扮演高管角色,自动生成企业合规、安全、DevOps 等文档。探讨多智能体协作生成文档的潜力与隐忧。

《Rob Roy》经典台词解析:领导者的代价与生存抉择
解析《Rob Roy》中Rob Roy与Sibbald的经典对峙台词,探讨领导力的代价、生存与尊严的权衡,以及权力博弈背后的人性洞察。

黄仁勋被曝聘请擅长处理丑闻的公关公司
据 Wired 报道,黄仁勋在《纽约时报》报道其妻子商业往来后,聘请了一家曾处理高知名度性丑闻的公关公司。本文分析这一举动背后的危机管理信号及其对英伟达声誉的影响。