Claude Code本地化部署全解析:用本地模型玩转Vibe Coding

本文讲解如何将Claude Code对接本地大模型,摆脱token计费并实现离线可用。
Claude Code是Anthropic推出的代码场景AI Agent,默认调用云端Opus模型并按token计费。本文介绍了一种本地化部署方案:通过推理引擎(Ollama、vLLM、llama.cpp等)将本地模型包装成符合标准API规范的服务,再让Claude Code对接,从而实现断网可用、零token成本。文章系统梳理了推理引擎的选型逻辑(个人用Ollama/LM Studio,企业高并发用vLLM),分析了本地模型效果与GPU显存的正相关关系,并介绍了量化技术作为降低硬件门槛的实用手段。整体方案支持Linux、Windows、macOS全平台,非英伟达显卡需安装厂商对应套件。
Claude Code到底是什么
Claude Code(简称CC)本质上是一个专注于代码场景的Agent智能体。从名字就能看出,它的核心价值在于帮助开发者完成与代码相关的工作——阅读、编写、调试、重构。它背后默认连接的是Anthropic官方的服务器,通过API调用云端的大模型(默认使用的是Opus系列模型,也可以通过配置切换到其他版本)。
但对很多开发者来说,一个现实的痛点随之而来:每次调用都在消耗token,长期使用成本不低。如果能把Claude Code与本地部署的模型打通,不仅可以在断网环境下使用,还能彻底摆脱token计费的顾虑。这正是本地化部署方案的意义所在。
本地化部署的核心原理
理解本地化部署,关键是看清Claude Code与模型之间的连接方式。Claude Code(以及功能类似的CodeX)作为前端的编码Agent,并不关心背后的模型跑在哪里,它只需要一个符合规范的API服务去对接。

整个链路可以拆成三层:Claude Code作为客户端,中间是一个推理引擎(Inference Engine),底层是实际运行的大模型。只要用推理引擎把本地模型包装成一个server服务,暴露出标准的API接口,Claude Code就能像连接官方服务器一样连接到你自己的本地模型。
这个设计的巧妙之处在于解耦。无论你用的是英伟达GPU、AMD显卡,还是专用计算卡,只要能找到适配对应硬件的推理引擎并把它跑成服务,Claude Code都能无感接入。
推理引擎怎么选
当前市面上可用的推理引擎相当多,适用场景各有侧重:
Ollama
上手最简单、个人用户最常用的选择。部署和推理都很友好,适合单机本地跑模型。但它的并发能力较弱,在真正的企业生产环境中用得较少。
llama.cpp
另一款广泛使用的推理引擎,以轻量和兼容性见长,在资源受限的设备上也能运行。
vLLM
企业级高并发场景的主力选择。当需要支撑大量并发请求时,vLLM的吞吐能力明显优于个人向的工具。
LM Studio
带图形界面的推理工具,降低了本地模型部署的门槛。
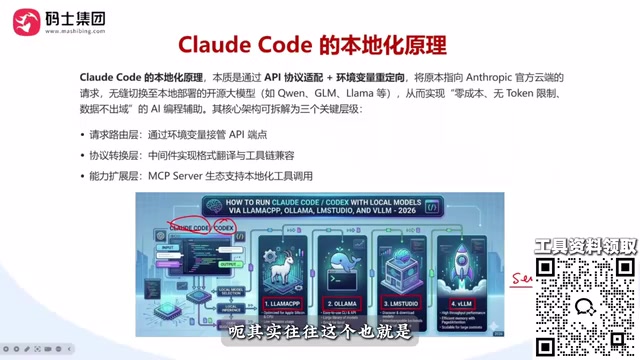
选型的逻辑并不复杂:个人学习、轻度使用选Ollama或LM Studio足够;团队协作、高并发需求则应考虑vLLM。关键一点是——无论哪款引擎,最终都要把模型变成一个可被API调用的服务,这是打通Claude Code的前提。
推理引擎(Inference Engine)的本质是一个运行时框架,负责将模型权重文件加载到内存或显存中,并对外提供标准化的HTTP接口(通常兼容OpenAI的API格式)。Claude Code在发起请求时,实际上是向这个本地服务发送符合OpenAI规范的JSON请求体,推理引擎接收后完成前向推理计算,再将生成的token流式返回给客户端。正因为业界已广泛采用OpenAI API格式作为事实标准,各类推理引擎只需做一次适配,就能被Claude Code、Cursor等不同的Agent工具无缝调用。
本地模型效果会不会很差
这是许多人最关心的问题。答案是:取决于你部署的模型大小,以及你的任务复杂度。
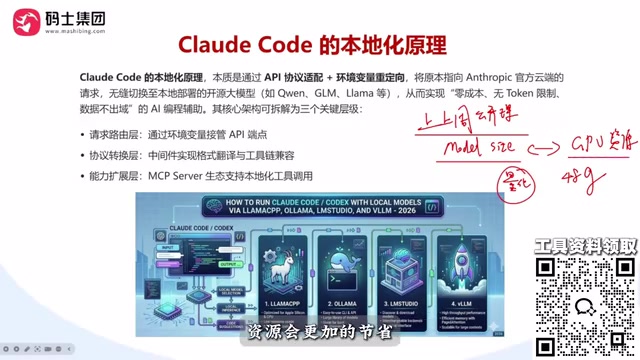
模型体积越大,通常能力越强、越"聪明"。而模型大小又直接受限于你的GPU资源。两者是正相关的——想跑更大的模型,就需要更好的、甚至多张GPU显卡;反之,7B、8B乃至4B这类较小的模型,往往单张显卡就能应付。
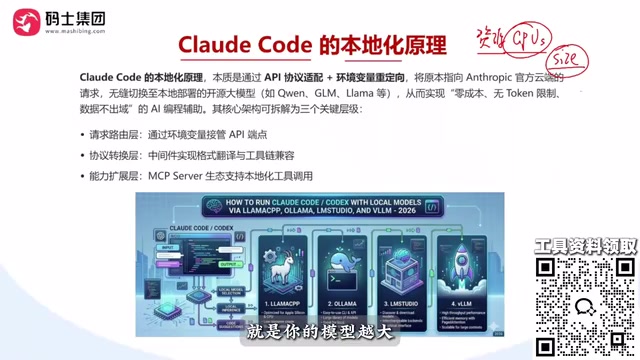
所以"效果好不好"没有标准答案,而要回到需求本身。如果你让模型做的事情越复杂,就需要越大的模型,相应也需要越强的硬件支撑。先想清楚"要让模型做什么",再反推需要多大的模型和什么级别的显卡,这才是正确的思路。
目前在代码任务上表现较好的开源本地模型包括DeepSeek广告 Coder系列、Qwen2.5-Coder系列以及Meta的CodeLlama等,它们专门针对代码理解与生成场景进行了微调。以Qwen2.5-Coder-7B为例,在消费级显卡(如RTX 3080 10G)上即可流畅运行,日常代码补全、函数生成、调试建议等任务已能胜任;若任务涉及复杂架构设计或多文件重构,则建议使用32B以上规模的模型。选择模型时,优先查看该模型在HumanEval、MBPP等代码基准测试上的得分,可作为能力参考的量化依据。
显卡配置的现实考量
硬件选择同样围绕"模型大小"展开。显存大小是关键指标——模型越大,占用的显存越多。
关于常见显卡的实际表现:
- RTX 3070 8G:计算能力偏弱,8G显存也略显局促,只能跑较小的模型。
- RTX 2080Ti 11G:显存同样有限,做模型部署时力不从心。
- MacBook M5 Pro 48G:统一内存达到48G,在本地跑中等规模模型相当有优势。
有一个实用技巧值得注意:量化模型。同样的模型经过量化处理后,在GPU中占用的资源会显著减少,这意味着用相对普通的显卡也能跑起更大的模型。
如果本地显卡确实不够用,云服务器是务实的替代方案。云平台提供从低端到高端的各级显卡选择,可以按需租用更强的算力来部署模型。对于手头只有入门级显卡的开发者来说,这是性价比很高的折中路线。
关于硬件适配还需提醒:日常所说的GPU加速默认指英伟达显卡——安装CUDA后即可在GPU上加速计算。若使用AMD或英特尔的显卡、或专用计算卡,则需要查找并安装对应厂商提供的套件和适配的推理引擎。
量化(Quantization)是指将模型权重从高精度浮点数(如FP16、BF16,每个参数占2字节)压缩为低精度整数(如INT8占1字节、INT4占0.5字节)的技术。以一个70亿参数(7B)的模型为例,FP16格式需要约14GB显存,而经过INT4量化后仅需约4GB左右,大幅降低了硬件门槛。常见的量化格式有GGUF(llama.cpp使用)和AWQ、GPTQ等。量化会带来轻微的精度损失,但在代码生成等任务上,4bit量化版本与原版的实际表现差距通常在可接受范围内。Ollama和LM Studio默认提供的模型文件大多已是量化版本,用户无需手动处理。
跨平台与系统兼容性
Claude Code的本地化部署对操作系统几乎没有限制。无论是Linux、Windows还是macOS,都可以完成部署。本教程演示的是在服务器(Linux环境)中进行部署,但原理在各平台通用。
整体来看,本地化部署Claude Code的技术路径已经相当成熟:选对推理引擎、把本地模型包装成API服务、再让Claude Code对接即可。真正需要权衡的,是模型规模、硬件资源与任务复杂度这三者之间的平衡关系。想清楚这一点,就能在成本、效果和可用性之间找到最适合自己的方案。
相关推荐

Auracast是什么?新一代蓝牙广播技术解析
Auracast是一种新型蓝牙音频广播技术,让耳机像收音机接收FM那样连接开放广播。本文解析Auracast在机场、课堂、无障碍场景中的应用价值及普及前景。

买房还是租房更划算?一对双胞胎30年的财务对比
TED-Ed 用一对双胞胎 30 年的真实财务模型对比买房与租房:从首付、房贷利息、再融资到维修成本和机会成本,解析为何"买房一定更划算"并非真理,帮你理清这道理财难题。

常见生育误区:年龄如何影响怀孕概率
关于生育的常见误区解析:30岁每月受孕概率约20%,年龄越大概率越低。了解不孕的医学定义、何时该尽早就医,以及备孕带来的心理压力。