Claude桌面端内置浏览器上线,AI Agent全面进化

过去24小时,AI技术圈迎来密集更新:从Anthropic为Claude桌面端上线内置浏览器,到英伟达首款智能体专属CPU量产交付,再到模型压缩与硬件互操作标准的突破。这些进展有一个共同主线——AI正在从「对话生成」加速迈向「自主执行」的智能体(Agent)时代。本文对这些关键动态进行梳理与解析。
Claude桌面端内置浏览器:Agent操作半径的关键突破
Anthropic今天正式为Claude桌面端上线了内置浏览器功能。这项升级的核心价值在于:Claude可以在独立的沙箱化浏览器中自主执行网页跳转、表单填写、元素抓取和动态数据解析,而不再需要用户在每一步操作时反复手动点击授权。
所谓沙箱化(Sandboxing),是一种将程序运行在隔离环境中的安全机制,最早广泛应用于浏览器安全领域(如Chrome的多进程沙箱架构)。Chrome浏览器在2008年率先采用这一架构,将每个标签页运行在独立的低权限进程中,即使单个页面被恶意代码攻破,攻击者也无法逃逸到主进程或操作系统层面。在AI Agent场景下,沙箱化面临更复杂的挑战:模型不仅需要读取网页内容,还需要主动执行点击、输入、导航等写操作,这意味着沙箱必须在「允许足够的操作自由度」和「防止越权访问」之间精确划线。当前业界主流的实现方式包括基于容器化技术(如Docker)的环境隔离、基于虚拟机的硬件级隔离,以及基于浏览器内核权限策略的软件级隔离。Claude内置浏览器意味着其网页操作被限制在一个与用户主系统隔离的虚拟环境中,即使自动化流程出现异常行为,也不会直接影响宿主操作系统的文件、凭据和进程。
这一设计与Playwright、Puppeteer等传统无头浏览器自动化工具的思路一脉相承,但关键区别在于:传统工具需要开发者编写精确的DOM选择器和操作脚本,而Claude内置浏览器由大模型通过语义理解驱动操作,能够处理页面结构变化、动态加载等传统脚本容易失效的场景。Playwright(由微软维护)和Puppeteer(由Google维护)是目前Web自动化测试领域最主流的两个框架,它们通过Chrome DevTools Protocol直接控制浏览器内核,能够精确模拟用户的所有交互行为。然而,这些工具的核心依赖是确定性的DOM选择器——开发者需要通过CSS选择器、XPath或者元素ID来精确定位页面元素。当目标网站改版、动态生成元素ID、或使用Shadow DOM等现代前端技术时,这些选择器极易失效,导致自动化脚本大面积崩溃。据行业估计,大型企业的Web自动化测试套件每月约有15-30%的用例因页面变更而需要维护修复,这构成了巨大的隐性成本。Claude的语义驱动方式从根本上绕过了这一脆弱性。
对于经常需要进行网页自动化测试、竞品信息监测、跨站点数据录入的开发者而言,这意味着原本繁琐的多步操作可以被打包成一个连贯的自动化工作流。过去需要人工「点一步、授权一步」的低效模式被彻底改变。
不过,这里有一个不可忽视的安全边界。涉及金融支付与高权限账号的操作,仍建议保持人工复核确认。沙箱化虽然隔离了执行环境,但自动化流程一旦出现语义误判,可能导致不可逆的操作。在权限与效率之间,Anthropic给出的默认答案是:把控制权保留在关键节点上。
从编程助手到网页Agent的演进逻辑
说个细节,这一功能延续了Anthropic在Agent能力上的一贯思路——让模型不仅能「理解」任务,还能「操作」真实环境。内置浏览器本质上是给Claude装上了一双能与Web世界交互的「手」,这标志着桌面端AI的操作半径正在从代码编辑器扩展到整个互联网。
大模型成本下探与开发生态协议进展
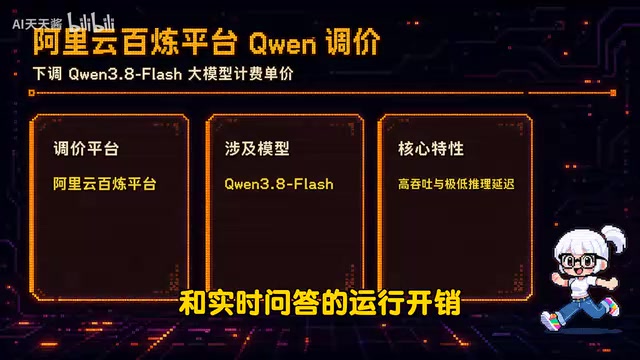
在模型调用成本方面,阿里云今天宣布正式下调百炼平台上**Qwen3轻量模型(Flash系列)**的API计费单价。Qwen3是阿里云通义千问系列的第三代大语言模型,其中Flash系列专为高吞吐、低延迟的在线推理场景设计,通常采用较小的参数规模配合推理优化技术(如KV Cache量化、推测解码等),在保持核心能力的同时大幅降低单次推理的计算成本。
KV Cache(Key-Value缓存)是Transformer模型在自回归生成过程中的核心机制——模型在生成每个新token时,需要访问之前所有token的Key和Value向量来计算注意力。随着上下文长度增加,KV Cache的内存占用呈线性增长,在128K上下文窗口下可能占据数十GB显存。KV Cache量化通过将这些缓存向量从FP16压缩到INT8甚至INT4,在几乎不影响生成质量的前提下将内存占用降低50-75%。推测解码(Speculative Decoding)则是另一种正交的优化策略:用一个小模型快速「草拟」多个候选token,再用大模型并行验证,从而将原本严格串行的逐token生成过程部分并行化,实测可带来2-3倍的推理速度提升。这些优化技术的综合运用,使得Flash系列能够以远低于全尺寸模型的成本提供实用级的推理服务。
作为主打高吞吐、低延迟的轻量主力模型,这次降价直接压低了高并发、智能体调用和实时问答的运行开销。值得注意的是,在智能体场景中,一个复杂任务可能需要模型进行数十次甚至上百次连续推理调用(包括任务规划、工具选择、结果校验等),因此轻量模型的单价变化会被放大数十倍体现在最终账单上。这也是为什么Flash系列降价对Agent开发者的实际影响远大于对普通对话场景用户的影响。
对于搭建自动化客服、进行海量文档批处理,或需要高频消耗Token的开发者团队来说,这波降价能切实缓解每月账单压力。尤其是对延迟敏感、预算严苛的工程项目,现在正是测试新计费策略的时机。
另一边,微软正式上线了Azure DevOps Remote MCP托管服务器。MCP(Model Context Protocol,模型上下文协议)是Anthropic于2024年底提出的开放标准,旨在为AI模型与外部工具、数据源之间建立统一的通信接口。类似于USB协议统一了硬件设备的连接方式,MCP试图统一AI Agent调用各类工具(代码仓库、数据库、API服务、文件系统等)的方式。协议定义了工具描述、参数传递、权限声明和流式响应等核心规范。
MCP的设计灵感来源于Language Server Protocol(LSP)——微软为VS Code设计的编程语言服务协议。LSP通过标准化IDE与语言分析器之间的通信接口,一举解决了M×N的适配问题(M种IDE × N种语言)。MCP试图在AI Agent领域复制这一成功:将M种AI模型与N种外部工具之间的集成从M×N次定制开发简化为M+N次标准适配。协议核心包括工具描述(JSON Schema定义的输入输出规范)、能力协商(客户端与服务端握手确认支持的功能集)、采样请求(允许服务端反向请求模型进行推理)等机制。
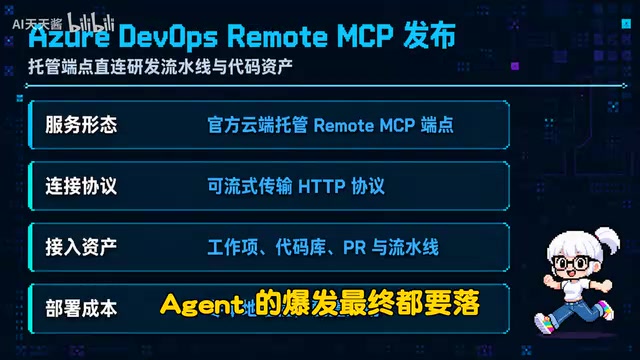
微软此次上线的服务提供了一个标准的云端端点,让AI智能体可以直接通过流式HTTP协议安全读取工作项、代码仓库、拉取PR以及CI/CD流水线,完全免去了开发者在本地安装守护进程的繁琐配置。
不过有一个微妙的兼容性问题:由于微软服务端采用的是MCP协议较新的流式HTTP(Streamable HTTP)传输方式,相比早期基于标准输入输出(stdio)的本地模式,支持云端部署但也带来了客户端兼容性的挑战。正如HTTP/1.1到HTTP/2到HTTP/3的演进过程中出现的兼容性断层,MCP从stdio本地传输到Streamable HTTP远程传输的跃迁也必然经历类似的过渡期阵痛。目前Claude桌面端、Claude Code、GPT系列工具和Cursor暂时还无法直接连接这个远程端点,仅推荐使用原生支持HTTP远程MCP的工具链尝鲜,主流开发环境的全面支持还需等待后续修补。这也侧面反映出MCP生态在标准落地阶段,不同工具对协议版本和传输层的实现进度不一,碎片化问题仍然存在。
硬件底座:英伟达智能体CPU量产交付
Agent的爆发最终都要落地到底层算力上。英伟达今天宣布,其首款专门面向AI智能体架构设计的CPU芯片Vera已正式开启大规模量产交付,首批系统正陆续交付给各大生态合作伙伴。
Vera是英伟达基于ARM架构自研的数据中心CPU,设计目标是与英伟达自家GPU(如Blackwell系列)实现深度协同,构成CPU-GPU异构计算的完整平台。英伟达选择ARM架构并非偶然,这反映了数据中心CPU领域近五年来最重要的架构迁移趋势。2018年AWS推出自研ARM芯片Graviton,率先在云计算领域验证了ARM架构在能效比上的优势——相比同代x86处理器,ARM服务器芯片通常能以40%更低的功耗提供相当甚至更优的性能。随后Ampere Computing、华为鲲鹏等纷纷入局,到2024年ARM架构已占据全球云服务器出货量约15-20%的份额。英伟达作为GPU厂商自研ARM CPU的战略意图在于构建垂直整合的计算平台——通过统一的NVLink/CXL互联架构,实现CPU与GPU之间的超高带宽、低延迟数据传输,避免传统x86 CPU+NVIDIA GPU组合中PCIe总线带宽瓶颈对智能体工作负载的制约。
这一动向传递出一个重要信号:硬件厂商正从单纯追求大模型训练算力,转向为多步推理、环境交互和工具调用的智能体系统做专门优化。另一边,OpenAI与英伟达也宣布扩大深度合作,追加部署约200万颗GPU及下一代基础设施,重点保障Agent和推理智能的高频计算与逻辑路由。
智能体工作负载与传统训练负载有着本质区别——训练负载是高度并行、长时间持续的矩阵运算,对GPU算力的峰值吞吐要求极高;而智能体推理负载则是多步串行决策与并行工具调用的混合模式,每一步推理后可能需要CPU侧进行逻辑路由(决定下一步调用哪个工具)、上下文管理(维护多轮交互的状态)和安全校验(检查操作权限),这些任务对CPU的单线程性能、内存带宽和I/O延迟提出了更高要求。为这类场景专门设计的CPU/GPU协同架构,将直接加速复杂工程智能体的商用落地。
物理世界连接:MHS硬件标准与端侧模型压缩
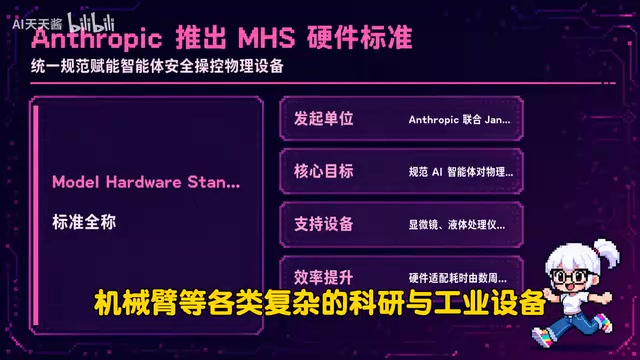
智能体不仅要操控软件,也要触达物理设备。Anthropic联合知名科研机构公布了模型硬件标准(MHS)的研究预览版。这项标准旨在为AI智能体安全接管物理设备提供统一的交互规范,让智能体能够并行调度显微镜、自动化移液机、机械臂等各类复杂的科研与工业设备。
MHS试图解决的核心问题是:物理设备的控制接口高度碎片化。不同厂商的显微镜、移液机、机械臂各自使用专有的通信协议(如SCPI、Modbus、ROS等),甚至同一厂商的不同型号之间接口也可能不兼容。SCPI(Standard Commands for Programmable Instruments,可编程仪器标准命令)是1990年代为电子测量仪器制定的通信标准,至今仍广泛用于示波器、频谱分析仪等设备;Modbus是1979年为工业PLC设计的串行通信协议,在制造业自动化领域占据主导地位;ROS(Robot Operating System,机器人操作系统)则是学术界和机器人行业的事实标准,提供了发布-订阅消息模型和丰富的设备驱动生态。这三类协议分别服务于精密仪器、工业控制和机器人三个不同领域,在数据格式、传输层、错误处理和实时性要求上存在根本差异。此外还有LabVIEW的专有协议、OPC-UA工业互联标准等,整个生态极度割裂。
传统做法是为每台设备编写专用的驱动和控制脚本,这需要工程师同时精通设备协议和业务逻辑。MHS的设计思路是在设备的原生控制协议之上建立一个抽象层,用标准化的语义描述来定义设备的功能、参数范围和安全约束,使AI Agent能够通过统一接口理解并操控不同设备。值得注意的是,与软件API标准化不同,物理设备的操作涉及真实世界的不可逆后果(如机械臂碰撞、试剂误配),因此MHS在安全校验和操作确认机制上的设计远比软件API复杂。
过去搭建一套硬件联动系统,往往需要工程师耗费数周甚至数月编写专用驱动;而在MHS规范下,这一适配周期有望被缩短到几分钟。对于科研实验室和高端制造领域,物理世界与大模型之间的连接门槛正在被真正打通。
在端侧方向,腾讯相关团队展示了极低比特翻译模型的压缩方案,成功将原本3.3GB的模型体积压缩到仅440MB,压缩幅度接近87%。最难得的是,在多语言翻译质量评测中,模型的BLEU分数几乎没有可见退化,实现了近乎无损的压缩。
BLEU(Bilingual Evaluation Understudy)是机器翻译领域最经典的自动化评估指标,通过计算机器翻译结果与人工参考译文之间的n-gram重叠度来量化翻译质量,分数范围0-100,越高越好。腾讯团队采用的「极低比特压缩」属于模型量化(Quantization)技术范畴——将模型权重从常规的16位或32位浮点数压缩到极低的位宽(如2-3比特),从而大幅缩减模型体积和内存占用。
模型量化领域近两年经历了从PTQ(训练后量化)到QAT(量化感知训练)再到GPTQ、AWQ、QuIP等专为大语言模型设计的量化算法的快速演进。传统的均匀量化将所有权重等价对待,但研究表明大模型中存在少量「离群值」权重(outlier weights),其数值远大于其他权重,对模型输出有决定性影响。AWQ(Activation-aware Weight Quantization)等方法通过分析激活分布来识别这些关键权重并给予更高精度保护,从而在极低位宽下维持模型质量。从3.3GB压缩到440MB(约7.5倍压缩比)如果对应原始FP16模型,意味着平均每个参数仅用约2比特表示,这已经接近信息论上的极限区域,需要非常精细的混合精度分配(对敏感层保留较高位宽)、校准数据集优化以及量化感知训练等技术的综合运用才能避免精度崩溃。
这意味着体积更小、功耗更低的端侧设备也能流畅运行高品质的离线实时翻译。对于注重隐私安全、需在无网络环境下工作的出海人员和移动端开发者,这项轻量化技术非常值得关注。
AI编程工具链升级与商业化验证
在编程开发领域,阿里巴巴正式发布全新工具,将其从单一的代码补全辅助工具,全面进化为全流程的智能体工作台。新版本强化了多智能体协同架构,具备全工程代码理解、自动任务拆解以及自动化调试运行能力。
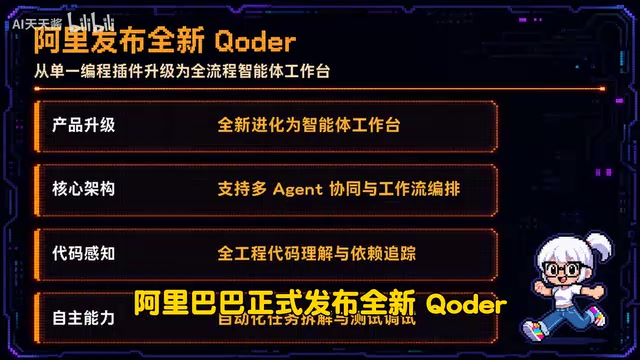
这标志着AI编程正在从「单点代码生成」迈入「全工程自主编排」的阶段。所谓多智能体协同(Multi-Agent Collaboration),是指系统内部并非由单一模型包办所有任务,而是将不同职责分配给多个专门化的Agent,它们通过结构化的消息传递进行协作,各自在擅长的环节发挥作用。这一架构的理论基础可追溯到分布式人工智能(DAI)和多智能体系统(MAS)研究,但在大模型时代获得了全新的实现方式。当前主流的多智能体框架包括微软的AutoGen、LangChain的LangGraph以及CrewAI等,它们的核心设计模式包括:角色专精化——每个Agent被赋予特定的系统提示词和工具集,专注于单一职责;通信拓扑——Agent之间可以采用链式(流水线)、星型(中央调度)、网状(自由协商)等不同的消息传递结构;共享状态管理——通过共享的内存或黑板系统维护全局上下文。
在AI编程场景中,典型的多Agent分工是:Planner Agent负责将用户需求拆解为技术任务,Coder Agent生成代码实现,Reviewer Agent进行代码审查,Tester Agent编写和执行测试用例,Debug Agent分析失败原因并提出修复方案。对于全栈开发者和研发团队而言,AI不再只是补全下一行代码,而是能理解整个工程结构并端到端推进特性开发的协作伙伴。
商业化成绩单:MiniMax营收验证Agent趋势
最后是一份颇具说服力的商业化数据。国内大模型独角兽MiniMax公布了2026年中期业绩:年度经常性收入(ARR)已正式突破8亿美元,其中来自企业和开发者端业务的贡献比例超过80%,同比增速高达703%。同时披露的7月份Token消耗量达到了年初1月份的20倍。
ARR(Annual Recurring Revenue,年度经常性收入)是SaaS和云服务行业衡量商业健康度的核心指标,代表企业在当前时间点上、基于现有订阅合同可预期的未来12个月收入。与一次性收入不同,ARR反映的是可持续、可预测的营收能力,也是投资者评估云服务企业估值的首要参考。MiniMax的ARR突破8亿美元且B端占比超80%,意味着大模型公司正在摆脱早期依赖C端应用(如聊天机器人、AI社交产品)获取用户量但难以变现的困境,转而通过API调用计费、企业级部署订阅等模式建立稳定收入流。703%的同比增速与Token消耗量20倍增长的对照关系也说明,收入增长主要由实际使用量驱动而非单纯涨价,这是更健康的商业化信号——它意味着下游开发者和企业正在将大模型API深度嵌入生产环境的核心业务流程,而不仅仅是试用或实验。
这份数据清晰表明:大模型商业化的重心正快速从C端娱乐产品,转向扎实的开发者开放平台和企业级智能体基础设施。当营收的绝大部分来自B端与开发者,说明整个行业的自我造血能力正迎来关键验证期。
结语
综观这24小时的动态,一条清晰的主线贯穿始终:Agent正在成为AI落地的核心范式。软件层面有Claude内置浏览器和MCP协议标准化,硬件层面有英伟达专属CPU与MHS物理设备标准,成本层面有阿里云降价与端侧模型压缩,商业层面则有MiniMax的营收验证。从算力底座到应用生态,围绕智能体的完整链条正在快速成型。
核心要点
核心要点
相关推荐

AI数字员工系统实测:所谓免费背后的营销套路解析
针对B站流行的「AI超级员工系统」「AI数字员工」推广视频,本文拆解其视频剪辑智能体、DeepSeek脚本助手两大功能模块,揭示其大模型二次封装的技术本质与免费引流背后的营销套路及账号安全风险。

WorkBuddy入门指南:让AI真正替你上班的桌面智能体
WorkBuddy是一款能直接操作本地电脑的桌面AI智能体。本文详解其定位、与CodeX的差异、常见认知误区及文件管理、协同办公等实战能力,帮你从AI提问者进化为AI管理者。

LangGraph入门指南:AI Agent的操作系统全解析
LangGraph 被称为 AI Agent 的操作系统,本文系统梳理其与 LangChain 的关系、状态节点边三大要素、持久化 checkpoint、human-in-the-loop 及子图等核心能力与学习路径。