Cline + VS Code 实战:一句话生成待办事项应用
Cline是VS Code中的自主编码代理,一条提示词即可自动生成、运行并迭代完整应用。
Cline是一款嵌入VS Code的自主编码代理扩展,能够根据自然语言提示自动规划步骤、创建文件、执行命令并通过浏览器验证结果,形成「编码—运行—验证」的完整闭环。它支持Anthropic Claude、Ollama本地模型、Groq及OpenAI兼容接口等多种模型接入方式,并内置费用显示功能帮助用户控制成本。教程实测表明,模型能力是体验差距的核心变量:Claude Sonnet、GPT-4o等高级模型协作顺畅,能准确理解复杂修改意图;而本地小模型和小参数模型虽免费或极速,但在复杂任务上稳定性明显不足。对于追求质量的交付场景,仍需搭配高级模型使用。
Cline 是一款直接在 IDE 中运行的自主编码代理(AI Coding Agent),它能够创建和编辑文件、执行命令、调用浏览器测试应用,而每一步操作都会先征求你的许可。作为 VS Code 的扩展,它把 AI 编程助手的能力直接嵌入到你日常的开发环境里。本文根据 B 站 UP 主的实操教程,梳理从安装配置到用一条提示词生成完整应用的全过程,并对比不同大模型接入 Cline 的实际体验。
Cline 是什么:IDE 里的自主编码代理
Cline 前身叫 CodeDev,是一个安装在 Visual Studio Code 里的扩展。它的核心特征是「自主」——你给出一段自然语言提示,它就能自行规划步骤、创建文件、写入代码、运行命令,甚至打开浏览器验证结果。与传统的代码补全工具不同,Cline 更像一个真正接管键盘的助手。
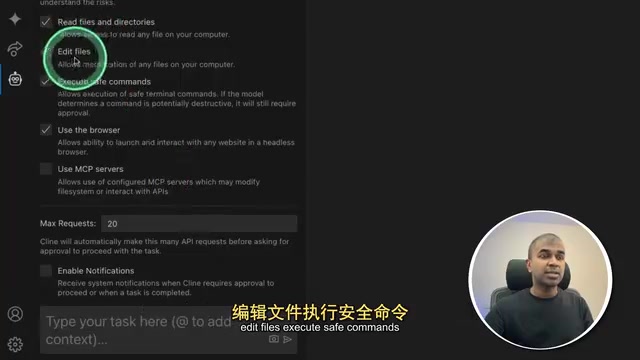
它的安全机制值得关注:默认情况下每一步动作都需要你手动批准。教程中演示者开启了「自动批准」(Auto Approve),允许它读取文件、编辑文件、执行安全命令并使用浏览器测试。对于希望全流程自动化的用户,这个开关能大幅提升效率;但对生产环境或涉及敏感操作时,逐步确认仍是更稳妥的做法。
「自主编码代理」(Agentic Coding)与传统 AI 代码补全的本质区别在于任务执行的完整性。GitHub Copilot 等补全工具以「逐行建议」为核心,仍依赖开发者驱动每一步操作;而代理模式下,AI 能够自行分解目标、规划子任务,并循环执行「感知—决策—行动」的流程直到任务完成。Cline 借助大模型的函数调用(Function Calling)能力,将文件系统读写、终端命令执行、浏览器操控等操作封装成可调用的工具集,使模型能像操作员一样逐步推进工程任务,而不只是给出建议。
安装与模型配置
安装过程相当直接:下载并打开 VS Code,进入扩展(Extensions)选项卡,搜索「Cline」并安装。安装完成后侧边栏会出现 Cline 图标,点击进入设置即可添加模型。
教程首先演示接入 Anthropic 的 Claude:在 API 提供商中选择 Anthropic,填入 API 密钥,再选择想使用的模型即可。Cline 的一个实用细节是它会显示每个请求消耗的费用,让你对 API 调用成本一目了然,避免使用高级模型时产生意料之外的账单。
用一条提示词生成待办事项应用
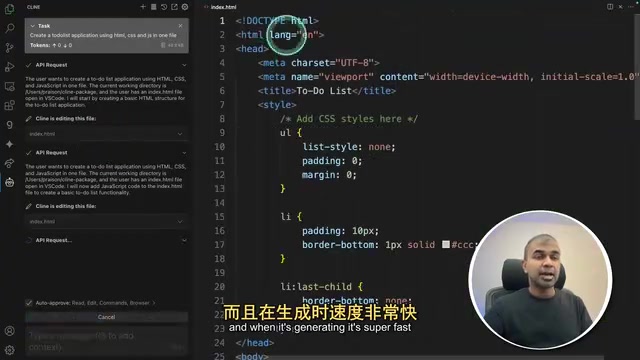
配置完成后,演示者布置了一个简单任务:「用 HTML、CSS 和 JavaScript 创建一个待办事项应用」。Cline 随即开始工作,依次创建 HTML 结构文件、包含样式的 CSS 文件,以及承载交互逻辑的 JavaScript 文件。
最能体现其自主性的环节,是它在生成完毕后主动打开网页应用、检查控制台日志,并根据页面表现验证任务是否真正完成。这意味着它不只是「写完就交差」,而是形成了「编码—运行—验证」的闭环。
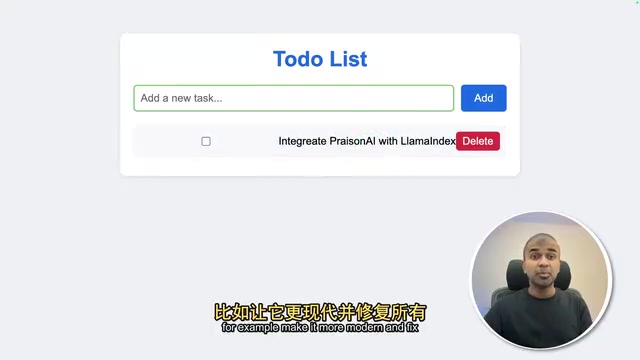
生成的待办应用可以正常添加任务条目。当演示者进一步要求「让这个应用更现代、修复现有问题」时,Cline 会先重新查看页面,再规划出一份分步执行清单,逐行修改 CSS 和 HTML。修改后的应用带上了任务分类等更完善的功能,整个迭代过程同样自动化完成。
接入本地与免费模型:Ollama 与 Groq
除了付费的 Claude,教程还演示了两种降低成本的接入方式。
Ollama 本地模型
从 ollama.com 下载 Ollama 后,运行命令拉取微软的 Phi 系列模型(教程中提到 Phi-4,作为微软顶尖的小模型之一)。回到 Cline 设置,在 API 提供商中选择 Ollama,指定对应模型即可。
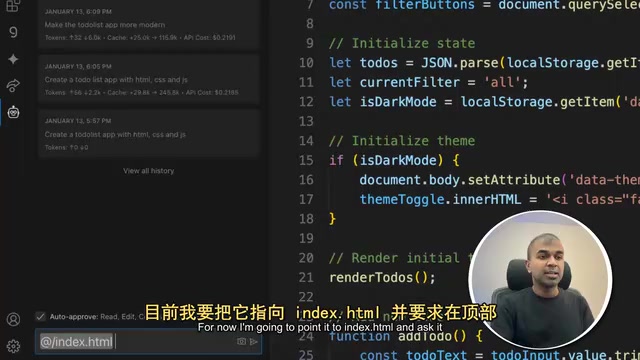
Cline 还支持将上下文指向具体文件、问题或粘贴 URL。演示者把它指向 index.html,要求在顶部添加一个包含 Home、Contact 的导航栏,模型据此完成了修改。不过教程也坦言,Ollama 等本地小模型「有时候不知道该在哪里实现这些修改」,稳定性不及云端高级模型。
Ollama 是一个专为在本地计算机上运行大语言模型而设计的开源工具,支持 macOS、Linux 和 Windows。它将模型权重、运行时和 API 服务器打包在一起,通过简单的命令行(如 ollama run phi4)即可在本机启动一个兼容 OpenAI 接口规范的本地服务,无需任何云端连接。Phi 系列是微软研究院开发的小型高效语言模型,Phi-4 拥有约 140 亿参数,在数学推理和代码任务上表现突出,是本地部署场景下性价比较高的选择。本地运行的优势在于数据隐私完全可控、无 API 调用费用;代价是受限于本地硬件(主要是 GPU 显存),模型规模和响应速度与云端高级模型仍有明显差距。
Groq 超快推理
通过 Groq,可以获得极快的生成速度。配置方式是在 API 提供商中选择「OpenAI Compatible」,填入 Groq 的端点和 API 密钥。教程使用 Llama 3.1 8B Instant 在单文件中生成待办应用,生成速度确实非常快,应用也能正常添加任务。
但当要求它「增添现代感」时,页面变化并不明显。演示者分析原因在于所用的是 80 亿参数的小模型,能力有限。
Groq 的速度优势来源于其自研的 LPU(Language Processing Unit)芯片架构。不同于 GPU 的并行矩阵计算设计,LPU 针对大语言模型的自回归推理过程做了专项优化,能够以极低延迟逐 token 生成文本,在实测中每秒生成速度可达普通 GPU 服务的数倍乃至十倍以上。Groq 目前以 API 方式托管 Llama、Mixtral 等开源模型,并提供免费额度。「OpenAI Compatible」接入方式意味着 Groq 实现了与 OpenAI Chat Completions API 相同的接口规范,任何支持自定义端点的客户端(包括 Cline)无需额外适配即可直接对接,只需替换 base URL 和密钥。
模型选择的关键权衡
教程给出的结论清晰而务实:追求流畅体验,就用 Claude Sonnet 或 OpenAI 的 GPT-4o 这类高级模型;这些模型与 Cline 的协作过程明显更顺畅。
而 Ollama 本地模型和 Groq 上的小参数模型虽然能免费或超快运行,但在理解复杂修改意图、准确定位改动位置方面吃力,协作难度较大。换言之,Cline 的自主能力上限,很大程度上取决于背后接入的模型能力。
对开发者的建议是:简单原型和快速验证可以尝试免费小模型体验流程,但真正要交付有质量的应用,仍需搭配高级模型。这也解释了为什么 Cline 内置的费用显示功能如此重要——它帮助你在成本与效果之间找到平衡。
小结
Cline 把 AI 编程从「补全代码」推进到「自主完成任务」的阶段:一条提示词、自动建文件、自动运行验证、自动迭代优化。它对模型的开放性(Anthropic、Ollama、Groq、OpenAI 兼容接口)让不同预算的用户都能上手。核心体验的差距主要来自模型本身,选对模型是用好这款工具的前提。
相关推荐
16GB显存跑27B大模型:Qwen3与MiniMax H3本地视频生成实测
实测16GB显存跑27B开源大模型:结合Qwen3与MiniMax H3的ComfyUI工作流集合,涵盖文生图、图像编辑与视频生成,8GB显存起步即可本地部署,媲美付费闭源方案。
MiniMax开源视频模型本地部署:8G显存也能跑,速度惊人
MiniMax最新开源AI视频加速模型支持8G显存本地运行,生成速度极快。本文详解ComfyUI本地部署流程、模型文件存放路径、五种工作流选择及文生视频、图生视频实测效果。
秋叶ComfyUI整合包实测:8G显存也能跑AI视频
秋叶ComfyUI中文整合包实测:解压即用、图形化启动器、显存四档自动匹配,8G显存也能跑AI视频。详解显存分档、依赖修复、下载源切换与插件管理等核心功能。