从AI到大模型:零基础理清人工智能技术脉络
从人工智能到大模型的技术演进脉络,及普通人如何入局AI应用开发
本文系统梳理了人工智能、机器学习、深度学习、大模型与生成式AI之间层层递进的发展关系。传统AI依靠人类预设规则(如深蓝的搜索算法),机器学习转为让机器从数据中自主发现规律,深度学习则通过神经网络处理更复杂的感知任务。2017年Google提出的Transformer架构与注意力机制,彻底解决了语言上下文理解难题,成为ChatGPT等现代大模型的共同基础。生成式AI的核心突破在于从"判断分类"走向"从无到有的创造",背后由数据规模、算力跃升和架构突破三重因素驱动。对普通学习者而言,入局AI的现实路径不是重新造模型,而是学会基于现有大模型开发知识库、智能体等实际应用,将AI作为释放人力的高效助手。
很多刚接触AI的人都有类似困惑:人工智能、机器学习、深度学习、大模型、生成式AI这些概念到底是什么关系?有人认为人工智能就是ChatGPT,有人觉得机器学习、深度学习和大模型是几个完全独立的技术。实际上它们之间存在清晰的发展脉络。B站UP主金泽在其大模型入门系列课程中,用通俗的方式梳理了这条技术演进路线。理解这些基础概念,对后续学习大模型应用开发非常重要。
人工智能到底研究什么
人工智能研究的是让计算机或机器具备类似人类的学习、理解、推理和行动能力。这里有两个关键词:一个是「机器」,人工智能研究的对象不是人类本身,而是计算机程序、软件系统或机器人;另一个是「智能」。
如果按科幻电影的标准,机器要拥有自主意识、能像人一样思考甚至超越人类智慧,那目前技术确实还达不到。但换一个更实际的角度看,只要机器能完成过去需要人类完成的任务,就可以认为它具备一定程度的智能。手机里的智能助手能理解语音指令,地图软件能根据需求规划路线,这些都属于人工智能应用。
人工智能并不是某个具体产品或软件,而是一整个技术领域,涉及计算机科学、数学、统计学、语言学甚至神经科学等多个方向。不同人对AI看法差异巨大,核心原因在于每个人对「智能」的期待标准不一样。从工程和实际工作视角看,更应该关注的是:AI能不能帮我解决真实问题。
从深蓝到AlphaGo:传统AI的规则时代
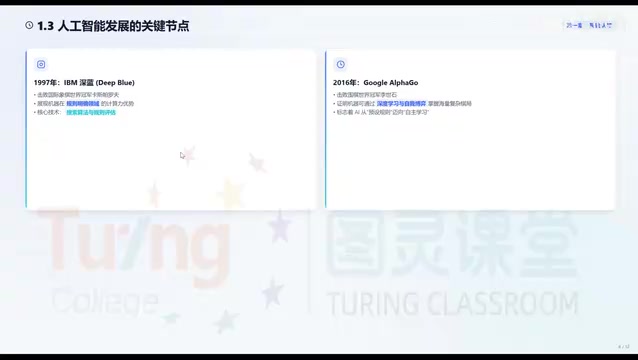
AI发展有两个标志性节点。1997年IBM深蓝击败国际象棋世界冠军卡斯帕罗夫,2016年AlphaGo击败围棋世界冠军李世石。
深蓝的意义在于证明了:在规则明确的领域,机器可以通过强大的计算超越人类。但它的实现方式与今天的大模型完全不同——主要依靠搜索算法。简单理解,就是计算机提前分析大量可能出现的走法,然后通过预设的评估规则选择胜率更高的一步。
这种方式之所以能解决国际象棋,是因为棋子怎么走、每步有什么影响,这些规则都可以被程序提前定义。传统AI的核心逻辑是:人类先把规则告诉机器,机器再按规则计算。但现实世界的问题越来越复杂,很多任务(比如写文章、分析复杂信息)根本无法通过简单规则逐一解决,这就推动了AI进入新阶段。
机器学习:让机器从数据中自己找规律
判断一张图片是不是猫、判断一篇文章的情绪,这些任务很难靠人提前写好规则完成。机器学习的思路是:不再告诉机器所有答案,而是让它通过大量数据自己找到隐藏规律。
机器学习有三种经典方式:
监督学习
给机器提供标准答案,这是最常见的方式。就像学生学数学,先看例题和解答,再面对新题。训练识别猫狗时,给每张图片打上标签(图片A是猫、图片B是狗),机器不断学习图片与标签的关系,最终能对新图片做出正确预测。垃圾邮件识别、金融风控系统都在用监督学习。
非监督学习
数据没有标注,也没有答案,让机器自己寻找规律。比如有大量用户数据(年龄、浏览习惯、购买记录),不预设分类,让模型自己分析哪些用户行为相近。大模型训练中也大量使用类似思想:给模型海量文本,不直接告诉它含义,而是让它根据上下文预测缺失内容,逐渐学会语言规律。
强化学习
核心是通过试错和反馈机制调整行为,类似小朋友学走路——摔倒就调整,成功就获得正向反馈。ChatGPT完成基础训练后,还需要进一步优化回答质量,这就用到了RLHF(基于人类反馈的强化学习)。简单说,就是让模型不仅知道答案,还要知道怎样更好地回答。
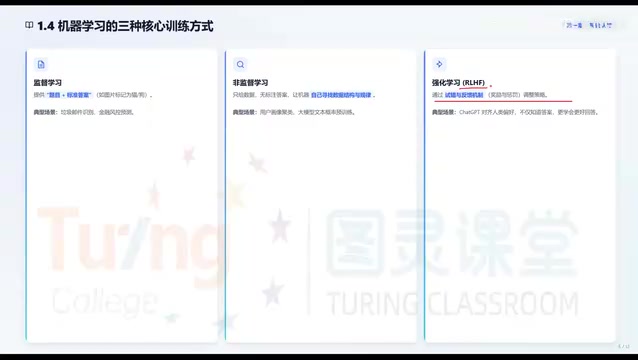
RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)是连接机器学习理论与ChatGPT实际表现的关键一环。其流程大致分三步:首先用监督学习让模型学会基本的问答能力;然后收集人类标注者对模型多个回答的偏好排序,训练一个"奖励模型"来模拟人类评判标准;最后用强化学习(PPO算法)微调语言模型,使其输出尽量获得高奖励分数。这一过程让模型不仅"知道答案",还能学会更符合人类期望的表达方式——更安全、更有帮助、更诚实。RLHF也是OpenAI在InstructGPT论文(2022年)中系统阐述的核心技术,是ChatGPT相比早期GPT-3在实用性上大幅跃升的主要原因。
深度学习与Transformer:大模型的技术基石
随着任务越来越复杂(图片识别、语音理解、自然语言处理),传统机器学习遇到瓶颈,深度学习作为重要分支登场,其核心技术是神经网络。
神经网络受人脑神经连接方式启发,把大量计算节点连接起来,信息经过多层处理。以图片识别为例:第一层学习边缘和颜色,第二层学习形状结构,第三层学习物体组成。这里的「深」指网络层数,层数越多,模型学到的信息层次越丰富。深度学习早期面临信息在多层传递中损失的问题,残差连接等优化方法让信息可以跨层直接传递,成为现代深度学习模型的重要基础。
2017年,Google的八位研究者发表论文《Attention is All You Need》,提出Transformer架构。人类语言的难点在于:同一个词在不同上下文中含义不同。比如「这个项目太难了」,可能指技术复杂,也可能指推进困难,甚至只是表达情绪。机器如果不能理解上下文,就无法真正理解语言。
Transformer通过注意力机制解决了这个问题。当输入「苹果发布了一款新手机,它受到了很多用户的欢迎」时,模型能识别出「它」指的是这款新手机。更重要的是,注意力机制让模型能同时分析文本的多个部分,从而处理海量、更长、更复杂的文本数据。这正是ChatGPT、Claude以及国产大模型的共同架构基础。
注意力机制(Attention Mechanism)的直觉理解可以用阅读来类比:人在读一段话时,会对关键词分配更多注意力,而不是平均对待每个字。Transformer的自注意力机制(Self-Attention)做的事情类似——对序列中的每个词,计算它与其他所有词的相关性权重,再加权聚合信息。这样一来,无论两个相关词在句子中距离多远,模型都能直接建立联系,不再依赖逐步传递的循环结构(RNN/LSTM)。正是这种并行计算的特性,使得Transformer可以高效利用GPU同时处理大量数据,为后来超大规模预训练模型(如GPT、BERT)的出现奠定了工程基础。残差连接(Residual Connection)则来自2015年微软研究院提出的ResNet,核心思路是让每一层的输出等于"该层学到的变化"加上"原始输入",从而缓解深层网络中梯度消失的问题,让信息和梯度能顺畅地在几十乃至上百层之间流动。
生成式AI:从判断走向创造
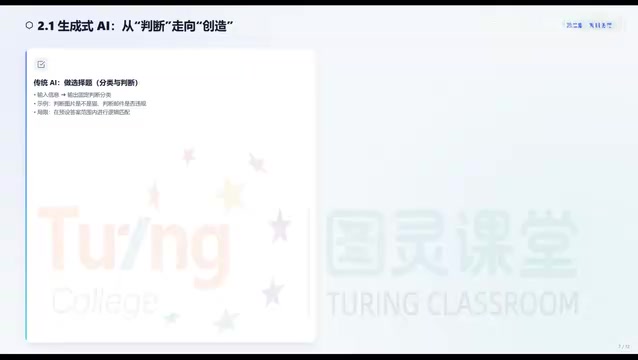
回顾人工智能的发展路线:规则→机器学习→深度学习→Transformer,会发现一个明显变化。过去的AI更多是在做分类与判断(判断垃圾邮件、判断图片是否是猫),而生成式AI最大的变化是具备了「从无到有」的创造能力。
以前AI回答的是「这个东西是什么」,现在大模型可以根据需求「创造一个新东西」——生成文章、代码、图片等。ChatGPT 3.5的爆发背后有三个关键因素:数据规模的积累、算力的跃升(GPU集群、训练方法优化)以及架构的突破(即2017年的Transformer论文)。模型能力实现了从量变到质变的突破。
普通人该如何入局大模型
对于普通学习者,需要深入研究大模型底层吗?这要分情况。如果目标是成为AI基础研究人员、开发新的模型架构,那需要深入学习数学、统计学、深度学习算法等,门槛很高。但如果只是想进入AI应用领域,重点不是重新创造大模型,而是学会如何站在现有大模型基础上开发实际应用。
就像汽车发明之后,绝大多数人不需要研究发动机原理,而是学习如何驾驶汽车来提升效率。
主流大模型可以简单了解:OpenAI的GPT系列影响力最大,覆盖文本生成、代码辅助、知识问答等场景;Claude更注重长文本分析和逻辑推理,写代码的同学尤其喜欢;Google的Gemini是多模态模型,能处理文字、图片、声音、视频。国内则有阿里通义千问广告(开源)、百度文心系列以及DeepSeek广告等。
选择大模型不在于绝对好坏,而取决于任务是什么、使用环境如何。企业场景还要考虑数据安全、是否支持私有部署、成本是否可控、是否方便接入现有系统。
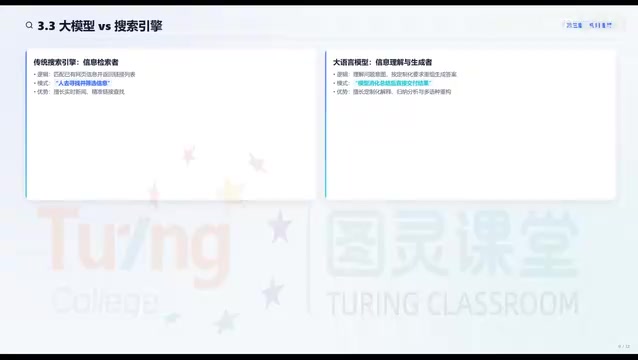
大模型目前最适合的定位并不是完全替代岗位,而是作为高效助手,帮我们完成大量重复性工作,把人的精力释放出来去做目标设计、决策判断和创造性工作。对普通人来说,更现实的路径是立足现有大模型的通用能力,结合具体业务场景,比如搭建企业内部知识库、开发智能体(Agent)来替代重复性工作。
未来的发展方向也逐渐清晰:模型能力持续增强(推理、代码、多模态);越来越贴近行业细分(金融、法律、医疗领域的专业大模型);以及Agent成为重要应用形式。Agent不仅能回答问题,还能理解目标、制定计划、调用工具执行任务,形成智能化闭环。比如让它分析公司销售情况,它可以自动读取数据、分析趋势、生成报告并提出建议——这正是智能体的发展方向。
智能体(Agent)的核心架构通常包含四个模块:感知(接收用户输入或外部数据)、规划(将目标拆解为子任务,常借助大模型的推理能力)、记忆(短期的对话上下文与长期的知识存储)以及行动(调用外部工具,如搜索引擎、数据库、代码执行环境、API接口等)。目前主流的Agent框架有LangChain、AutoGen、CrewAI等,它们封装了工具调用、多步推理和多智能体协作的常见模式,让开发者无需从零搭建整套流程。企业知识库(RAG,检索增强生成)则是另一个高频落地场景:将公司内部文档向量化存储,用户提问时先检索相关片段再喂给大模型生成答案,既能利用大模型的语言能力,又能保证回答基于真实的私有数据,有效减少"幻觉"问题。
相关推荐

M&M's斥资数百万换掉人工蓝色素,为什么这么难?
玛氏公司投入数百万美元,试图用螺旋藻天然色素替代M&M豆中的人工蓝色素,却因物料浓稠堵塞管道、残留物引发霉菌风险而被迫改造整条产线。本文解析这场配方迁移背后的工程难题、消费者与监管推力,以及"无人工色素不等于健康"的清醒判断。

Meta全球AI开发者黑客松组队需求:计算机视觉与医疗AI方向
Reddit开发者发帖为Meta Global AI Developer Hackathon招募队友,方向聚焦计算机视觉与医疗AI。本文分析这一组队信号背后的赛道逻辑、技能互补需求与黑客松选题策略。

Claude 多个模型报错:Fable 5.1、Sonnet 5.5、Haiku 5.5 故障复盘
Claude Fable 5.1、Sonnet 5.5、Haiku 5.5 及 Opus 5.5 fast mode 出现错误率升高,官方 17 分钟内完成定位与恢复。本文梳理故障时间线、多模型连带故障的技术原因,以及对开发者重试与降级策略的实际启示。