AI Agent入门:用团队协作理解智能体的感知、决策与行动

什么是AI Agent?一个更贴切的翻译是「代理」
谈到AI Agent,很多初学者会被这个术语绕晕。业界通常有两种称呼:一种叫「智能体」,另一种叫「代理」。相比之下,把它理解为「代理」其实更直观——它就像一个能够替你处理特定任务的委托人,具备理解、思考和执行的能力。
背景知识:AI Agent的起源 AI Agent(人工智能代理)的概念最早可追溯至1990年代的多智能体系统(Multi-Agent Systems, MAS)研究领域。早期的Agent理论由计算机科学家Minski、McCarthy等人奠基,核心思想是将复杂任务分解给具备自主性(Autonomy)、反应性(Reactivity)、主动性(Proactivity)和社交能力(Social Ability)的独立单元。进入大语言模型(LLM)时代后,AI Agent获得了质的飞跃——以GPT-4、Claude等为代表的基础模型赋予了Agent真正意义上的自然语言理解与推理能力,使其从规则驱动的脚本进化为可以处理开放性任务的智能系统。
要真正理解AI Agent的价值,不妨从一个大家都熟悉的场景切入:创业公司的组织演化。
从「一人全栈」到「团队分工」的类比
假设你在一家创业公司,起步阶段只有你一个开发。前端、后端、测试、设计,所有的活儿都得你一个人扛。这个阶段的你,本质上就是一个「全能Agent」——独立完成从需求到交付的全流程。
但随着业务增长,用户量从几千涨到几万,需求爆发式增加,一个人显然忙不过来。于是公司开始招人,问题也随之而来:分工。
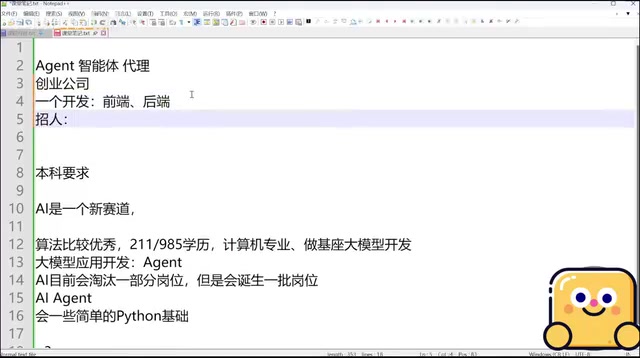
原本一个人干的活,现在要拆分给不同角色——前端、后端、设计、测试。这些角色之间,必须具备两个前提才能高效运作:一是清晰的角色定义,二是协作沟通的语言。人与人之间靠自然语言沟通,而AI Agent恰好也能理解自然语义,并且具备规划与决策能力,这与人类的工作方式高度相似。
延伸:多Agent协作框架 多Agent协作(Multi-Agent Collaboration)是当前AI工程领域最活跃的方向之一。以LangChain、AutoGen、CrewAI为代表的开源框架,提供了Agent编排、工具调用(Tool Use)、记忆管理(Memory Management)等核心能力。在典型的多Agent系统中,会存在「编排者Agent」(Orchestrator)负责任务分解与调度,以及多个「执行者Agent」(Executor)各自承接子任务。Agent之间通过结构化消息传递(通常是JSON格式)进行通信,并借助函数调用(Function Calling)或工具调用(Tool Calling)接口与外部系统交互,如数据库查询、API请求、代码执行等。
AI Agent的三大核心能力
把AI Agent拆解开来,其工作机制对应人类协作中的三个关键环节:感知、决策、行动。理解了这三点,也就抓住了智能体的本质。
底层范式:ReAct循环 AI Agent的决策循环通常遵循「ReAct」范式——即推理(Reasoning)与行动(Acting)的交替迭代。这一范式由Google Research在2022年正式提出,核心思路是让模型在每一步行动前先输出「思考过程」(Chain-of-Thought),再基于该思考选择工具或生成响应,最后将执行结果作为新的观察(Observation)反馈给模型,形成闭环。这种「思考-行动-观察」的循环机制,使Agent能够处理需要多步推理的复杂任务,并在出错时自我纠正,而不是像传统脚本那样线性执行固定指令。「感知、决策、行动」三大能力,正是ReAct范式在工程实践中的直观映射。
感知:明确自我定位与环境认知
感知能力是Agent运作的起点。就像一名开发者上岗时,首先要搞清楚「我是谁」——我负责前端还是后端?职责边界在哪里?
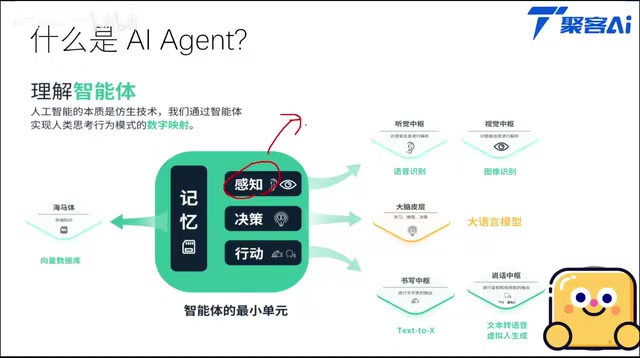
除了自我定位,Agent还需要感知当前所处的环境上下文。比如项目是否处于紧急冲刺期、团队要在三天内交付版本,这些环境信息都会影响后续的判断。对自身角色与外部环境的双重认知,构成了Agent的「感知层」,也是它区别于普通脚本工具的关键所在。
在技术实现层面,感知层通常由**系统提示词(System Prompt)和上下文窗口(Context Window)**共同构成。系统提示词用于注入角色定义与行为约束,而上下文窗口则承载对话历史、工具返回结果和外部文档等动态信息。现代主流大模型的上下文窗口已从早期的4K token扩展至128K甚至更长,这直接决定了Agent能「感知」多少环境信息。
决策:调用大模型进行智能判断
感知之后是决策。以真实开发场景为例:前后端联调时要通过API接口对接,与产品经理沟通时需要先阅读需求文档,拿到资料后还要判断这个需求是否合理。
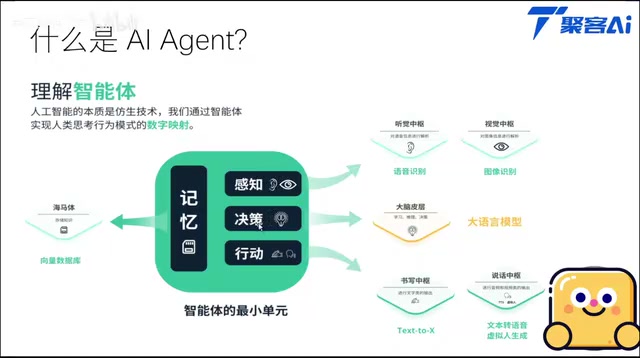
业界有个经典段子——「手机壳根据环境自动变色」,这类需求听起来炫酷,实则难以落地。有经验的开发者能一眼识别问题,并向产品经理反馈「这个做不了」。这种识别需求合理性、判断可行性的能力,就是决策。
AI Agent的决策依赖调用大模型来实现。当前主流大模型采用预训练机制,已学习了海量人类知识与语料。当Agent把需求以自然语言发送给大模型(例如「请分析这个需求是否合理」),大模型能理解语义并给出判断。
预训练机制详解 现代大语言模型采用的预训练(Pre-training)机制是理解AI Agent决策能力的关键。以GPT系列和Claude为代表的模型,通常在数千亿至数万亿token的文本语料上进行自监督学习,通过预测下一个词(Next Token Prediction)来内化人类知识。训练完成后,模型会经历RLHF(基于人类反馈的强化学习,Reinforcement Learning from Human Feedback)微调阶段,使其输出更符合人类意图与价值观。这一机制赋予了大模型强大的语义理解、逻辑推理和知识迁移能力,使其能够作为Agent的「大脑」——接收自然语言指令,输出结构化决策或可执行代码。
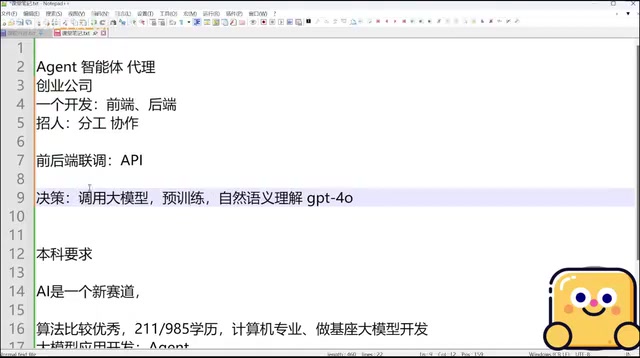
更进一步,像GPT-4o这类模型甚至能识别情感倾向——判断一段文本是正向、负向还是中立情绪。正是借助大模型的语义理解与推理能力,Agent才得以完成复杂的智能决策。
行动:从生成代码到自动化测试
决策完成后,就进入行动阶段。对于开发角色而言,行动意味着写代码;对于设计角色,则是产出UI/UX方案。落到Agent身上,行动就是驱动AI执行具体任务——自动生成代码、运行自动化测试等。
这套理念已在众多产品中落地。Cursor、GitHub Copilot 等AI编程工具,背后正是基于Agent原理构建的。它们理解开发者意图、生成代码并辅助测试,本质上是把人类开发协作的流程用AI重新实现了一遍。
Cursor与GitHub Copilot的架构差异 尽管Cursor和GitHub Copilot同属AI编程工具,其底层架构存在显著差异。GitHub Copilot早期主要基于代码补全(Code Completion)模式,依托OpenAI Codex模型在光标位置预测下文代码,属于较为被动的「感知-行动」两段式Agent。而Cursor则引入了更完整的Agentic Loop——用户可以用自然语言描述需求,Cursor会自动读取项目上下文、规划修改范围、跨文件执行编辑并运行终端命令验证结果,更接近「感知-决策-行动」的完整三段式Agent架构。这一差异也体现了AI编程工具从「代码补全助手」向「自主编程代理」进化的行业趋势。
理解AI Agent的最佳心法:把它当成人类协作
回顾整个逻辑,理解AI Agent最有效的方式,就是把它类比为人类团队的协作过程:
- 单Agent 对应「一人全栈」——独立完成所有任务;
- 多Agent协作 对应「团队分工」——不同角色各司其职、相互配合;
- 感知、决策、行动 对应人类工作中的「认知定位、思考判断、动手执行」。
当你把这些抽象概念映射到日常工作场景,AI Agent就不再是玄乎的技术黑盒,而是一套清晰可拆解的系统。对于想从零构建企业级AI Agent的开发者来说,先建立这样的心智模型,比急于上手框架和代码更为重要。
只有真正理解了AI Agent「为什么这样设计」,才能在实际项目中做出合理的架构选择,让智能体真正像一支高效团队那样协同工作。
核心要点
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。