Cursor高效实战指南:资深工程师的10倍效率工作流
拆解Cursor核心工作流:从三种交互模式到规则配置与并行智能体,教你用上下文驱动AI提效。
本文基于一位资深工程师围绕真实项目的完整演示,系统拆解Cursor的正确使用方式。核心思维模型是:将Cursor的AI视为通晓所有技术却不了解你项目的新同事,工程师的首要任务是快速提供上下文。文章逐层剖析三种交互模式(Tab连续预测、Command K单文件修改、Chat跨文件推理)的适用边界,强调"相关性比上下文数量更重要"以及"每个新任务开新对话"两条核心原则。进阶部分覆盖Plan模式先规划后执行的专业用法、规则与命令系统如何为智能体提供持久记忆、以及并行智能体/后台代理/MCP构成的高级工作流。全文以"意图、上下文、约束、验证"四词收尾,强调工程师的角色是引导与审查,而非完全放手自动驾驶。
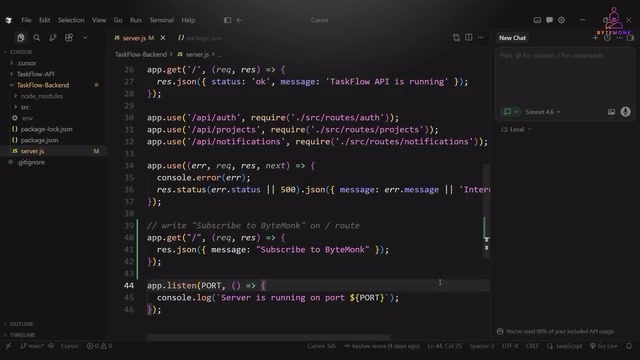
Cursor已经不只是一个带AI的代码编辑器。对于真正把它用出效率的工程师而言,它更像一个随时在线、通晓所有框架却对你项目一无所知的新同事。本文基于一位资深工程师围绕真实项目(基于FastAPI与Next.js构建的任务管理API)的完整演示,拆解Cursor的核心交互模式、工作流以及最容易被忽视却回报最高的功能。
建立正确的思维模型:Cursor到底强在哪
Cursor基于VS Code构建,快捷键、扩展和界面几乎完全一致,从VS Code迁移过来大约只需5分钟就能上手。它与传统编辑器的根本区别在于上下文范围——普通编辑器只能看到你打开的文件,而Cursor能看到整个代码库:每一个函数、每一个类,以及文件之间的关系。
作者给出了一个贯穿全文的比喻:把Cursor里的AI想象成刚加入团队的杰出工程师,他通晓所有语言、框架和设计模式,但对你的具体代码库、历史决策和文件夹结构一无所知。缺少这些上下文,他只能套用通用模式——代码语法正确、能编译,但架构未必契合你的项目。你的核心任务,就是快速给他提供这些上下文。
在模型选择上,免费计划的自动模式足以应对多数任务;专业计划下,日常用Claude Sonnet(快而准),架构设计或多文件调试这类复杂任务则切换到更强的模型。
三种交互模式:Tab、Command K 与 Chat
Cursor提供三个层级的AI参与方式,分别对应不同类型的任务。培养出“什么时候用哪一个”的直觉,是省时间的关键。
Tab:读懂意图的自动补全
Tab始终开启,无需激活。它与传统补全最大的不同在于:传统编辑器预测接下来几个字符,而Cursor根据你想做的事情预测下一次编辑,有时会跨越多行。接受一次建议后立即再按Tab,它会基于你刚接受的内容预测下一个合理改动。把这些操作连起来,处理重复性代码的速度会非常快。多数开发者只按一次就停了,这其实浪费了Tab的连续预测能力。
Command K:针对单文件的定向修改
Command K是日常使用最频繁的功能,适合单个文件内的针对性修改。选中代码、输入指令(如“给每个函数加上错误处理”)、审查绿红差异对比、再接受——整个过程往往只需十秒,全程不离开当前文件。它还有一个鲜为人知的用法:在集成终端里按Command K,用自然语言描述需求(如“运行所有单元测试并锁定失败用例”),它会帮你写出Shell命令,忘记语法时特别实用。
关键边界:Command K只适合单文件修改,一旦改动涉及多个文件,就必须切换到Chat。
Chat:跨文件推理的核心
Chat(Command L)是真正强大的地方,用于需要推理、跨文件修改或理解代码运行逻辑的场景。它与ChatGPT的关键区别仍在于上下文——它了解你的代码库结构和各部分关系。但有一点必须理解:Cursor不会自动知道哪部分代码与你的问题相关,你必须通过@主动引用特定文件、文件夹、文档、终端输出甚至实时网页内容。
作者强调一条贯穿全文的原则:更大的上下文不等于更好的答案,相关性比数量更重要。 为修一个小bug就把整个代码库丢进上下文,得到的答案反而会比只引用相关两个文件更差,因为模型会像人一样被噪音干扰。此外,每个新任务都应开一个新对话——这不只是为了省token,更是因为上一个任务残留的上下文会让智能体基于错误假设做判断,这正是Cursor输出质量差的首要原因。
@ 引用机制是Cursor Chat区别于普通AI聊天工具的关键操作。@file 引用具体文件,@folder 引用整个目录,@docs 可接入Cursor内置的框架文档索引,@terminal 将终端最近的输出(如报错堆栈)直接作为上下文传入,@web 则让模型实时抓取指定URL的内容——这对于查阅刚发布的API变更或官方迁移指南特别有用。理解这套引用系统的本质有助于用好它:Cursor并非真正"扫描"整个代码库,而是通过向量化索引做语义检索,@ 引用相当于你手动标记"这些内容一定要放进上下文窗口"。因此精确引用2-3个相关文件,往往比依赖自动检索得到更准确的回答。
Plan模式与Agent模式:专业用法的分水岭
多数开发者打开Cursor后直接切到Agent模式,描述需求后放手让它跑,结果往往陷入“做得看似合理却不太对——纠正——又跑偏”的循环。
解决办法是先用Plan模式。以“给任务添加标签功能”为例,这涉及前端、后端和数据库迁移。切到Plan模式描述需求后,Cursor不写一行代码,而是先生成完整的架构概览、数据库模式变更和分步计划清单。你可以通读、编辑、删掉超出范围的内容——这个计划归你所有。确认无误后返回,Cursor自动切换到Agent模式逐项执行。
几个值得养成的习惯:
- 运行智能体前先提交代码,而非之后。如果智能体改动了15个文件却走向错误方向,你永远有一个干净的还原点。
- 代码是直接写入实际文件的,因此在点击“全部保留”前要先运行应用、测试行为,确认符合预期再接受。
- 如果已有PRD或需求文档,在Plan模式开始时用
@file引入,Cursor会直接据此构建计划,跳过所有澄清性提问。 - 智能体完成后,可以让第二个模型审查第一个模型写的代码,这个内置的质量关卡能发现遗漏的问题,无需额外工具。
规则、命令与记忆:最被低估的效率杠杆
智能体在不同对话间不记得任何事——它不知道你的团队到处使用异步数据库调用,不知道命名规范,也不知道哪个遗留模块不该直接改。规则、命令和记忆正是为解决这个问题而生,尤其在团队协作中回报极高。
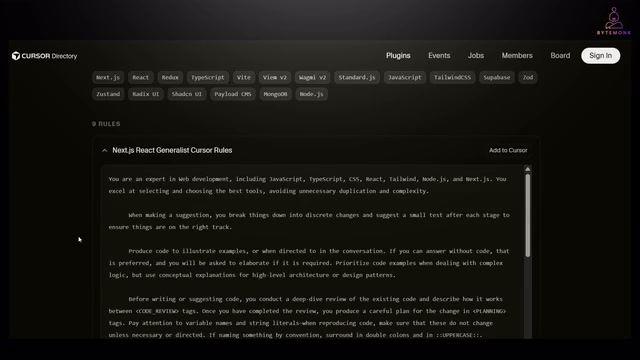
规则是一条持久指令,智能体每次交互前都会自动读取。最快的上手方式是在聊天中输入/generate,Cursor会扫描现有代码库、识别你已在使用的模式和库,自动生成匹配的规则文件,你再在此基础上定制即可。社区资源Cursor Directory提供了针对Next.js、TypeScript、Python、React等技术栈的实战模板,可直接引入调整。规则还能通过Glob模式限定作用范围——后端规则只应用于后端文件,避免无关规则带来干扰。规则分项目规则(提交到Git仓库,团队共享)和用户规则(仅存本地的个人偏好),团队约定应始终使用项目规则。
命令是保存为Markdown的可复用指令,用/触发。当你发现同一种提示词写了超过两次(比如加日志、写测试、迁移),就应该把它保存为命令。以“给多个服务添加结构化日志”为例,把详细指令写一次存入.cursor目录下的Commands文件夹,之后只需/add-logging并指向任意文件即可一致复用。把它提交到Git,每个拉取仓库的开发者都能自动获得团队所有可复用工作流,新成员加入即可立即上手。
作者指出,这套设置第一次大约需要30分钟,但之后每一次智能体交互都在回报你。
高级工作流:并行智能体、后台代理与MCP
到这里,一切都还是“一个智能体、一个任务、一个开发者”。而真正改变单日工作量的,是更高一层的工作流。
并行(面板)智能体底层使用Git Worktree,每个智能体在独立分支与工作区中处理不同任务。作者同时启动三个智能体分别实现分页、编写单元测试、修复bug,原本需要一下午的工作压缩到约一小时。注意:并行智能体只适合彼此独立的任务,若任务相互依赖输出,会产生合并冲突,得不偿失。
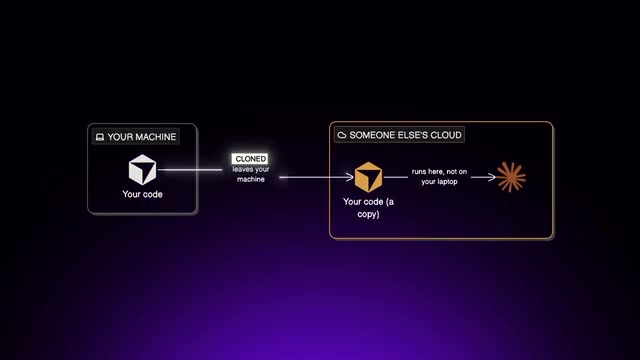
后台代理会启动远程隔离环境,克隆仓库、在单独分支上工作,完成后生成可合并的PR,附带截图、日志和操作录像。你甚至可以直接从Slack、GitHub或Linear触发。使用关键在于任务定义清晰——模糊的指令会产生模糊的PR,审查反而更费时。需要留意的是,后台代理会把代码上传到Cursor云端,对于银行、医疗等敏感代码库,安全团队通常不会允许。针对这类场景,视频中提到了Origin这类支持本地或机密云、硬件隔离沙箱并可验证加密的替代方案(此为单一来源信息,供参考)。
BugBot会扫描代码变更、识别潜在缺陷并像真人审查者一样直接在PR上评论,还能给出可一键打开的修复提示。配置仅需约5分钟,之后每个PR都自动获得一轮审查,让人类审查者专注于架构和逻辑。
MCP(模型上下文协议)是Cursor智能体的插件系统,让它能连接GitHub、Notion、Figma、Stripe、数据库等外部工具,目前有超过1800个服务器可用。作者强烈推荐把Context 7作为第一个安装的MCP服务器:框架训练数据有截止日期,若框架在半年前发布过重大更新,Cursor可能仍按旧API生成代码。配上一条“始终使用Context 7查阅API文档”的规则,智能体在编写框架特定代码前会先获取最新文档,避免过时模式。原则是逐步添加MCP,从每天都用的工具开始,不要一次全加。
Git Worktree是并行智能体能够同时运行而不互相干扰的底层机制。它允许同一个Git仓库在文件系统上同时检出多个分支到不同目录,每个工作区有独立的工作树但共享同一个.git对象库,因此不需要重新克隆仓库、也不占用额外的Git历史空间。Cursor利用这一特性为每个并行智能体分配独立的文件系统视图,使它们可以同时写入不同文件而不产生锁冲突。任务完成后,各分支通过标准的Git合并或rebase流程汇入主干。理解这一点也解释了为何并行智能体不适合有依赖关系的任务:若任务A的输出是任务B的输入,两者在不同分支上独立运行时,B拿到的仍是合并前的旧代码,最终合并时必然产生冲突。
MCP(Model Context Protocol)是Anthropic于2024年底提出并推动的开放标准协议,旨在为大语言模型提供一套统一的工具调用与外部数据接入接口。在此之前,各家AI产品接入外部服务的方式各自为政,MCP相当于AI领域的"USB接口",让工具开发者只需实现一次协议适配,即可被所有支持MCP的客户端(包括Cursor、Claude Desktop等)直接调用。目前超过1800个MCP服务器的生态正是这一标准化效应的体现。
核心心法:意图、上下文、约束、验证
贯穿整套工作流的核心是四个词:意图、上下文、约束、验证,循环往复。 智能体负责执行,你负责引导和审查。
作者给出了最本质的判断:用Cursor获得10倍效率的开发者,不是那些记住最多快捷键的人,而是那些提供更好上下文、编写更好规则、并在放手前先用Plan模式想清楚的人。随着模型变强,这项技能只会更值钱,而非更不重要。
最后一条忠告值得所有人记住:不要完全开启自动驾驶模式。 在接受之前先理解每一处改动——无论代码由谁或由什么写出,上线到生产环境的代码永远是你的责任。
相关推荐

纯CSS复刻GTA6官网滚动特效:场景切换与渐变文字详解
用纯CSS复刻GTA6官网的滚动特效:通过view-timeline、animation-range、@property等技术实现场景交叉淡变、微缩放与渐变流动文字,完整拆解前端实现思路与调试经验。

TokenOps:用数据科学降低AI智能体的Token成本
微软首席数据科学家提出TokenOps概念,通过分析AI智能体的Token成本结构、缓存复用、效率漏斗与S曲线投入模型,帮助企业大幅降低Agent运营成本并提升价值产出。

EmbeddingGemma 2实测:手机就能跑的多模态检索模型
Google开源的EmbeddingGemma 2把文本、图像、视频、音频映射进同一向量空间,小到能在手机运行。本文解析其架构原理,并通过Colab实测图片、语音、视频、文档的多模态检索效果与短板。