D3D:解耦扩散起草,异步投机解码提速5.71倍

D3D 解除扩散起草器对目标隐状态的依赖,实现异步投机解码,最高加速 7.48 倍。
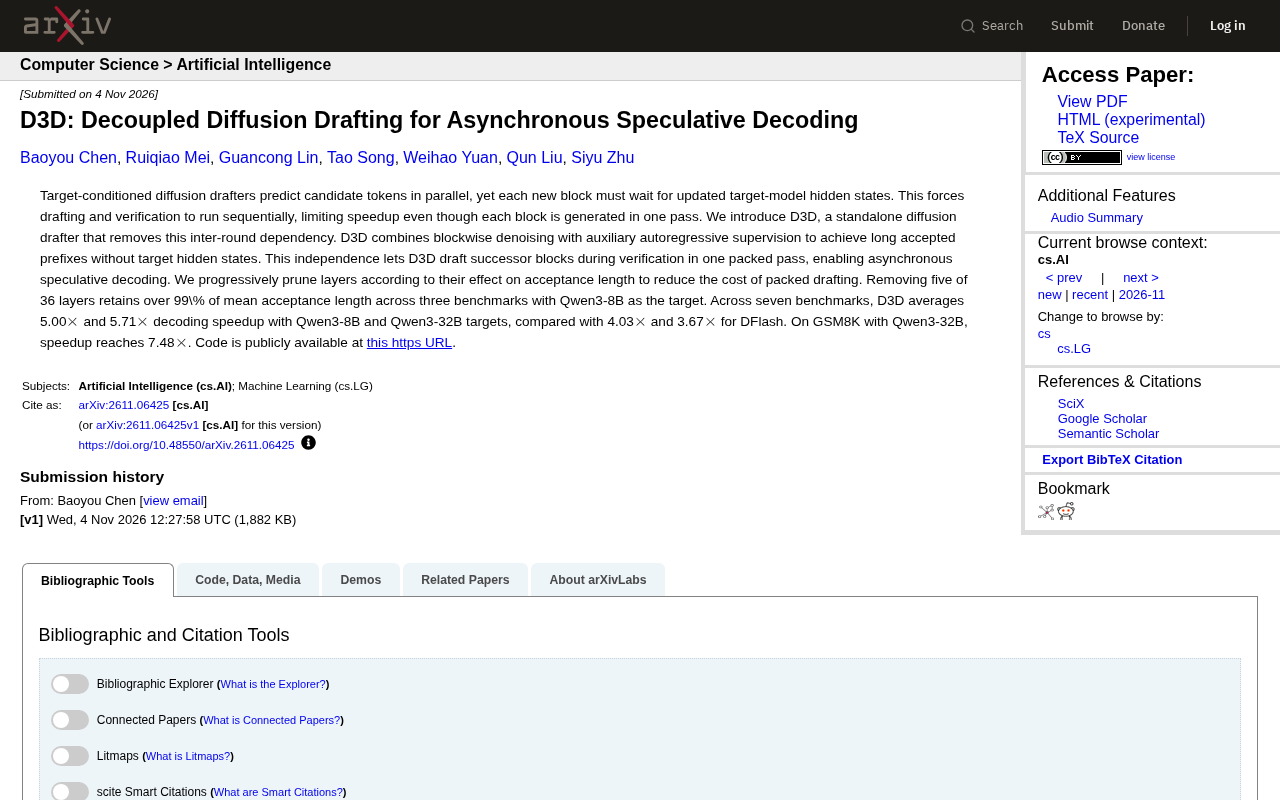
复旦大学生成视觉团队提出 D3D,针对扩散投机解码中长期存在的串行瓶颈:起草模型必须等待目标模型回传隐状态,导致起草与验证无法重叠。D3D 通过块级去噪保留并行生成整块候选的能力,并以辅助自回归监督补偿失去目标隐状态后的起草质量,从而在目标模型验证的同时打包起草后续块,实现真正的异步投机解码。为控制打包带来的计算开销,D3D 按层对接受长度的影响进行渐进式剪枝,去掉 36 层中的 5 层仍保留超 99% 的平均接受长度。在七个基准上,以 Qwen3-8B 和 Qwen3-32B 为目标模型分别取得 5.00 倍和 5.71 倍平均加速,优于 DFlash;GSM8K 上以 Qwen3-32B 为目标时加速达 7.48 倍。
投机解码(Speculative Decoding)是加速大模型推理的主流技术路线之一,但其效率长期受制于一个结构性瓶颈:起草模型必须等待目标模型更新隐状态,导致起草与验证只能串行执行。复旦大学生成视觉团队提出的 D3D 试图从根本上拆掉这道依赖。
串行瓶颈:扩散起草的"隐形等待"
以目标模型条件化的扩散起草器能够并行预测一个块内的候选 token,看起来比自回归起草快得多。问题在于,每个新块的生成都要等待目标模型回传更新后的隐状态。换句话说,虽然单块内部是一次前向并行完成的,块与块之间却被强制串行——起草、验证、再起草、再验证,形成严格的流水线停顿。
这解释了为什么扩散起草在纸面上并行度很高,实际端到端加速却常常不及预期。D3D 的出发点很直接:如果起草器不再依赖目标模型的隐状态,起草和验证就可以真正重叠。
隐状态(hidden states) 指 Transformer 解码器每一层输出的高维向量表示,承载了模型对当前上下文的内部编码。在投机解码中,目标模型的一次前向会为每个位置产出隐状态,起草模型(尤其是扩散式起草器)常把它作为额外的条件信号输入,借此判断"目标模型会接受什么样的 token"。这种条件化能显著提高接受率,但代价是起草必须等目标模型算完、回传隐状态之后才能开始,从而形成文章中提到的"隐形等待"。D3D 的做法本质上是放弃这一强条件信号,改用其他监督方式补偿起草质量。
D3D 的做法:块级去噪 + 自回归辅助监督
D3D 是一个独立的扩散起草器,核心设计是把块级去噪(blockwise denoising)与辅助自回归监督(auxiliary autoregressive supervision)结合起来。前者保留扩散模型一次生成整块候选 token 的并行能力,后者则在不依赖目标模型隐状态的条件下,维持较长的高质量接受前缀。
两者结合带来的是起草质量的补偿:失去目标隐状态这一强条件信号后,自回归监督承担起维持 token 连贯性的职责,使得起草器依然能产出足够长的、被目标模型接受的候选序列。
这种独立性释放了关键能力——D3D 可以在目标模型执行验证的同时,一次性打包前向(packed pass)起草后续块,从而实现真正意义上的异步投机解码。原本串行的两个阶段被压进同一条时间线。
投机解码的接受长度(acceptance length) 指一次起草-验证循环中,目标模型连续认可的候选 token 数。验证时,目标模型并行打分起草出的整块候选,从左到右逐位比对:前缀中第一个被拒绝的位置即截断点,接受长度就是该截断点之前的 token 数。接受长度越长,每个验证步平均产出的 token 越多,端到端加速比越高;它直接由起草器与目标模型分布的对齐程度决定。因此文章反复强调"维持较长的高质量接受前缀"——这正是投机解码加速的核心杠杆,也是层剪枝时用以衡量剪枝代价的指标。
层剪枝:用接受长度换打包成本
异步打包起草并非没有代价:一次前向处理多个块会推高计算量。D3D 的应对方式是按层对接受长度的影响进行渐进式剪枝,削减打包起草的开销。
论文给出的数据颇具说服力:在以 Qwen3-8B 为目标模型的三个基准上,去掉 36 层中的 5 层,平均接受长度仍保留超过 99%。也就是说,近 14% 的层可以被移除而几乎不损失起草质量,这部分算力直接转化为速度。
扩散语言模型(diffusion LM)用作起草器 的思路与自回归起草器不同:它把一段 token 块视为带噪序列,通过多步去噪并行地一次性还原整块内容,因此单块内部的生成天然是并行的。但扩散去噪通常需要多轮迭代,且每一步的输入条件若来自目标模型,就会重新引入串行依赖。块级去噪把去噪范围限制在一个块内,使每个块的生成成为一次相对独立的并行前向,这正是 D3D 能够把多个块的起草"打包"进一次前向的前提。
实测加速:从 5 倍到 7.48 倍
跨七个基准的评测中,D3D 以 Qwen3-8B 和 Qwen3-32B 为目标模型分别取得 5.00 倍和 5.71 倍的平均解码加速;作为对比,DFlash 在相同设置下为 4.03 倍和 3.67 倍。差距在更大的目标模型上反而拉大,说明解除串行依赖的收益随模型规模上升而放大。
极端案例出现在 GSM8K 上:以 Qwen3-32B 为目标时,D3D 的加速比达到 7.48 倍。这类数学推理任务对起草质量要求较高,能达到这一数字,侧面印证了异步重叠与接受长度的协同效果。
代码已开源于 GitHub(fudan-generative-vision/D3D)。
一点观察
D3D 的价值不在于"又一个更快的投机解码变体",而在于它改变了起草器与目标模型之间的耦合关系。当起草器不再依附于目标隐状态,投机解码的调度空间被显著拓宽——打包、重叠、剪枝这些手段才真正有了用武之地。对推理基础设施而言,这类解耦思路可能比单点加速数字更值得关注。
背景补充
从更宏观的视角看,D3D 所属的"起草-验证"范式成立的根本前提是验证的并行性:目标模型一次前向即可对整块候选 token 并行打分,且通过拒绝采样等修正机制能保证输出分布与目标模型自身采样一致,不损失生成质量。这也意味着投机解码的加速上限受制于两点——起草成本要远低于目标模型单次前向,以及接受长度要足够长。D3D 的异步打包与层剪枝分别针对这两点做功:前者摊薄起草开销,后者守住接受长度。理解这一成本-收益结构,有助于判断该方案在不同模型规模与任务类型上的适用边界。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。