大模型RAG企业实战:从零搭建问答系统架构
一门以企业级RAG问答系统为主线、应用驱动的大模型工程实战课第一周全记录。
本文梳理了一门面向企业落地的RAG(检索增强生成)实战课程第一周的核心内容。课程放弃「先打基础再实战」的传统路径,从第一节课起直接围绕代码实操展开,以「打通前后端大模型问答链路」为第一周交付目标。技术栈采用FastAPI构建RESTful API,统一调度本地私有化部署的ChatGLM3-6B与在线GLM-4,只需修改model name即可无缝切换模型。课程全程强调企业级工程规范:Linux环境部署、GitLab本地版本管理、PyCharm远程开发、conda虚拟环境搭建,并以Postman验证前后端数据通路。第一周链路的核心参数为query、model name、temperature和max tokens,整体架构为接收问题→调用大模型→返回结果,为后续RAG检索链路的扩展打下基础。
RAG(检索增强生成)正成为大模型落地就业市场的两大主流方向之一。一位有八年算法从业经验、现任某大模型团队项目开发工程师的讲师,在B站推出的RAG企业项目实战课中,用「应用驱动」的方式还原了企业级问答系统的完整开发流程。本文梳理第一周课程的核心内容,看看一个真实的大模型问答系统是如何从架构设计到代码落地的。
为什么选择「应用驱动」而非基础知识先行
这门课最大的特点是放弃了传统「先补两周基础再讲开发」的授课路径。讲师直言,这种先堆砌基础再讲实战的方式「体验感明显非常不好」,因此从第一节课就全部围绕代码实操展开。
课程的组织逻辑是以「应用链路」为出发点:每一周都从需求分析切入,先规划一条完整的应用链路,再把业务流程和代码研发串联起来,最终交付一个可运行的完整系统。涉及到的基础知识(如LangChain)不会系统讲解,而是在链路开发过程中「现学现做」地穿插进去。
这种设计贴近真实工作场景。讲师提到,大模型技术迭代极快,「我们在开发过程中也是经常碰到不会的现学现做」,课程正是要还原这种工程师的真实状态——围绕一个明确的交付目标,边做边补技能。
RAG(Retrieval-Augmented Generation,检索增强生成)是一种将外部知识库检索与大语言模型生成能力结合的技术架构。其核心思路是:在模型生成回答之前,先从外部文档库或数据库中检索与问题相关的内容片段,再将这些片段作为上下文(Context)一同送入模型,从而让模型的回答更准确、更具可追溯性,并有效缓解大模型「幻觉」问题。相比于直接微调模型,RAG无需重新训练参数,知识更新只需维护外部知识库即可,因此在企业落地中成本更低、灵活性更强。典型应用场景包括企业内部知识问答、客服机器人、法律文书检索等。理解RAG的整体架构有助于把握本课程后续检索链路设计的动机。
第一周目标:打通前后端的大模型问答链路
第一周要实现的链路,本质上是一个最小可用的问答系统。用户从前端(类似ChatGPT的对话框或表单)发送参数到WebApp,通过HTTP请求转交到后端API,后端调用大模型处理后,再把推理结果响应渲染回前端。
整个链路涉及四个核心输入参数:
- query:用户提出的问题
- model name:想要调用的后端模型名称
- temperature:采样温度,影响模型输出的随机性
- max tokens:模型的最大输入限制,超出部分会被截断
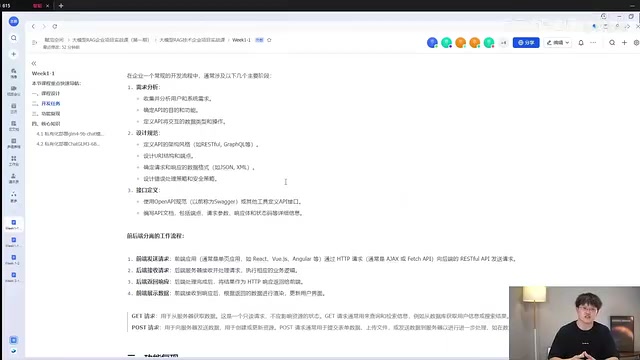
讲师强调,后端开发工程师的日常工作本质就是设计这类RESTful API接口——确定入参结构、定义功能端点、规划返回数据格式。「你把前端的需求、用户的需求分析设计好了以后,我们就可以定义好这样一个接收参数的标准。」这正是企业开发中前后端分离工作流的起点。
技术栈选型:FastAPI + 开源模型 + 在线API统一调度
课程在技术选型上有明确的企业导向。后端采用 Python 的 FastAPI 构建 RESTful API,实现前后端交互;接口测试则使用 Postman 工具,验证前后端数据通路是否正常。
一个值得关注的设计是模型调用的统一规范:系统同时集成本地私有化部署的开源模型(如ChatGLM3-6B)和在线API模型(如GLM-4),目标是「通过同样的一个函数,只要修改一下model name,就可以把后台支撑服务的模型替换掉」。这种抽象让模型切换变得极为灵活,也是企业系统应对技术快速迭代的务实做法。
前端方面,课程放弃了基于 Streamlit 的 LangChain-ChatChat 界面,改为采用基于 Vue 创建的独立前端,彻底实现前后端分离。讲师计划在约两周后开放前端仓库,重点讲解如何对接前两周做好的接口。
LangChain 是目前最主流的大模型应用开发框架,提供了一套标准化的组件抽象,包括模型接口(LLMs/ChatModels)、提示词模板(PromptTemplate)、记忆模块(Memory)、检索链(RetrievalChain)等。其最大价值在于屏蔽了不同模型供应商的接口差异——无论是 OpenAI、本地部署的 ChatGLM 还是其他开源模型,都可以通过统一的接口调用,与课程中「只改 model name 即可切换模型」的设计理念高度吻合。FastAPI 则是基于 Python 的高性能异步 Web 框架,原生支持 OpenAPI 文档自动生成和 Pydantic 数据校验,在大模型后端服务场景中被广泛采用。两者结合,构成了当前企业 RAG 系统的主流后端技术底座。
企业级工程规范:GitLab、版本迭代与Linux部署
这门课的「企业味」很大程度体现在工程规范上。讲师指出,真实企业不会把项目放在公开的GitHub上,而是搭建本地GitLab(通过IP加端口访问)。课程项目因为是教学用途才放在公网,并通过 tags 和 release 机制为每条链路构建版本,模拟真实的迭代优化过程:「第一个版本实现了什么,第二个版本基于上一个版本优化了什么、怎么优化的。」
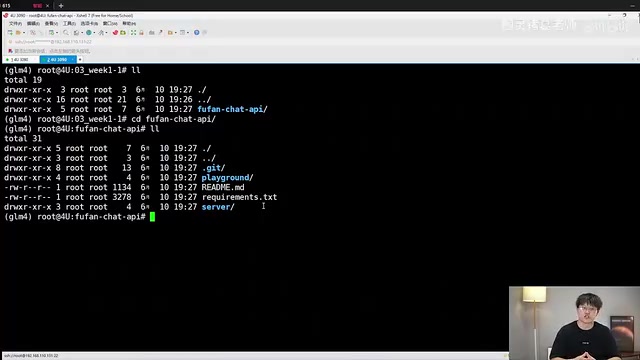
部署环境的选择同样强调工程现实。讲师明确表示:「无论是任何形式的应用,在企业中我可以非常打保票地告诉大家,不会有在Windows系统上部署的情况。」所有大模型服务都在Linux系统上部署和维护,开发者通过远程连接的方式操作服务器。课程演示的硬件是一台配备4张3090显卡的服务器。
远程开发环境的完整配置流程
讲师详细演示了用 PyCharm 远程连接 Linux 服务器的全过程:
- 通过
ifconfig查看服务器IP(示例为192.168.110.131) - 在 Tools → Deployment → Configuration 中创建 SFTP 连接
- 配置 SSH 远程主机(默认端口22)、用户名和密码
- 设置 Root Path 指向项目绝对路径(可用
pwd查看) - 通过 Tools → Start SSH Session 调出远程命令行终端
如果没有服务器,Windows 本地用户也可以直接用 git clone 拉取代码后用 PyCharm 打开,操作界面完全一致。
虚拟环境搭建与常见踩坑
环境依赖通过 conda 管理。讲师建议使用 Python 3.10 或 3.11,「不建议大家使用3.12,因为它会有很多bug」。创建流程为:
conda create --name wk1_1 python=3.10
conda activate wk1_1
pip install -r requirements.txt

安装过程中遇到的典型问题是 torch 版本不兼容报错。讲师的处理方式是先把 requirements 中的 torch 相关三个包注释掉暂时忽略,因为 torch 需要根据环境单独部署、有特定的选择标准,后续课程会专门讲解。此外还需补装 fastchat、langchain 等依赖包。
用Postman验证链路通路
服务启动后(IP:端口形式,示例为8000端口),通过 Postman 模拟前端请求验证链路。请求配置为 POST 方法,URL为 IP:端口/api/chat,其中 /api/chat 是路由中指定访问 chat 函数的端点。
请求体参数需与后端一一对应:query(用户问题)、model name(如chatglm3-6b)、temperature(如0.8)、max tokens(如4096)。点击 Send 后,后端会打印接收到的参数,并返回 lm_response 字段——也就是大模型对用户问题的回答。
整个链路的核心代码其实只有几行,本质是:接收用户问题 → 送入大模型 → 生成结果 → 返回。但为什么要这样封装,涉及两个关键知识点:如何在本地私有化部署和运行开源大模型,以及如何借助 LangChain 集成和托管本地部署的开源模型。这也是后续课程要展开的重点。
私有化部署开源大模型通常依赖 Hugging Face Transformers 库加载模型权重,并借助 FastChat 或 vLLM 等推理框架对外暴露兼容 OpenAI 格式的 API 接口。以 ChatGLM3-6B 为例,部署后会在本地启动一个 HTTP 服务,LangChain 可以通过 ChatOpenAI 类并指向本地地址来调用它,从而复用与调用在线模型完全相同的代码路径。这也解释了为何课程强调「统一函数、只改 model name」的设计——底层正是借助 FastChat 将不同模型的调用接口统一为 OpenAI 兼容格式,使得本地模型与云端 API 在 LangChain 层面无缝互换。torch 版本敏感的原因在于:不同 CUDA 驱动版本需要匹配特定的 PyTorch 编译版本,版本不对会导致 GPU 无法识别或推理崩溃,这也是环境搭建中最常见的踩坑点。
小结
从课程第一周的内容可以看出,RAG企业实战的落地远不止调用大模型API那么简单,它牵涉到接口设计、前后端分离、Linux远程开发、版本管理、环境依赖处理等一整套工程能力。对于想从算法走向工程落地的开发者来说,这种以真实交付为目标、还原企业踩坑过程的教学方式,确实比单纯堆砌理论更有参考价值。真正的难点和RAG检索路线(联网实时检索、实时推荐、高阶检索问答链路)还在后续课程,而扎实的系统架构正是这一切的基石。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。