DeepInstructor:用结构化学术经验驱动科研创意评估的智能体框架
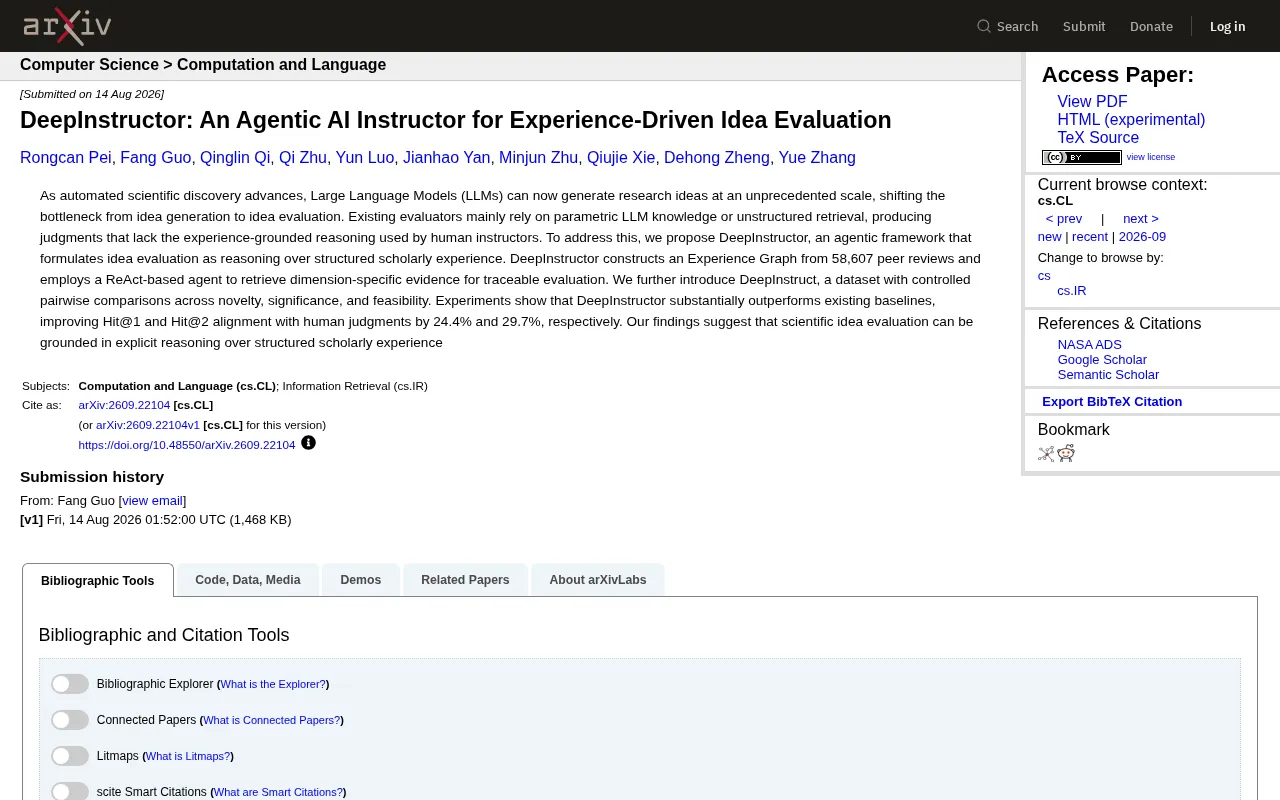
DeepInstructor 将AI科研创意评估建立在58607条同行评审经验图谱上,通过ReAct智能体实现可追溯的结构化推理,人类对齐度提升近三成。
随着大语言模型能够批量生成科研创意,研究瓶颈已从「产生想法」转向「评判想法」。DeepInstructor 针对这一转变提出了新框架:以58607条真实同行评审构建经验图谱,再借助ReAct智能体按新颖性、意义、可行性三个维度分别检索对应评审证据,将评估过程从黑箱打分变为有据可查的推理链。配套的DeepInstruct数据集采用受控成对比较设计,与人类判断的对齐方式更为稳健。实验显示,Hit@1和Hit@2与人类偏好的一致度分别提升24.4%和29.7%,验证了显式经验推理相较于模型内隐知识的优势。该框架也存在继承历史评审偏见、开放场景泛化性待验证等局限,目前仍为arXiv预印本阶段。
从生成到评估:科研创意的瓶颈正在转移
随着自动化科学发现的推进,大语言模型(LLM)已经能够以前所未有的规模批量生成研究创意。这带来了一个新问题:当创意不再稀缺,真正的瓶颈就从「产生想法」转向了「评判想法」。谁来判断这些海量创意中哪些真正具有新颖性、意义和可行性?
现有的评估方法大多依赖两条路径:一是模型自身的参数化知识(parametric knowledge),二是非结构化的检索增强。但这两种方式都存在明显短板——它们给出的判断缺乏人类导师那种「经验扎根」(experience-grounded)的推理能力。一位资深审稿人评判一篇论文时,凭借的是长期积累的领域经验和对无数相似工作的对照,而不是简单的知识回忆或文本匹配。
DeepInstructor 的核心思路:把评估变成对经验的推理
arXiv 上的这篇论文提出了 DeepInstructor,一个智能体(agentic)框架,将创意评估重新定义为「对结构化学术经验的推理过程」。它的关键创新在于不再把评估当成一次性的打分,而是当成一个可追溯、可解释的推理任务。
构建经验图谱(Experience Graph)
DeepInstructor 的基础是一张由 58,607 条同行评审构建而成的经验图谱。这一数字规模值得关注——它意味着系统并非依赖模型的隐性知识,而是把真实审稿人在实践中积累的判断显式地组织成结构化数据。这些评审意见被拆解、关联,形成可供检索的经验网络,让 AI 在评估时能够「参照前人怎么看类似问题」。
基于 ReAct 的智能体检索
在图谱之上,DeepInstructor 采用了基于 ReAct(推理与行动交替)范式的智能体。面对一个待评估的创意,智能体会针对具体维度检索对应的证据,而不是笼统地给出结论。这种「按维度取证」的设计使得每一条评判都能追溯到支撑它的经验依据,大幅提升了评估的可解释性——这恰恰是纯参数化方法最欠缺的部分。
ReAct(Reasoning and Acting)是2022年由谷歌研究团队提出的一种语言模型推理范式,其核心思想是让模型在生成推理链(Chain-of-Thought)的同时,交替执行外部工具调用或信息检索动作。与单纯的思维链提示不同,ReAct 允许模型在推理中途「暂停思考、查询外部信息、再根据结果继续推理」,形成思考-行动-观察的循环。这种设计特别适合需要多步骤验证的任务:模型不必依赖一次性的记忆召回,而是可以在推理过程中动态补充证据。在 DeepInstructor 的场景里,智能体对「新颖性」和「可行性」等维度的判断往往需要不同的参照依据,ReAct 框架使它能够针对每个子问题分别检索相关评审经验,而非用一个笼统查询覆盖所有维度,从而保证每条结论都有具体的经验来源支撑。
DeepInstruct 数据集:受控的成对比较
为了训练和验证这套框架,研究者还引入了 DeepInstruct 数据集。它的特点是提供了跨三个核心维度的受控成对比较(controlled pairwise comparisons):
- 新颖性(novelty):创意是否具有原创价值
- 意义(significance):创意的潜在影响力
- 可行性(feasibility):创意在现实中能否落地
采用成对比较而非绝对打分是个务实的选择。人类在判断「A 和 B 哪个更好」时往往比给出「A 值几分」更可靠,成对比较也更容易与人类判断对齐,为衡量模型表现提供了更稳定的基准。
成对比较(pairwise comparison)作为评估范式在机器学习领域有深厚根基,尤其在人类反馈强化学习(RLHF)流行之后被广泛采用。其优势在于规避了绝对评分的主观歧义:不同评审人对「7分」代表什么可能理解迥异,但对「A比B更新颖」往往能达成更高共识。统计上,成对比较数据可通过 Bradley-Terry 模型等方法转化为全局排序,既保留了相对偏好信息,又降低了标注噪声。这也是当前主流大模型对齐(alignment)训练普遍采用偏好数据而非评分数据的原因。DeepInstruct 数据集将这一思路引入科研创意评估,使得训练信号更贴近人类审稿人的实际决策方式——审稿人在面对多篇投稿时,本质上做的就是相对比较而非孤立打分。
实验结果:与人类判断的对齐显著提升
论文报告的实验数据显示,DeepInstructor 大幅超越了现有基线方法。在与人类判断的对齐度上:
- Hit@1 提升了 24.4%
- Hit@2 提升了 29.7%
Hit@1 和 Hit@2 衡量的是模型排序结果与人类偏好的一致程度。近三成的提升幅度表明,将评估建立在显式的结构化经验推理之上,确实比依赖模型内隐知识更贴近专家的真实判断。
意义与局限
这项工作最重要的启示在于:科研创意评估可以扎根于对结构化学术经验的显式推理,而非黑箱式的模型直觉。当自动化科研流水线越来越成熟,一个可信、可追溯的评估环节将成为整个系统的关键把关者。DeepInstructor 提供了一条把「审稿经验」资产化、可复用的路径。
不过也需要理性看待其边界。经验图谱来自历史评审,可能继承既有的评审偏见;同行评审本身对「新颖性」「意义」的判断也存在争议和噪声。此外,成对比较在受控数据集上的表现能否推广到真实、开放的创意评估场景,仍有待更多验证。作为一篇新发布的 arXiv 预印本,其结论也还需经过更广泛的复现与检验。
即便如此,DeepInstructor 指出的方向——让 AI 评估者像人类导师一样「有据可依、有例可循」——对整个自动化科学发现领域都具有参考价值。
相关推荐
B站唯一讲透Harness Engineering?企业级多Agent协同实战解析
解析Harness Engineering企业级多Agent协同的核心组件:编排层、状态管理、安全隔离与可观测性。结合B站教程素材,讨论面试官为何开始追问工程约束,以及如何理性看待“唯一讲明白”类技术内容。
AI Agent全栈实战课:从0到1掌握双框架开发
B站AI Agent全栈实战课程导学解析:四阶段覆盖基础概念、LangChain精讲、单Agent实战与CrewAI多智能体进阶,含零配置环境工具与开源代码,适合有编程基础的开发者系统入门。
手写Agents.md,让AI编程稳定性大幅提升
B站UP主通过视频编辑器和卡牌游戏两个项目对比,揭示手写Agents.md和设计文档能显著提升AI编程稳定性,解释Agents.md与技能注入机制的区别,并给出文档驱动开发的实用方法。